13 Логистическая регрессия
Вспомним обычную регрессию
В этой главе поговорим про логистическую регрессию — расширение линейной регрессии для определенного класса задач. Я постепенно подведу вас к ситуации, где обычной регрессии перестает хватать, и мы посмотрим на нюансы, которые возникают при расширении ее функционала. Но сначала вспомним, как выглядит линейная регрессия.
- Линейная регрессия позволяет предсказать значения переменной-отклика (response variable) по известным значениям объясняющих переменных (explanatory variables)
\[ Y = \beta_0 + \beta_1 X_1 + \beta_2 X_2 + \dots + \beta_p X_p + Шум \]
Переменную-отклик также называют зависимая переменная
Объясняющие переменные также называют предикторами (так принято в машинном обучении — они помогают предсказывать) или регрессорами (так принято в эконометрике)
А их сумму вместе с коэффициентами - линейным предиктором
\[ \beta_0 + \beta_1 X_1 + \beta_2 X_2 + \dots + \beta_p X_p = \textrm{Линейный предиктор} \]
Почему «линейным»? Потому что это сумма членов одной и той же формы — значение переменной, помноженное на коэффициент; в математике такую конструкцию называют линейной комбинацией. А «предиктор» — потому что значение всей этой конструкции служит нашей лучшей догадкой относительно переменной \(Y\): для конкретных значений независимых переменных линейный предиктор показывает, где в среднем будет находиться зависимая переменная. Поверх этого накладывается шум, но шум полностью случайный, и его средняя ошибка равна нулю.
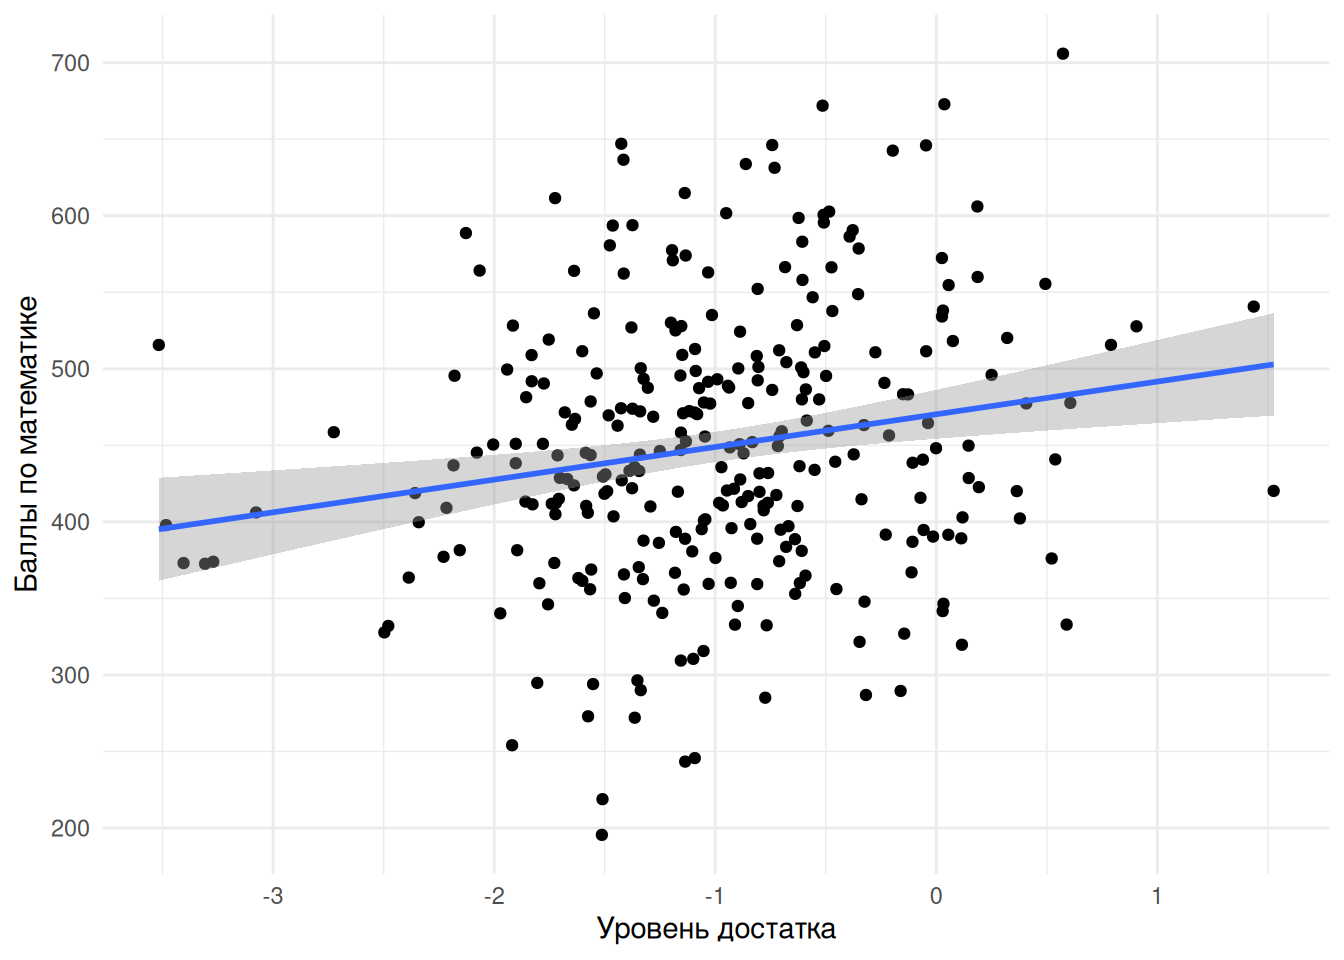
- Типичная линейная регрессия выглядит как-то так
Здесь я взял случайные 300 наблюдений из данных PISA по Казахстану и построил зависимость баллов по математике от уровня достатка семьи. Мы видим умеренно выраженную линейную зависимость: школьники из богатых семей в среднем сдают математику получше. Но виден и большой разброс вокруг систематической части: сам факт происхождения из богатой семьи ничего не гарантирует — есть наблюдения из вполне обеспеченных семей с весьма посредственными баллами.
Теперь нащупаем границы применимости линейной регрессии.
Обратите внимание, что наша переменная-отклик - непрерывная. Она может принимать очень много возможных значений. (Строго говоря, баллы не непрерывны в буквальном смысле, но возможных значений так много, что по всем техническим критериям мы относимся к ним как к непрерывной переменной.)
Но что если, переменная будет бинарной. То есть возможные значения будут только 0 и 1. Например, 1 кодирует, что некое событие произошло, а 0 — что нет.
Давайте посмотрим на график: что произойдет, если к бинарной зависимой переменной применить стандартную линейную регрессию?
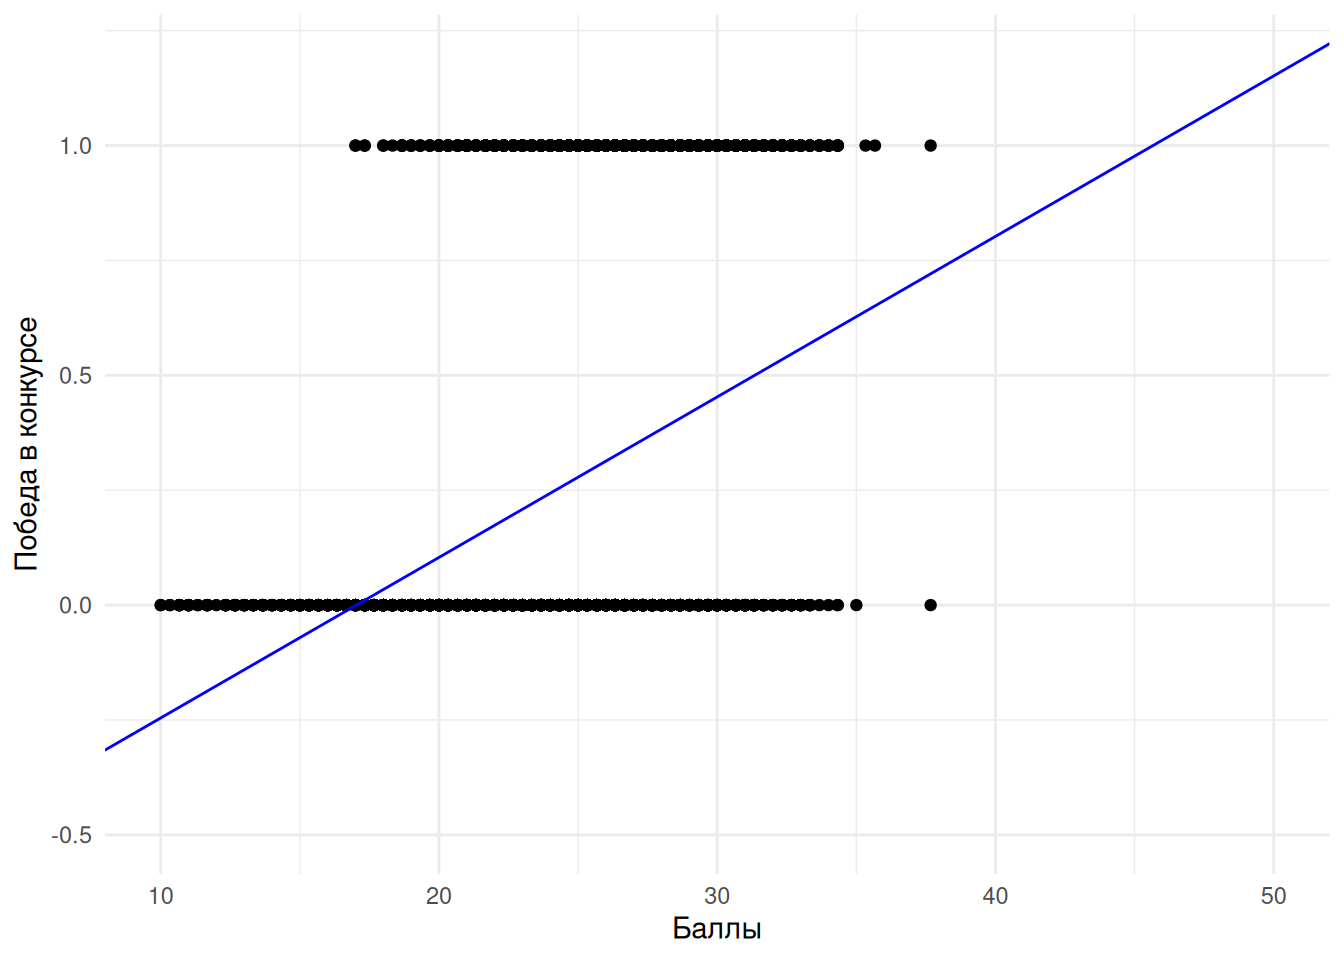
Каждая точка — отдельное наблюдение (про сам датасет расскажу чуть ниже). По оси X — баллы, которые получил проект, по оси Y — победа в конкурсе: единица — победил, ноль — нет. Поскольку интересующая нас переменная бинарна, все точки разошлись по двум уровням. Посмотрите на график и подумайте: что принципиально не так с моделью, представленной синей линией?
Модель — это уравнение: берем значение независимой переменной и получаем ожидаемое значение зависимой. Допустим, у проекта 30 баллов — модель предсказывает «победу», равную 0.4. Как интерпретировать 0.4, если переменная принимает только значения 0 и 1? Более того, для 10 баллов модель предсказывает отрицательное значение — его вообще невозможно осмыслить.
В чем проблема?
Линейная регрессия выходит за пределы возможных значений
- Например, для 10, предсказанное значение будет отрицательным
В идеале, функция с помощью которой мы предсказываем значения должна быть а) ограничена нулем и единицей и б) плавно изменяться в промежутке от нуля до единицы.
- Мы бы хотели, чтобы функция говорила нам о вероятности
Интуиция подсказывает выход: моделировать не само значение переменной, а вероятность того, что переменная примет значение 1. Число между 0 и 1 естественно читается как вероятность: 0.4 говорит, что ноль вероятнее единицы, а 0.8 — что единица вероятнее нуля. Нам нужна не прямая, а какая-то более изогнутая линия, ограниченная нулем снизу и единицей сверху и плавно изменяющаяся между ними.
- Например, она могла бы выглядеть как-то так
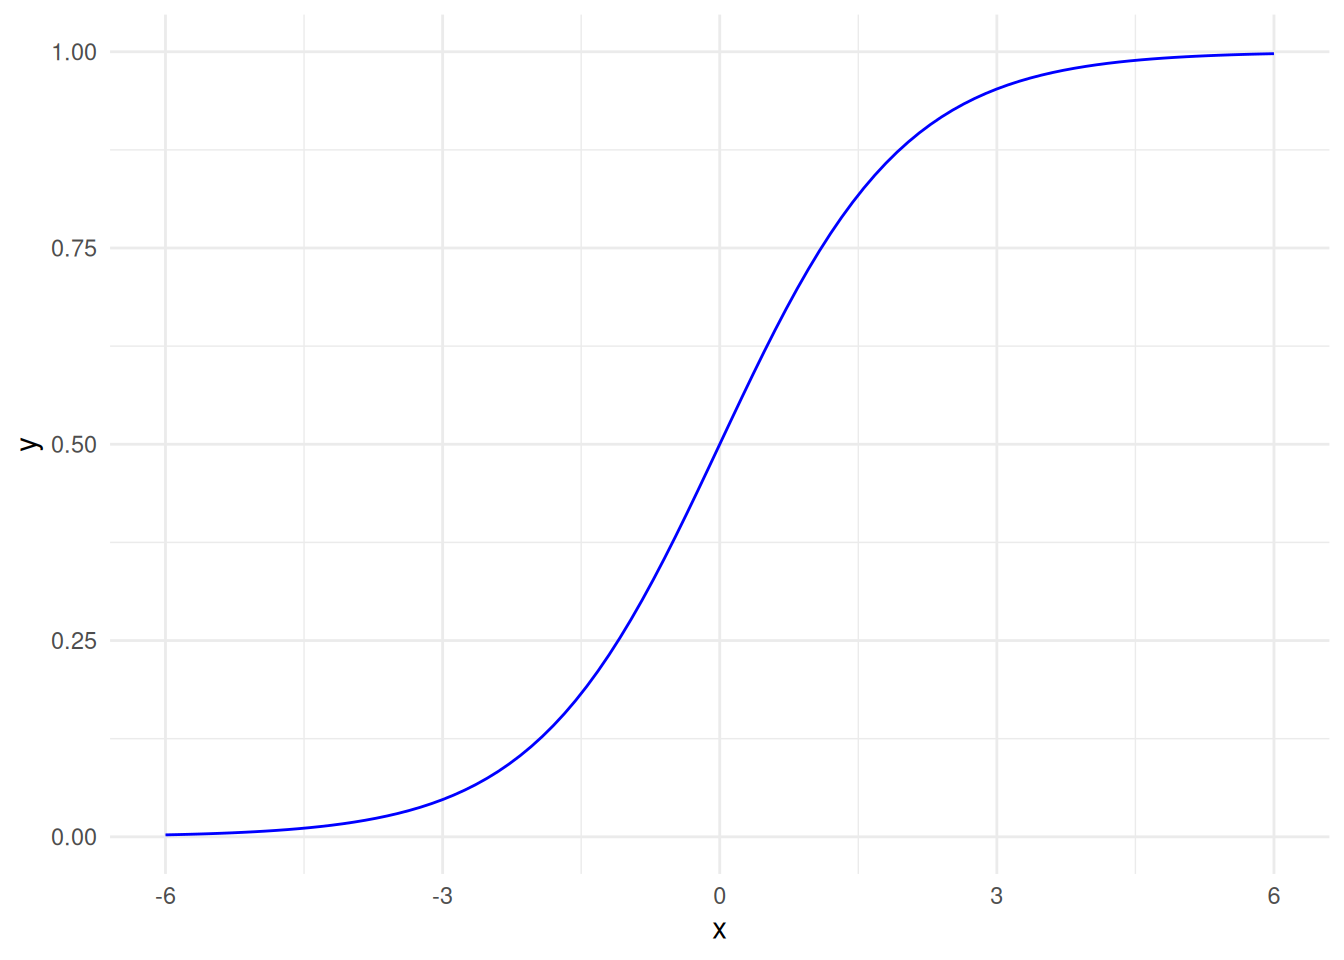
Такую S-образную кривую называют сигмоидой, а еще — по историческим причинам — логистической функцией. Идея логистической регрессии очень простая: мы моделируем не само значение зависимой переменной, а вероятность того, что произошло некое событие. Поэтому логистическая регрессия используется тогда, когда переменная отклика бинарна.
- Сравните эту плавную, изящную сигмоиду с тупой, прямой линией
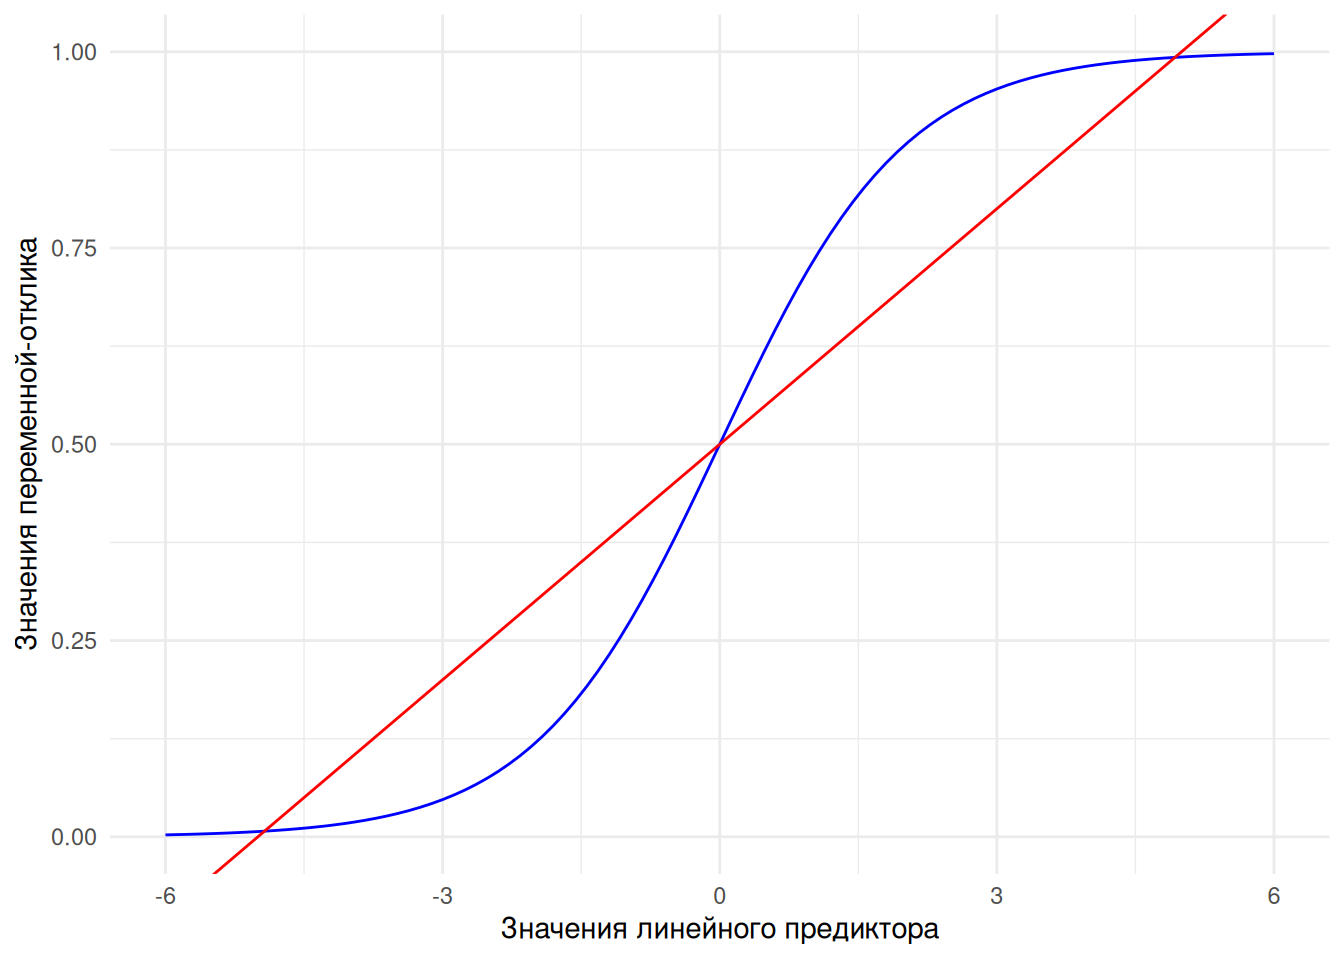
Сигмоида изящно изгибается, оставаясь между нулем и единицей, а красная прямая выходит за пределы, имеющие осмысленную интерпретацию. Именно поэтому при работе с бинарным откликом от линейной регрессии отказываются.
Данные: конкурс научных грантов
Чтобы все это выглядело ближе к реальности, возьмем конкретные данные — данные конкурса научных грантов в Казахстане, которые мы с коллегами анализируем.
- Мы будем работать с данными конкурса научных грантов в Казахстане в 2017 г.
- Было подано 4 448 заявок, из которых 1 096 (около 25%) получили финансирование на общую сумму более 9,5 млрд тенге (около 27 млн долларов)
- Это небольшие деньги: в США один только проект Национальных институтов здоровья может получить сопоставимое финансирование. Пользуясь случаем, пожалуюсь на недофинансирование науки: Казахстан тратит только около 3,5% своего ВВП на науку и образование, при среднем показателе для стран ОЭСР около 7% (Всемирный банк).
Как был устроен конкурс. Он состоял из двух этапов. Сначала объявляется прием заявок, заявки проверяются на первичные ошибки, а затем отправляются внешним рецензентам — по регламенту 2017 года как минимум двое из трех должны были быть зарубежными учеными. Эксперты выставляли баллы по нескольким критериям; каждый эксперт мог дать максимум 12 баллов, баллы трех экспертов суммировались, так что максимум для проекта — 36.
На втором этапе проекты обсуждались на заседаниях Национальных научных советов (ННС) — коллегиальных органов, которые анонимным голосованием решали, давать проекту финансирование или нет. Предполагалось, что члены ННС будут принимать во внимание баллы экспертов, но не только их: по регламенту они оценивали не только научную перспективность, но и, например, прикладную значимость проекта. Поэтому проект мог получить от экспертов 35 баллов из 36 — и не получить финансирование.
Переменные в данных: win — победил ли проект (0/1), score — сумма баллов экспертов, направление конкурса, побеждал ли руководитель в конкурсе 2014 года, а также характеристики руководителя проекта: индексы цитируемости (Скопус, индекс Хирша), пол, членство в ННС, регион, ученая степень.
| win | score | domain | win_2014 | rints | scopus | hirsh | fake | sex | member | region | degree |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 1 | 35.67 | science | 1 | 0 | 1 | 9 | 0 | 1 | no | алматы | 3 |
| 0 | 35.00 | science | 0 | 0 | 1 | 13 | 0 | 1 | no | алматы | 3 |
| 0 | 34.33 | science | 1 | 0 | 1 | 3 | 0 | 1 | no | алматы | 1 |
Логистическая регрессия
Коротко напоминаю: в линейной регрессии модель имеет такую форму — зависимая переменная с одной стороны, линейный предиктор плюс шум с другой. Шум берется из нормального распределения, центрирован на нуле, и его дисперсия фиксирована.
- Когда мы работали с линейной регрессией, переменная отклика была просто числом
\[\begin{align*} Y = \beta_0 + \beta_1X_1 + \dots + \beta_nX_n + \epsilon \\ \epsilon \sim N(0, \sigma^2), Y \in R \end{align*}\]
Во многих случаях, однако, переменная отклика является бинарной, то есть она принимает только два значения \(0\) или \(1\)
\[Y \in \{0, 1\}\]
Например, есть ли у вас машина (1) или нет (0)
Логистическая регрессия (Logistic regression) - это расширение линейной регрессии для бинарного отклика
Логистическая регрессия моделирует вероятность события (например, что ваша переменная отклика примет значение \(1\))
\[\begin{align*} P(Y = 1) = p \\ P(Y = 0) = (1-p) \end{align*}\]
- В частности, логистическая регрессия моделирует вероятность события как функцию линейного предиктора (\(\sum\beta X\))
\[ p = f(\beta_0 + \beta_1X_1 + \dots + \beta_nX_n) \]
Обратите внимание на значок функции \(f\): линейный предиктор не переходит в вероятность напрямую, а проходит через трансформацию, которая обеспечивает соблюдение базовых разумных условий — как минимум, что значения не выйдут за пределы нуля и единицы. Функцию, которая связывает линейный предиктор с зависимой переменной, называют функцией связи (the link function).
- Собственно, функция которая связывает линейный предиктор и вероятность отклика выглядит так
\[ p = \frac{e^{\beta_0 + \beta_1X_1 + \dots + \beta_nX_n}}{1 + e^{\beta_0 + \beta_1X_1 + \dots + \beta_nX_n}} \]
Присмотритесь к этой функции. Во-первых, экспонента не может быть отрицательной, поэтому и числитель, и знаменатель всегда положительны — все отношение всегда больше нуля. Во-вторых, числитель и знаменатель содержат одну и ту же экспоненту, но в знаменателе к ней добавлена единица: знаменатель всегда чуть больше числителя, значит, отношение никогда не превысит единицу. Именно так мы выполняем оба условия, которые хотели наложить.
- А соответственно вероятность “неудачи”
\[ (1-p) = 1 - \frac{e^{\beta_0 + \dots + \beta_nX_n}}{1 + e^{\beta_0 + \dots + \beta_nX_n}} = \frac{1}{1 + e^{\beta_0 + \dots + \beta_nX_n}} \]
- Зачем нам все это? Идея такая: если мы возьмем отношение вероятности успеха (\(p\)) к неудаче (\(1-p\)), окажется, что знаменатель “уйдет” и все превратится в красивую экспоненту
\[ \frac{p}{1-p} = e^{\beta_0 + \beta_1X_1 + \dots \beta_{n}X_n} \]
- А если мы возьмем логарифм этого отношения, все вообще станет прекрасно
\[ log(\frac{p}{1-p}) = \beta_{0} + \beta_{1}X_1 + \dots + \beta_{n}X_n \]
- Что тут “прекрасно”? Справа у нас абсолютно голый линейный предиктор. Некий набор переменных помноженных на параметры. Эти параметры собственно нам и нужны, потому что они показывают “связь” между ИКСами (объясняющими переменными) и ИГРЕКом (переменной отклика)
Вспомните, как мы работали с линейной регрессией: самой важной частью результатов были коэффициенты — мы смотрели на таблицу и говорили «коэффициент положительный и значимый, значит…». Аналогично здесь: если мы знаем, как линейный предиктор связан с зависимой переменной (а ей у нас, по сути, стала вероятность успеха), мы можем сказать, как будет меняться вероятность события, когда какая-то независимая переменная изменяется на одну единицу.
- Возможно, вы чувствуете себя как-то так
(Этот мем — вырезка из старого советского учебника по математике: «предположим, что…», а дальше «в самом деле» — и начинается марсианская хроника. «Действительно, как же я сам не догадался». Поверьте пока на слово: все, что мы сейчас проделали, пригодится для интерпретации.)
- Но давайте выпишем то, что у нас есть, и дадим вещам имена
\[\begin{align*} logit(p) &= log(\frac{p}{1-p}) = \beta_0 + \beta_1X_1 + \dots + \beta_nX_n \\ \textrm{где} \\ \frac{p}{1-p} &= e^{\beta_0 + \beta_1X_1 + \dots + \beta_nX_n} = Шансы \end{align*}\]
- И поговорим за вот эту штуку \(\frac{p}{1-p}\)
Шансы (Odds)
- Отношение \(\frac{p}{1-p}\) называется Шансы (odds)
- Шансы показывают, насколько вероятность того, что событие произойдет, больше/меньше, чем вероятность того, что событие не произойдет.
ЗаметкаШансы
Шансы = \(\frac{P(\textrm{событие произойдет})}{P(\textrm{событие НЕ произойдет})}\)
Если вы когда-нибудь сталкивались со ставками на спорт, вы понимаете, о чем речь: «шансы два к одному» — это оно и есть. Шансы — это что-то, что пропорционально вероятности, но не совсем ей является. Шансы и вероятность — просто два разных способа закодировать одну и ту же информацию: зная одно, вы автоматически знаете другое.
Зная шансы, легко рассчитать вероятность события и наоборот:
- Допустим шансы закончить лекцию вовремя равны 2 к 1. Значит вероятность примерно равна \(66\%\)
\[ Шансы = \frac{p}{1-p} = 2 \],
\[ p = \frac{Шансы}{1 + Шансы} = \frac{2}{3} \approx 0.66 \]
Или допустим, вероятность какого-то события равна 50%, шансы будут 1 к 1.
\[ Шансы = \frac{p}{1-p} = \frac{0.5}{0.5} = 1 \]
- Так вот, Логистическая регрессия моделирует как меняется логарифм шансов при изменении линейного предиктора
- ну то есть если у вас объясняющая переменная меняет значение, как это влияет на логарифм шансов
Связь между вероятностью и линейным предиктором получается не прямая, а трехступенчатая: коэффициенты показывают, как меняется логарифм шансов; зная логарифм шансов, мы можем посчитать сами шансы (взяв экспоненту); а зная шансы — посчитать вероятность. А это, собственно, то, ради чего мы начинали всю эту одиссею.
Заметка
Логарифм шансов принято называть логитом (вероятно от “logarithm + unit”), отсюда название регрессии - логистическая. С логистикой это, к сожалению (или к счастью), никак не связано.
Подгонка логистической регрессии с помощью функции glm()
Теория, может быть, понятна не полностью, но лучший способ ее облечь в плоть — посмотреть на результаты конкретной логистической регрессии и попытаться их интерпретировать.
- Для подгонки логистической регрессии мы используем функцию
glm(). Синтаксис очень похож на синтаксис функцииlm(): необходимо указать аргументы формулы и данных - Помимо этого, необходимо указать дополнительный аргумент
family = "binomial". Так R поймет, что вы моделируете бинарный отклик
Я моделирую победу (win) как функцию двух переменных: баллов проекта (score) и пола руководителя (sex). Обратите внимание: я явно назначил мужчин базовой категорией (fct_relevel("male")), поэтому коэффициент будет оценен для женщин.
- Посмотрим на результат
| (1) | |
|---|---|
| (Intercept) | -7.122 |
| (0.277) | |
| score | 0.243 |
| (0.010) | |
| sexfemale | -0.319 |
| (0.077) | |
| Num.Obs. | 4488 |
| AIC | 4236.5 |
| BIC | 4255.8 |
| Log.Lik. | -2115.263 |
| RMSE | 0.39 |
Выглядит очень похоже на результат lm(): первое число — оценка коэффициента, в скобках — стандартная ошибка. К этому моменту вы уже привыкли: если отношение оценки к стандартной ошибке в абсолютном значении больше трех, коэффициент почти наверняка не равен нулю, и его можно принимать в работу.
- Посмотрим на коэффициенты:
- \(\beta_0\) = -7.1215278
- \(\beta_1\) = 0.2430623
- \(\beta_2\) = -0.3189446
- Как мы можем их интерпретировать? Давайте вспомним формулу. Представьте, что у нас есть два проекта, набравших по \(30\) баллов: один возглавляет мужчина (\(X_2 = 0\), базовая категория), другой — женщина (\(X_2 = 1\)). Каковы шансы каждого получить финансирование?
\[\begin{align*} P(Y = 1|X_1 = 30, X_2 = 0) = p_1 \\ P(Y = 1|X_1 = 30, X_2 = 1) = p_2 \\ Odds_1 = \frac{p_1}{1-p_1} = e^{\beta_0 + \beta_1*30 + \beta_2*0} \\ Odds_2 = \frac{p_2}{1-p_2} = e^{\beta_0 + \beta_1*30 + \beta_2*1} \\ \frac{Odds_2}{Odds_1} = \frac{e^{\beta_0 + \beta_1*30 + \beta_2}}{e^{\beta_0 + \beta_1*30}} = e^{\beta_2} \\ e^{\beta_2} = \frac{Odds_2}{Odds_1} \\ \beta_2 = log(\frac{Odds_2}{Odds_1}) \end{align*}\]
Смотрите: две экспоненты отличаются всего одним слагаемым, \(\beta_2\). Все остальное взаимоуничтожается, и остается экспонента в степени \(\beta_2\). То есть коэффициент — это логарифм отношения шансов двух групп.
Заметка
Коэффициент линейной регрессии показывает насколько изменяется зависимая переменная (Y) при увеличении объясняющей переменной на 1 единицу.
Сравните,
Заметка
Коэффициент логистической регрессии показывает насколько изменяется логарифм шансов события при увеличении объясняющей переменной на 1 единицу
Теперь дожмем. Коэффициент для женщин равен примерно \(-0.319\). Возведем его в экспоненту: \(e^{-0.319} \approx 0.727\). Интерпретация: при прочих равных шансы проекта, возглавляемого женщиной, составляют около 73% от шансов проекта, возглавляемого мужчиной. Когда коэффициент после экспоненциации меньше единицы, значит, переход переменной от 0 к 1 уменьшает шансы.
А что было бы, если бы мы поменяли базовую категорию местами — сделали базовой женщину? Значение коэффициента осталось бы тем же по модулю, но сменило бы знак: \(+0.319\), а после экспоненциации \(e^{0.319} \approx 1.376 = 1/0.727\). Интерпретация зеркальная, и, честно говоря, ее проще произносить:
- Согласно модели, проект с 30-ю баллами возглавляемый мужчиной имеет примерно в \(1.38\) раза (то есть на 38%) больше шансов выиграть грант, чем 30-балльный проект возглавляемый женщиной.
- Внимательно: не в \(1.38\) раз больше вероятность, а в \(1.38\) раза больше шансы!!!
Выбор того, что кодировать нулем, а что единицей, ни на что по сути не влияет — просто когда шансы растут (коэффициент больше единицы после экспоненциации), это интерпретировать чуть легче, чем когда они падают. По умолчанию, кстати, R сам выбирает базовую категорию — ту, что идет первой по алфавиту.
- В R есть много средств для быстрого “перевода” коэффициентов в более понятные числа: например,
broom::tidy()с аргументомexponentiate = TRUEсразу выдает отношения шансов
| term | estimate | std.error | statistic | p.value |
|---|---|---|---|---|
| (Intercept) | 0.0008075 | 0.2769605 | -25.713154 | 0.00e+00 |
| score | 1.2751480 | 0.0104002 | 23.370858 | 0.00e+00 |
| sexfemale | 0.7269159 | 0.0771784 | -4.132563 | 3.59e-05 |
Здесь же видно и коэффициент при баллах: за каждый дополнительный балл шансы выиграть растут примерно на 27%.
- А теперь немного кода, чтобы показать откуда берутся эти коэффициенты
[1] 0.8619103[1] 1.185708[1] 0.4629172[1] 0.5424824[1] 1.375675 (Intercept) score sexfemale
0.0008075321 1.2751480317 0.7269158503 - Теперь давайте попробуем понять, как переменная
scoreвлияет на шансы получить финансирование. Сравним два проекта, оба во главе с женщинами, но один набрал 25 баллов, а другой 30
[1] 0.2036047[1] 0.4629172[1] 3.371344 score
3.371344 Вероятность победы проекта с 25 баллами — около 20%, проекта с 30 баллами — около 46%. Прирост в шансах и прирост в вероятности идут в одном направлении, но это не идентичные вещи: коэффициенты логистической регрессии дают прирост в шансах, а для перехода к вероятностям нужно сначала посчитать шансы, а потом воспользоваться простой формулой. И обратите внимание на отношение шансов двух проектов: 3.37 — это ровно то число, которое получится, если коэффициент при баллах умножить на 5 (разница в баллах) и проэкспоненцировать.
Ключевая идея, которую стоит довести до автоматизма: подгоняем логистическую регрессию, берем коэффициенты, возводим в экспоненту — и получаем, во сколько раз изменяются шансы, когда соответствующая переменная меняется на единицу.
Выбор модели
Логистических моделей можно подогнать почти сколько угодно — мы ограничены только количеством переменных. Возникает стандартная проблема: как понять, какая модель справляется лучше?
В линейной регрессии мы оценивали качество модели по объему объясненной дисперсии. С логистической моделью ситуация усложняется: у нас нет остатков в привычном смысле — переменная бинарная, и мы либо ошибаемся, либо нет. Поэтому для сравнения моделей придуман другой критерий — о нем чуть ниже.
Подгоню две модели. Первая моделирует победу как функцию баллов и пола руководителя. Вторая добавляет переменную member — членство в ННС. Немного контекста: часть руководителей, подававшихся на финансирование, сами были членами Национальных научных советов — тех самых органов, которые принимали решения. Возникала довольно абсурдная ситуация, в которой податели решали, достойны ли они гранта. Организаторы осознавали конфликт интересов: когда ННС рассматривал заявку своего члена, тот удалялся из аудитории на время обсуждения и голосования. Понятно, что это решало проблему лишь частично. Одна из главных гипотез нашей работы — насколько шансы членов ННС выиграть грант выше, чем у всех остальных. Для масштаба: из ~4.5 тысяч подателей членами ННС были лишь несколько десятков человек.
- Посмотрим на результаты
| модель1 | модель2 | |
|---|---|---|
| (Intercept) | -7.440 (0.278)*** | -7.634 (0.285)*** |
| score | 0.243 (0.010)*** | 0.249 (0.011)*** |
| sex | 0.319 (0.077)*** | 0.286 (0.078)*** |
| memberyes | 2.850 (0.313)*** | |
| Num.Obs. | 4488 | 4488 |
| AIC | 4236.5 | 4131.8 |
| BIC | 4255.8 | 4157.4 |
| Log.Lik. | -2115.263 | -2061.887 |
| F | 283.092 | 202.336 |
| RMSE | 0.39 | 0.39 |
Все коэффициенты значимы. Оценка для баллов при добавлении новой переменной почти не изменилась, а вот оценка для пола уменьшилась. Как это проинтерпретировать? Члены ННС — преимущественно мужчины. После того как мы начали контролировать членство в ННС, обнаружилось, что часть гендерного разрыва связана не с полом напрямую, а с тем, что люди в привилегированной позиции ННС чаще мужчины.
Что можно сказать про сам коэффициент членства? Он значим и положителен: членство в ННС повышает шансы победить. Насколько? Вспоминаем правило: возводим коэффициент в экспоненту. \(e^{2.85} \approx 17.3\) — шансы члена ННС выиграть примерно в 17 раз выше, чем у обычного подателя.
ЗаметкаЗначимость и сила эффекта — разные вещи
Если один предиктор очень сильный, нужно ли игнорировать остальные, слабые? Нет. Значимость — это проверка против нулевой гипотезы, что эффекта нет вообще: значимый предиктор может вносить маленький вклад, но вы точно знаете, что этот вклад не нулевой. Скажем, 30-минутная ежедневная прогулка может снижать риск инфаркта всего на полпроцента — но в этих полпроцентах вы очень уверены. Сила эффекта — про масштаб, значимость — про уверенность, что эффект не равен нулю.
Опять же, как решить какая модель лучше? Присмотритесь к выводу
modelsummaryи вы увидите некий AIC. Что это такое?AIC - это аббревиатура для информационного критерия Акаике1. Это статистический показатель, который показывает “правдоподобность” модели.
AIC пытается найти баланс между “простотой” модели и ее “согласованностью” с данными.
Простота измеряется как число параметров (т.е. коэффициентов), чем меньше параметров тем проще. Считается, что хорошие модели должны быть простыми: если две модели одинаково правдоподобны, предпочтительнее более простая.
“Согласованность” - как правдоподобие (likelihood), т.е. вероятность наблюдать данные как у нас при условии, что модель (т.е. значения параметров) верны.
AIC вычисляется так:
\[AIC = -2 * log(L) + 2 * k\]
где \(L\) - максимальное значение функции правдоподобия модели, а \(k\) - количество параметров.
Интерпретация: чем меньше AIC, тем лучше модель. AIC может использоваться для сравнения нескольких моделей.
Заметка
Чем меньше AIC тем лучше модель!
В нашей таблице AIC второй модели меньше (4131 против 4236). Но сами числа мало о чем говорят — у них нет абсолютной интерпретации. Нам интересно, достаточно ли велика эта разница, чтобы убедить нас, что вторая модель лучше, — или ее можно списать на случайность, пришедшую вместе с выборкой?
Вы, наверное, уже догадываетесь, к чему я подвожу. Как и объясненная дисперсия в линейной регрессии, эта характеристика — случайная переменная с известным распределением (хи-квадрат): разница правдоподобий двух вложенных моделей распределена по закону хи-квадрат.
То есть вы можете сравнить две модели и понять дает ли вам более сложная модель “значительное” улучшение
- Если да, то значит более сложная модель лучше
Гипотезы здесь устроены знакомым образом. Нулевая: между моделями нет разницы, они объясняют данные одинаково — тогда наблюдаемая разница должна быть случайной. Альтернативная: разница есть, и модель с меньшим AIC лучше. Зная распределение, считаем вероятность:
| Resid. Df | Resid. Dev | Df | Deviance | Pr(>Chi) |
|---|---|---|---|---|
| 4485 | 4230.527 | NA | NA | NA |
| 4484 | 4123.774 | 1 | 106.7525 | 0 |
Смотрим, как обычно, на крайний правый столбец: вероятность наблюдать такую разницу между моделями при условии, что они идентичны, эффективно равна нулю. Отвергаем нулевую гипотезу: модели разные, и модель с меньшим AIC — вторая, с членством в ННС, — справляется лучше.
Принцип максимального правдоподобия
Немного о технической части — она помогает понять, откуда берутся оценки.
В линейной регрессии для оценки параметров мы использовали Метод Наименьших Квадратов (Ordinary Least Squares, или OLS regression)
- Мы брали квадраты остатков, и находили параметры, которые минимизировали их сумму.
В логистической регрессии такой подход не работает: зависимая переменная принимает лишь два значения, и «остатки» вырождаются. Поэтому используют другой метод - принцип максимального правдоподобия. Мы выбираем те значения параметров, которые делают наши данные наиболее вероятными (максимум правдоподобия)
\[ argmax_{\beta}(P(Data|Model)) \]
Другими словами, мы максимизируем вероятность наблюдаемых данных: перебираем возможные значения коэффициентов \(\beta_0, \beta_1, \dots\) и находим ту комбинацию, при которой наблюдаемые данные выглядят наиболее правдоподобными. Простой пример: вы подбросили монетку 10 раз. 7 раз выпала решка. Оцените, с точки зрения максимального правдоподобия, вероятность решки.
Если вы помните, вероятность выпадения 7 решек можно посчитать с помощью биномиального распределения.
\[ \textrm{ Вероятность 7 решек } = C_{10}^{7} p^7(1-p)^3 \]
Идея в том, что вы выбираете такие значения, которые максимизируют правдоподобие модели.
- То есть у вас есть много возможных значений для \(p\) - и вы выбираете то, которое делает вероятность наблюдать 7 решек максимальной
Предсказанные вероятности
Давайте практиковаться. Посмотрим на наши данные — вот, собственно, членство в ННС:
| member | n |
|---|---|
| no | 4411 |
| yes | 77 |
- Создадим синтетические данные, чтобы понять какие значения предсказывает модель: варьируем баллы от 0 до 36 и пол, а членство пока фиксируем на «нет»
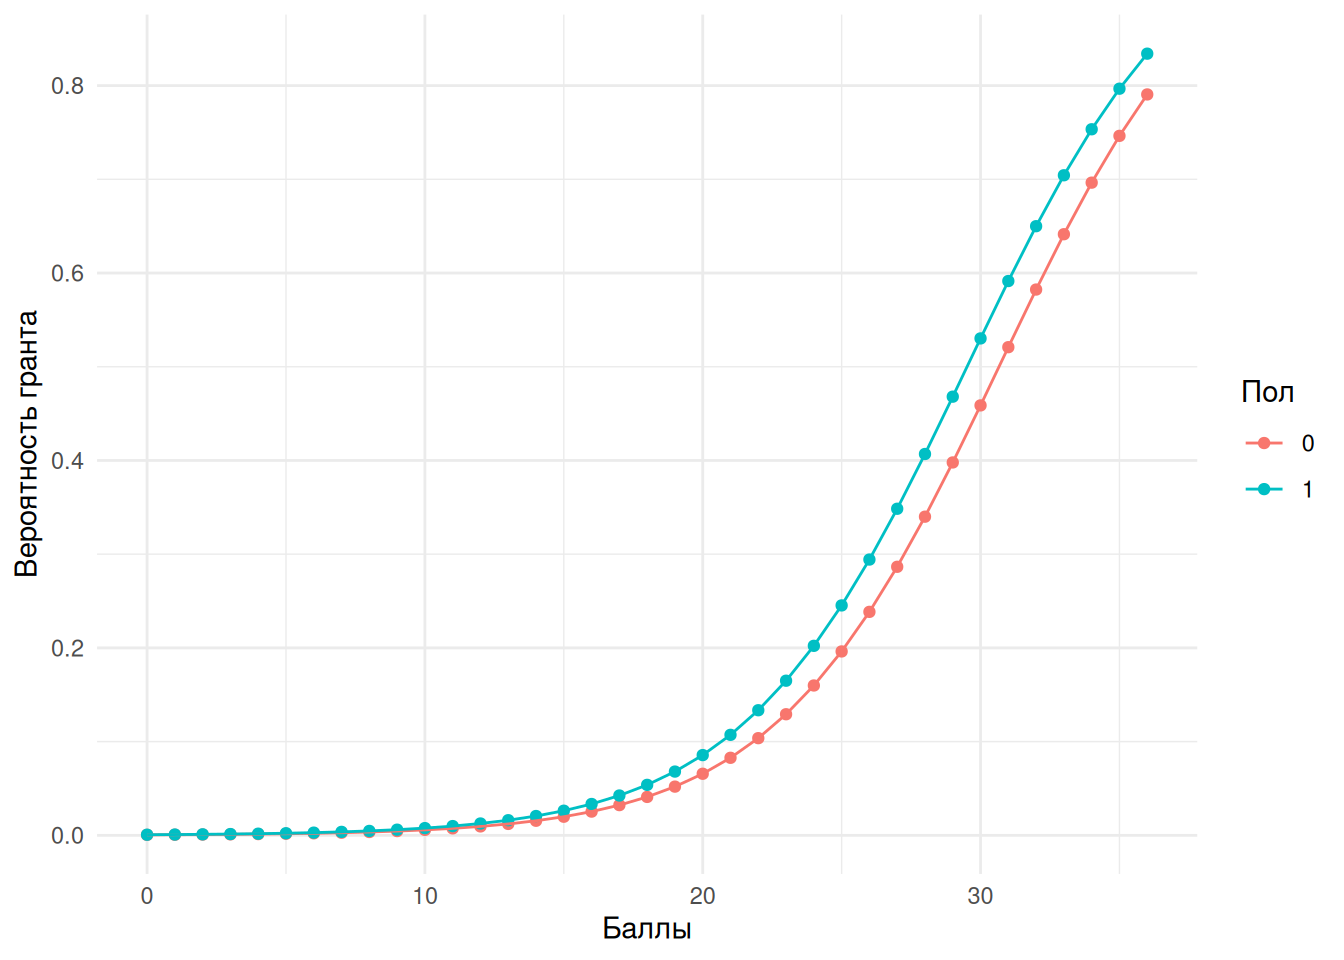
Вероятность победы, естественно, растет с баллами, и для мужчин она всегда немного выше. Но обратите внимание: размер разницы между полами варьируется в зависимости от баллов. При 10 баллах разница практически мизерная, а своего максимума она достигает в средних диапазонах. Это важный момент: поскольку связь нелинейная, идентичный прирост в шансах по-разному транслируется в вероятность — прирост шансов при сравнении мужчин и женщин всегда фиксированный, а прирост вероятности зависит от базовой вероятности. Отчасти поэтому в логистической регрессии удобнее работать с шансами: у них точное соответствие с линейным предиктором один в один.
- Посмотрим теперь, как меняется вероятность гранта для членов и не-членов ННС
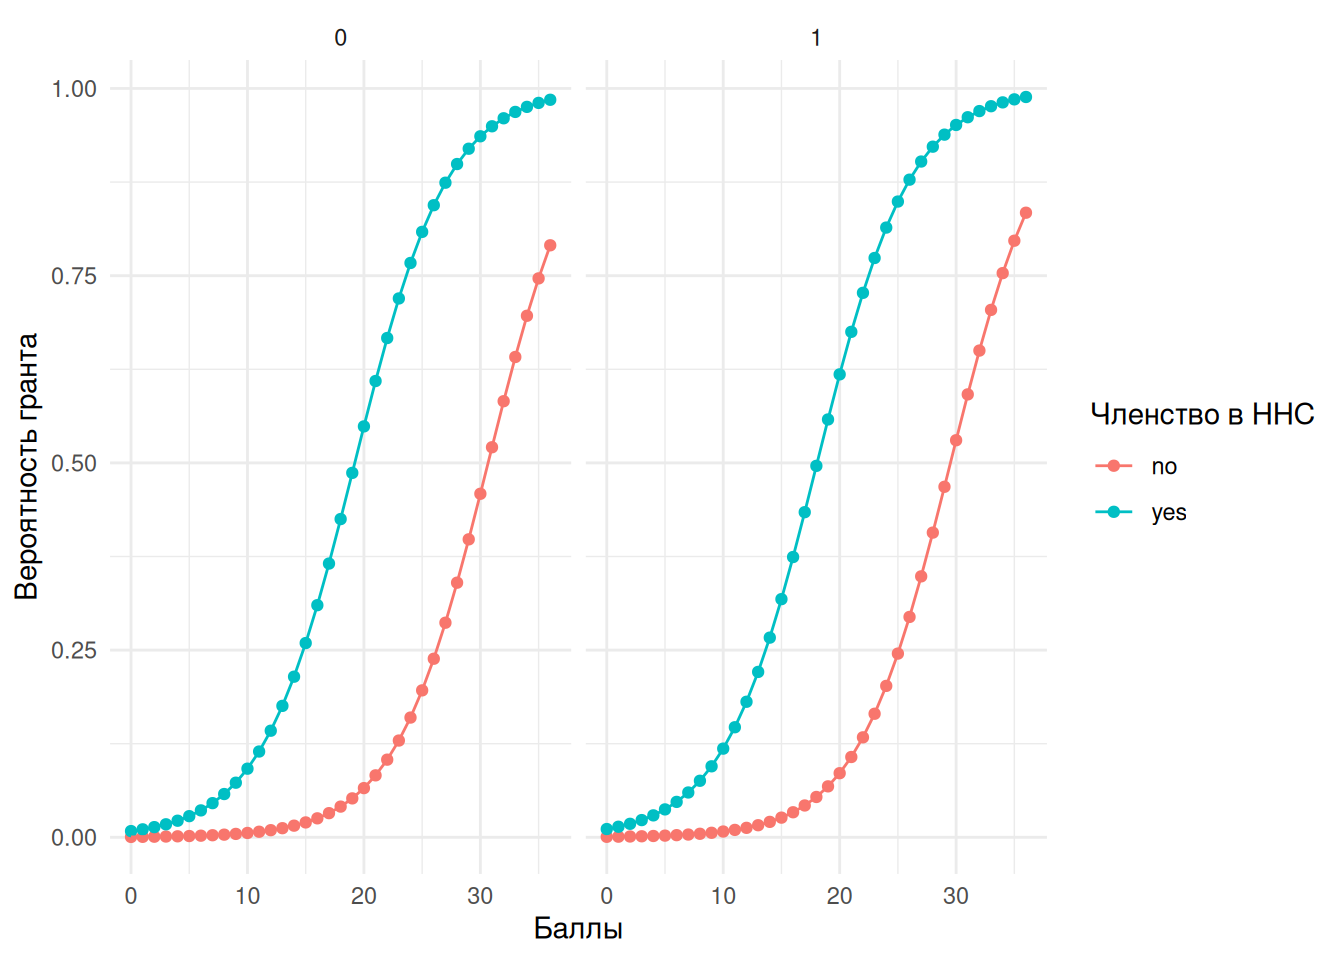
Первая панель — женщины, вторая — мужчины; панели почти одинаковы. Но внутри каждой — огромная разница между членами ННС и остальными. Например, проект женщины с 20 баллами имеет вероятность победы чуть меньше 10%, если она не член ННС, — и больше 50%, если член. То, что мы видели в таблице коэффициентов, здесь переведено в визуально понятный формат: членство в ННС очень сильно помогает выигрывать гранты даже при равных баллах.
Еще больше результатов
В конкурсе было семь возможных “направлений” по которым подавались проекты
- Условно мы их обозвали “Безопасность”, “Наука”, “Недропользование”, “Культура”, “Науки о жизни”, “Энергетика” и “Сельское хозяйство”. Направления определялись очень широко: в одном направлении могли соседствовать абстрактная фундаментальная математика и прикладная геофизика.
Ниже процент победивших проектов в зависимости от пола руководителя (слева) и предсказанные вероятности победы вместе с доверительными интервалами (справа)
Практически везде у руководителей-мужчин вероятность победы значительно выше чем у женщин.
- Единственное исключение - Безопасность. Но там в целом было мало проектов.
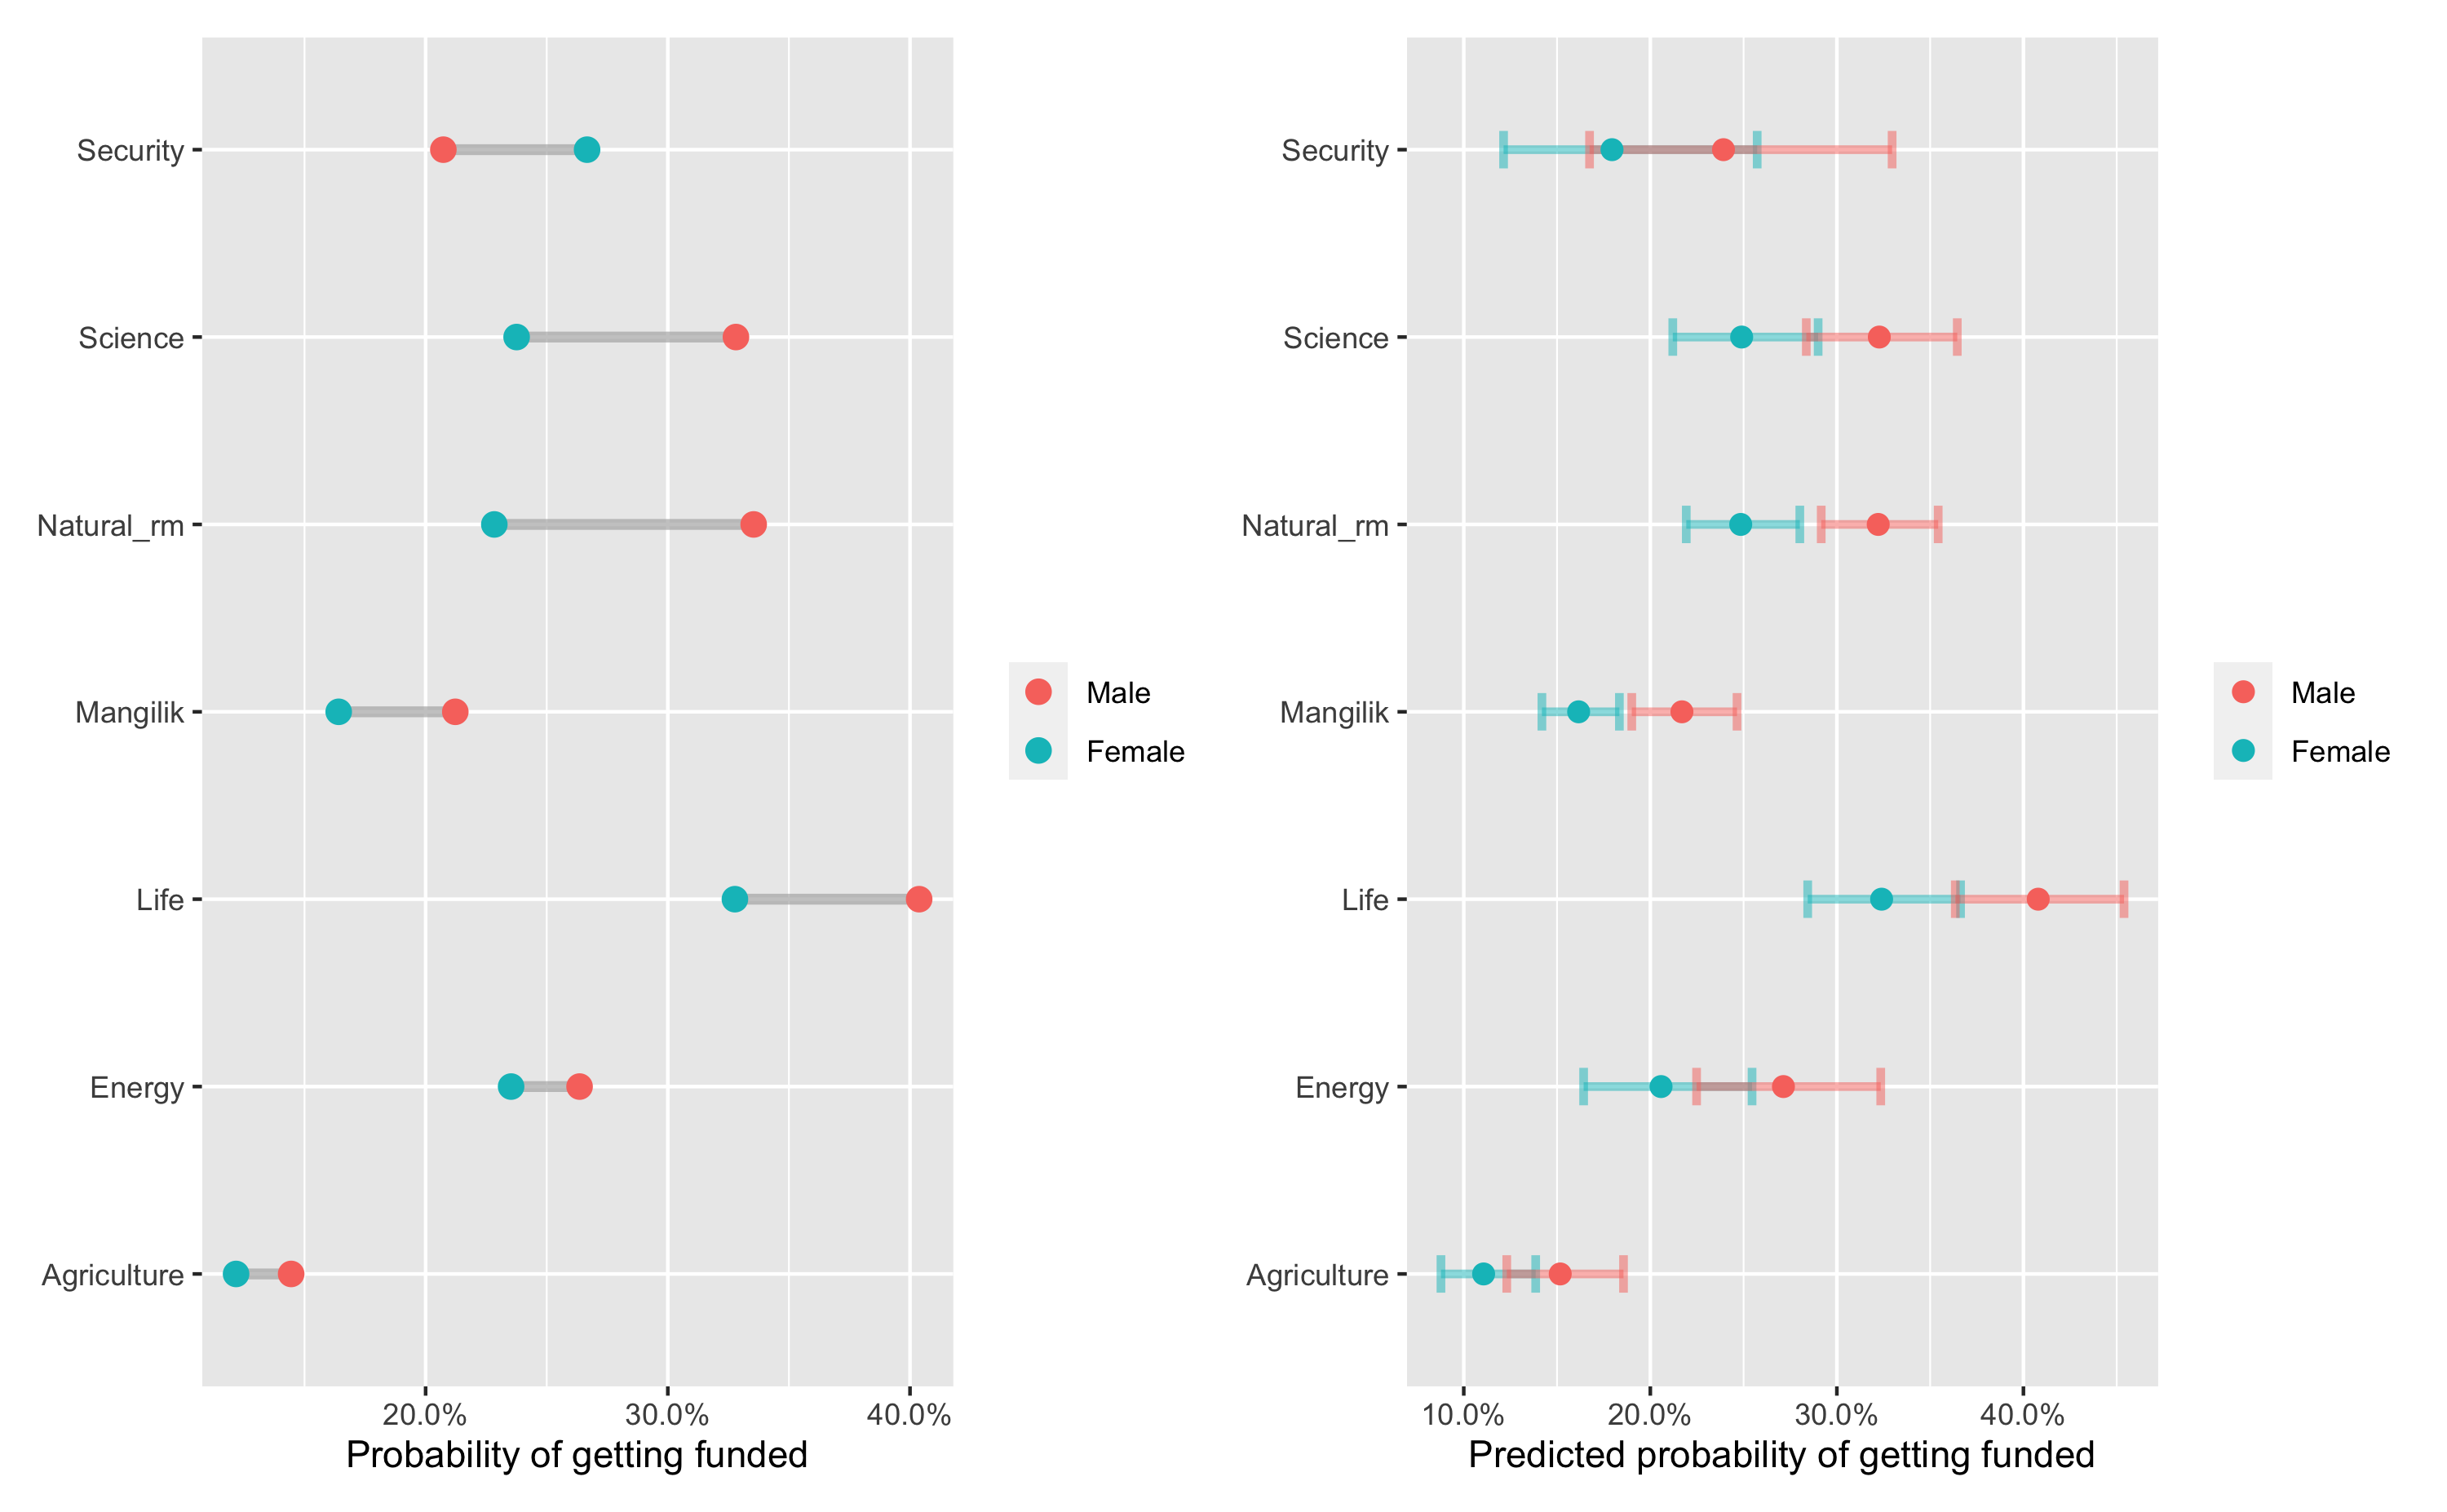
Слева — «наивные» пропорции: например, в направлении «Наука» победило около 24% проектов с руководителями-женщинами и около 34% — с мужчинами. Справа — оценки вероятностей с точки зрения модели; они всегда будут немного отличаться от наивных пропорций, но зато у модельных оценок есть погрешность, из которой можно построить доверительные интервалы. Там, где интервалы для мужчин и женщин не пересекаются или пересекаются слабо, мы можем быть уверены, что перед нами систематическая разница — я называю ее систематическим сексизмом, и направлена она практически всегда против женщин. Сама разница в оценках может показаться не очень большой (25% против 33% в «Науке»), но она статистически значима: вероятность того, что на самом деле разницы нет, очень мала. Пожалуй, только в сельском хозяйстве и энергетике интервалы пересекаются настолько, что о дискриминации уверенно говорить нельзя.
Модели в целом
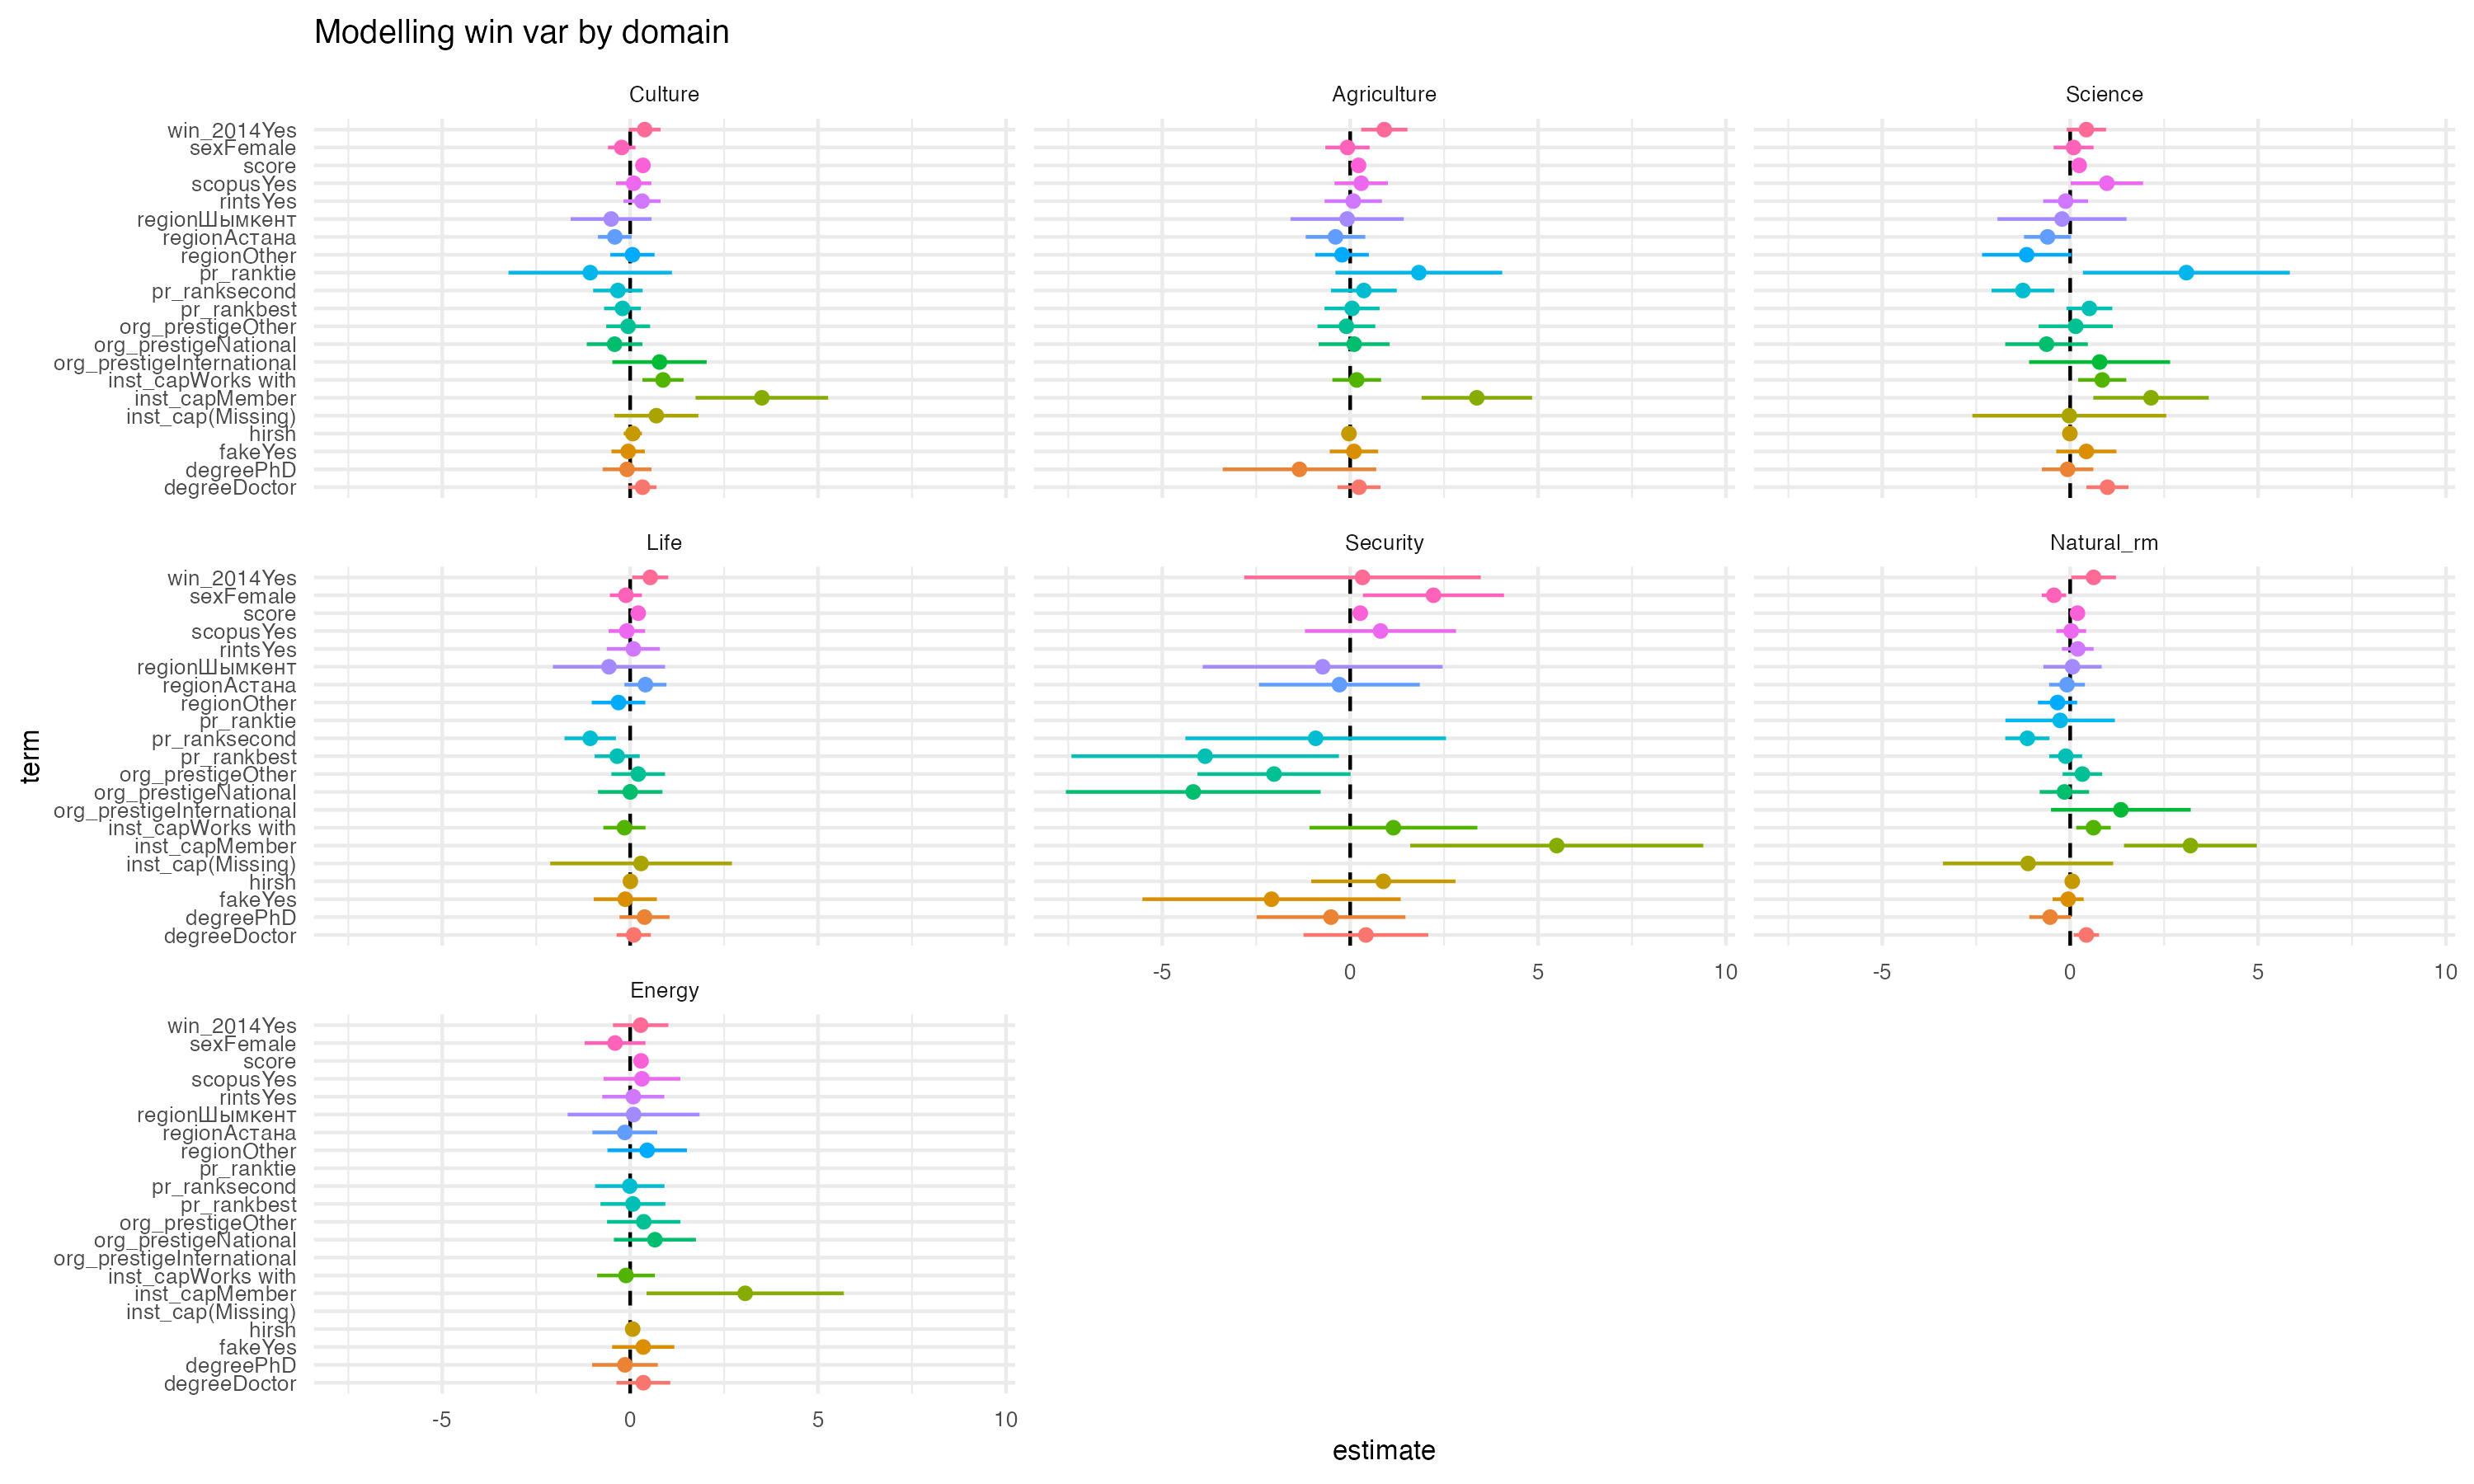
Влияние баллов
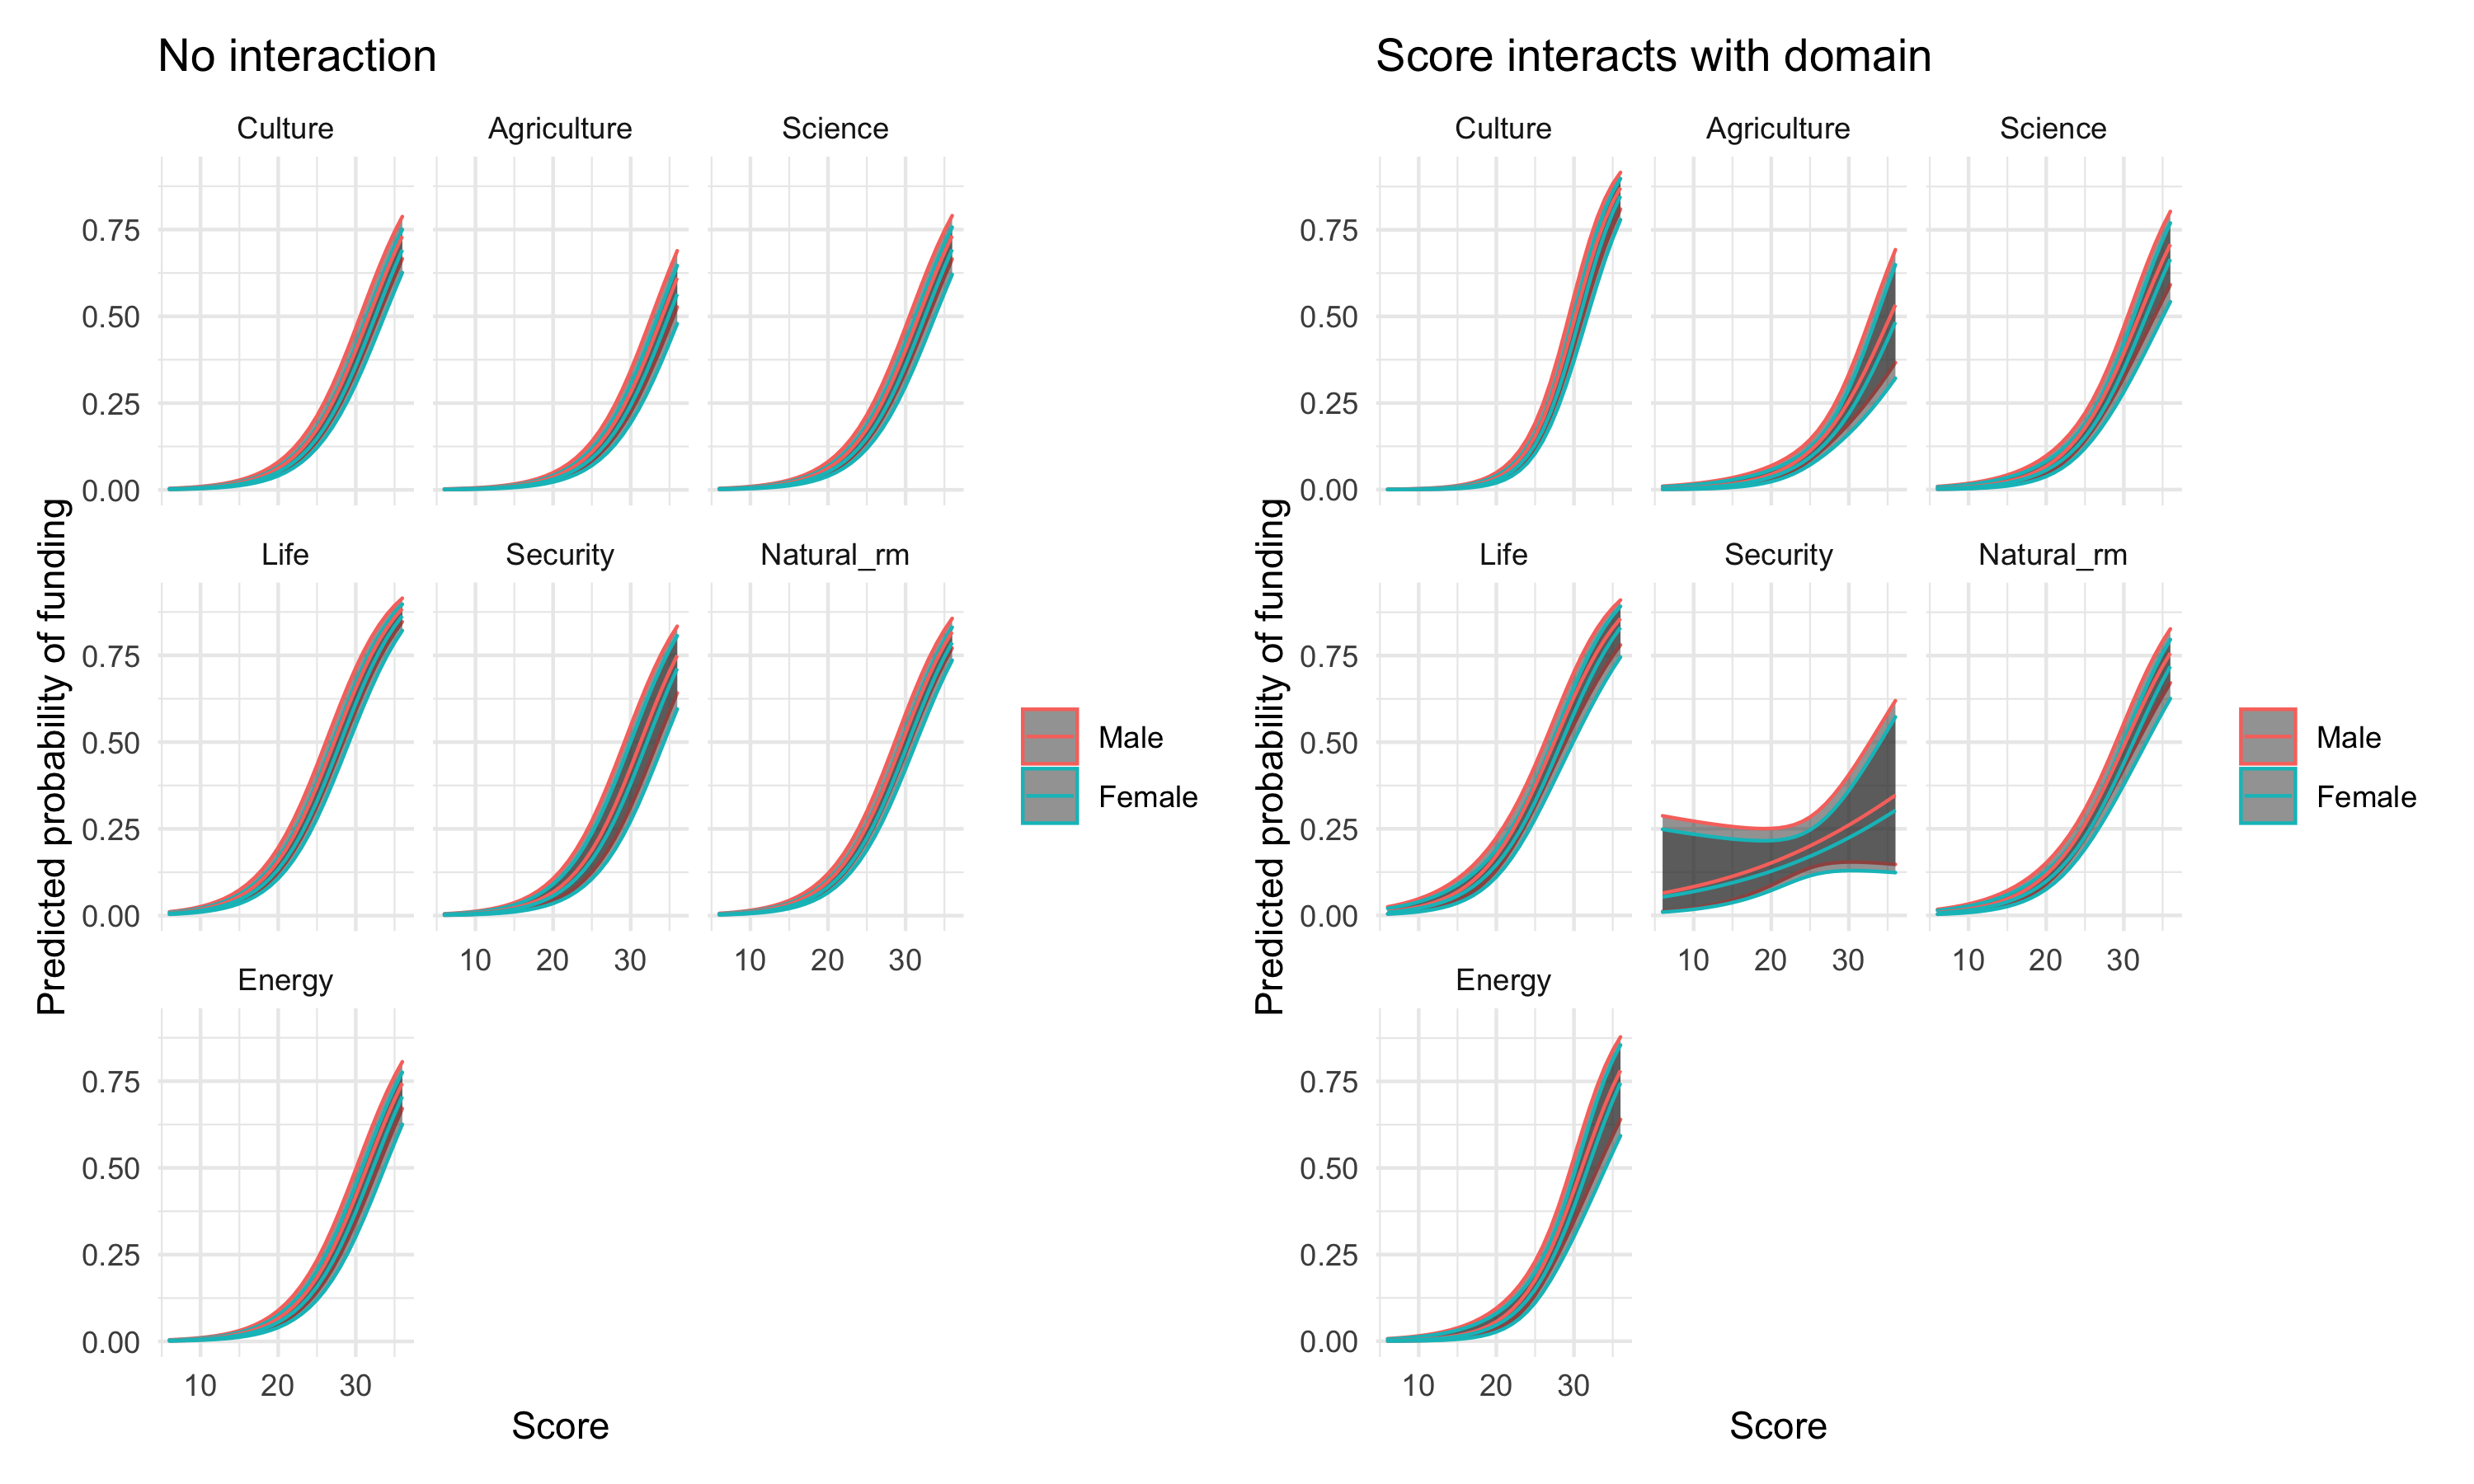
Здесь я тестировал эффект взаимодействия между баллами и направлением: предположение, что в разных направлениях члены ННС по-разному интерпретируют баллы. На первых панелях — рост вероятности победы с баллами без эффекта взаимодействия, на вторых — когда взаимодействие смоделировано явно. Самое интересное — направление «Культура»: оно стартует с довольно низких вероятностей (при 24 баллах шансы победить около 12%, тогда как в «Науках о жизни» аналогичный проект имел бы около 33%), но с ростом баллов вероятность победы растет гораздо быстрее и в верхней части диапазона догоняет и даже обгоняет другие направления. Условно: в «Науках о жизни» низкие баллы — еще не смертельный приговор, а в «Культуре» низкие баллы — это очень плохо, зато высокие быстро конвертируются в победу. И этот эффект одинаков для мужчин и женщин.
Интеракции: пол и баллы
Напомню, что такое эффект взаимодействия (мы разбирали его на примере PISA: в Казахстане богатство влияет на баллы по математике, а в Японии — нет). Без интеракции мы предполагаем, что числовая переменная влияет на отклик везде одинаково; с интеракцией мы позволяем силе этого влияния зависеть от значения другой, например категориальной, переменной.
Здесь я проверял гипотезу о взаимодействии баллов и пола руководителя: может быть, члены ННС по-разному интерпретируют баллы в зависимости от того, кто возглавляет проект? Условно: видят, что мужчина набрал 30 баллов — «о, круто», а когда женщина набрала 30 баллов — относятся сдержаннее.
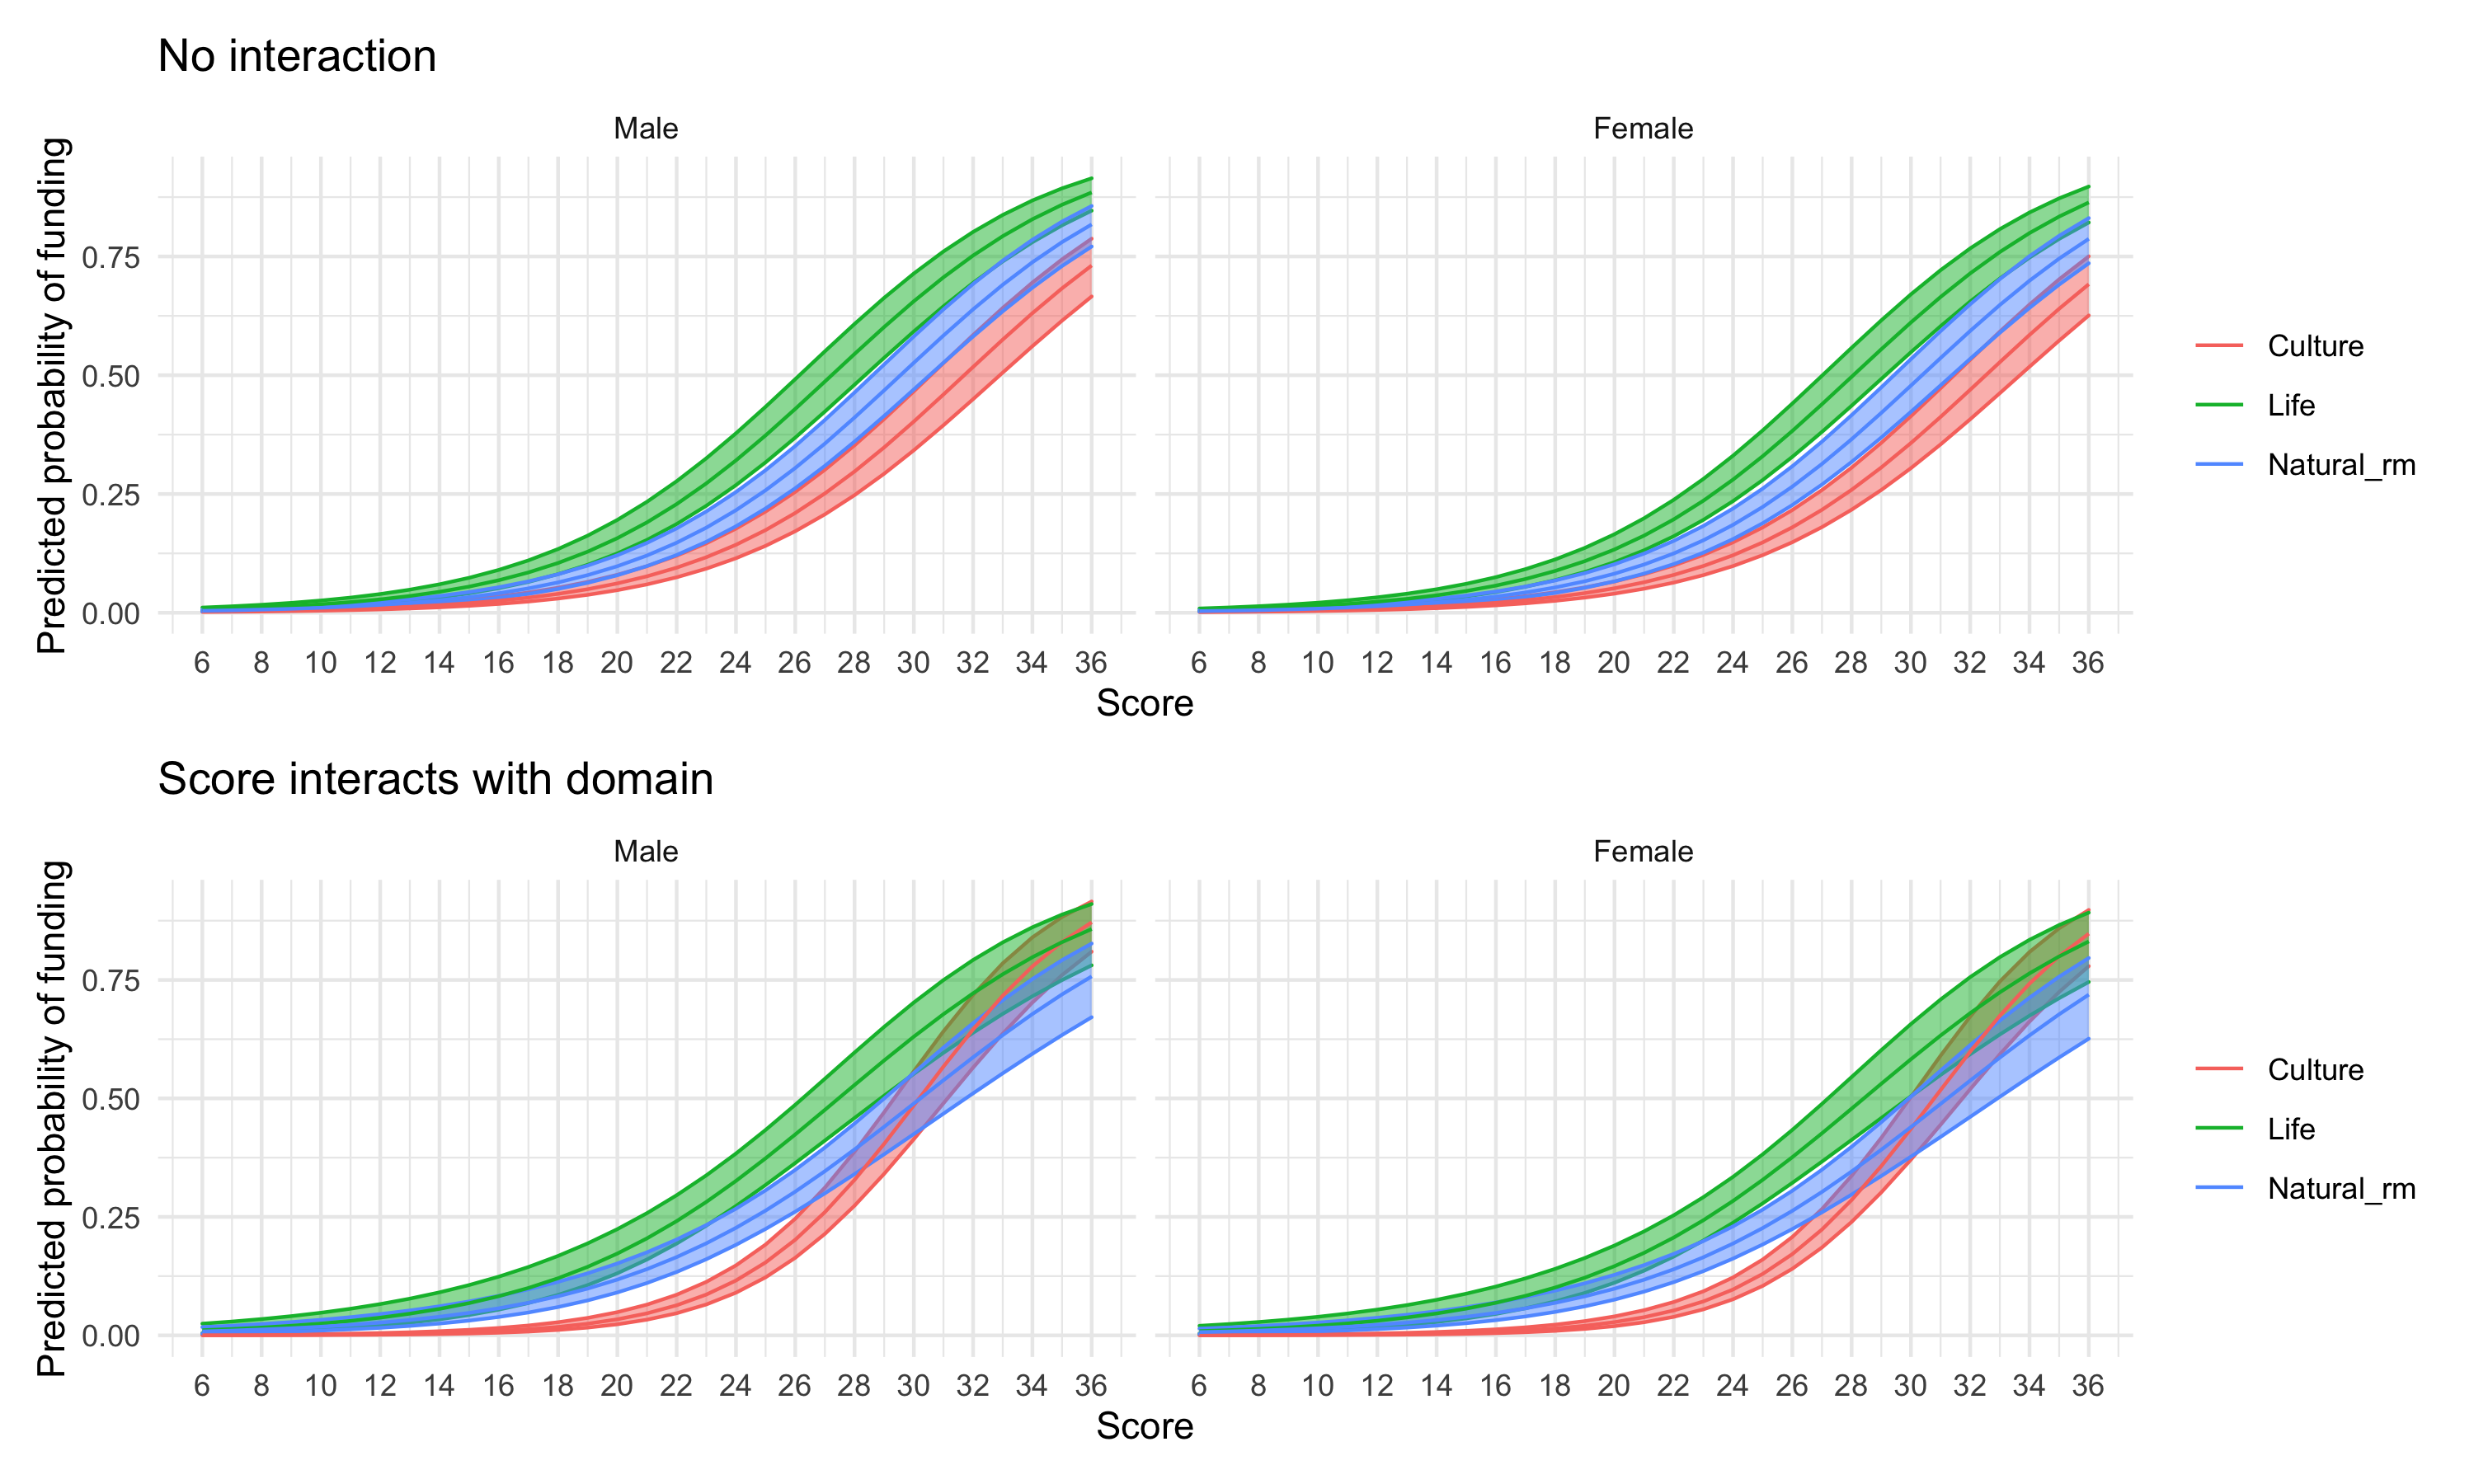
Забегая вперед: добавление интеракции «баллы × пол» качество модели не улучшило. Это говорит о том, что баллы для мужчин и женщин работают примерно одинаково: если дискриминация есть, она происходит не через интерпретацию баллов, а через какие-то другие механизмы.
Таблицы моделей
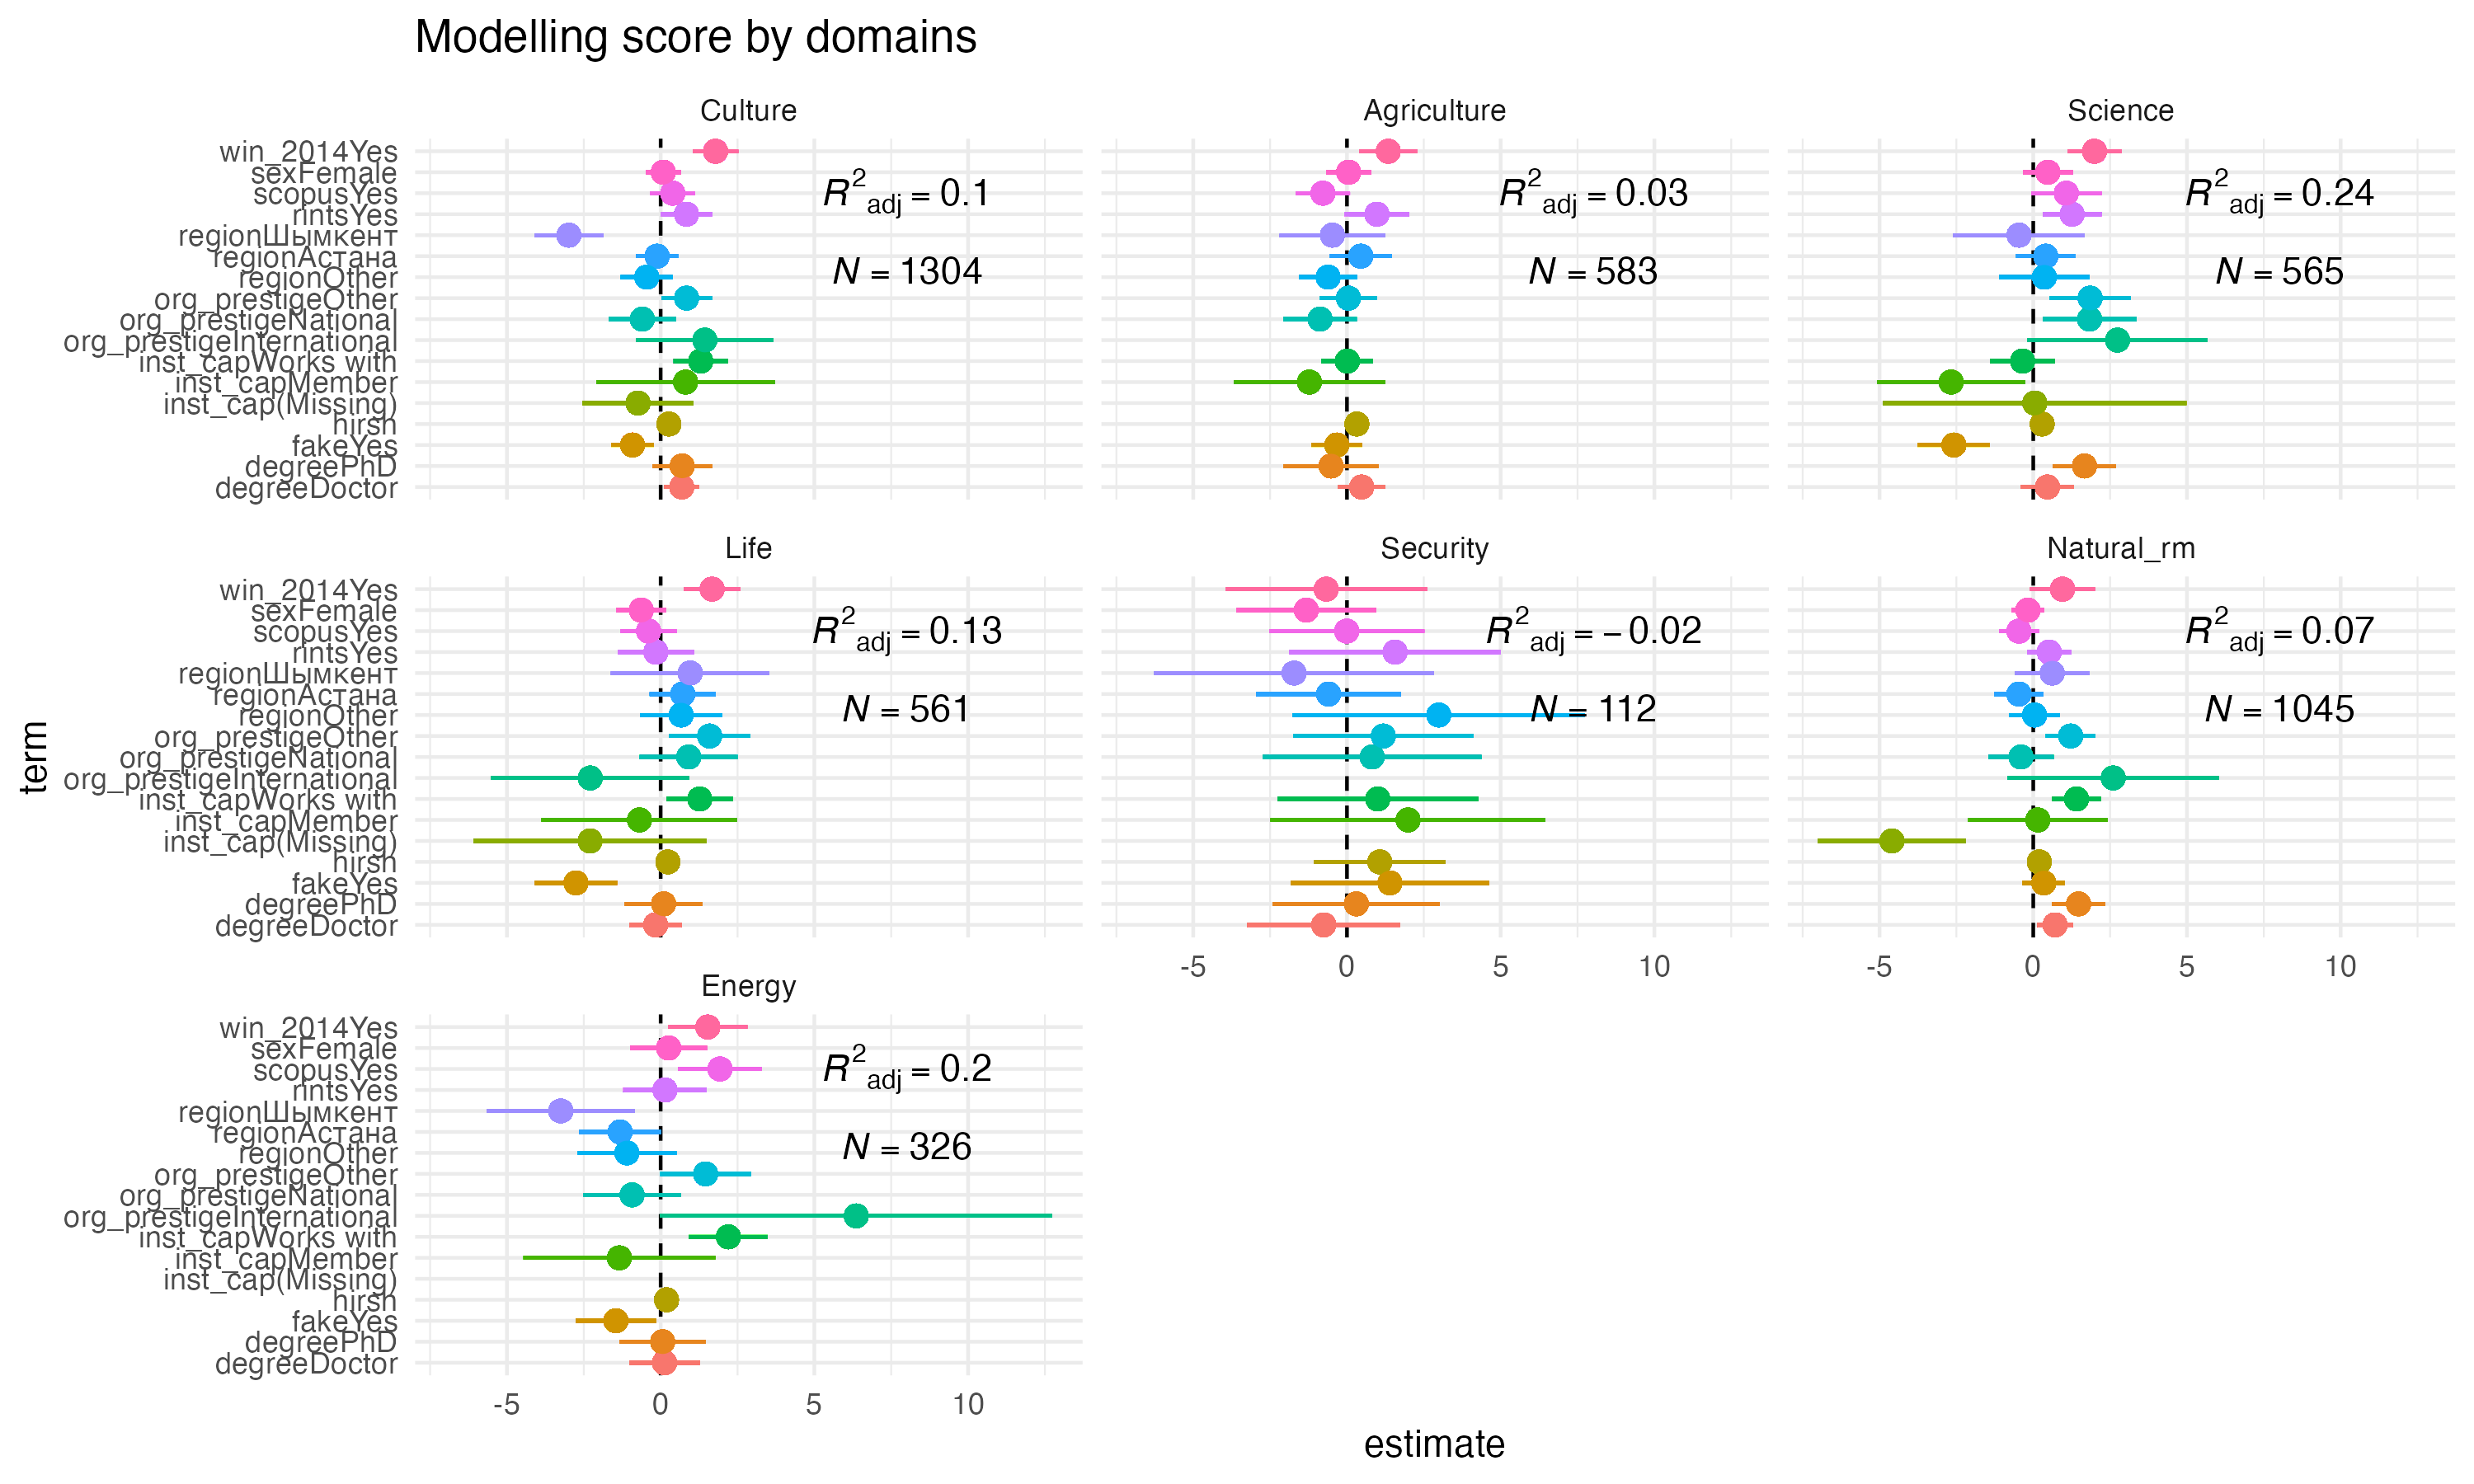
- Ниже — модели для баллов (что объясняет, сколько баллов получил проект от экспертов)
| sex | demo | demo+domain | demo+domain+fake+qual | full | |
|---|---|---|---|---|---|
| sexFemale | -0.699*** | -0.679*** | -0.452** | -0.267+ | -0.052 |
| 0.139 (<0.001) | 0.138 (<0.001) | 0.143 (0.002) | 0.141 (0.059) | 0.141 (0.714) | |
| regionАстана | -0.249 | -0.082 | -0.175 | 0.009 | |
| 0.175 (0.154) | 0.177 (0.646) | 0.174 (0.315) | 0.177 (0.962) | ||
| regionШымкент | -2.633*** | -2.538*** | -2.302*** | -1.435*** | |
| 0.279 (<0.001) | 0.279 (<0.001) | 0.275 (<0.001) | 0.309 (<0.001) | ||
| regionOther | -1.041*** | -0.918*** | -0.873*** | -0.366+ | |
| 0.176 (<0.001) | 0.178 (<0.001) | 0.176 (<0.001) | 0.209 (0.080) | ||
| domainAgriculture | 0.443+ | 0.274 | 0.198 | ||
| 0.232 (0.057) | 0.229 (0.232) | 0.228 (0.387) | |||
| domainScience | 1.327*** | 0.301 | 0.080 | ||
| 0.237 (<0.001) | 0.249 (0.227) | 0.247 (0.745) | |||
| domainLife | 0.221 | -0.284 | -0.525* | ||
| 0.233 (0.344) | 0.235 (0.227) | 0.236 (0.026) | |||
| domainSecurity | 0.135 | 0.115 | 0.323 | ||
| 0.457 (0.767) | 0.449 (0.798) | 0.444 (0.468) | |||
| domainNatural Rm | 1.056*** | 0.524** | 0.655*** | ||
| 0.195 (<0.001) | 0.197 (0.008) | 0.197 (<0.001) | |||
| domainEnergy | 0.845** | 0.089 | 0.111 | ||
| 0.291 (0.004) | 0.292 (0.761) | 0.289 (0.701) | |||
| fakeYes | -0.897*** | -0.811*** | |||
| 0.178 (<0.001) | 0.176 (<0.001) | ||||
| rintsYes | 0.792*** | 0.728*** | |||
| 0.195 (<0.001) | 0.193 (<0.001) | ||||
| scopusYes | 0.219 | 0.147 | |||
| 0.173 (0.205) | 0.171 (0.387) | ||||
| Hirsh | 0.316*** | 0.251*** | |||
| 0.029 (<0.001) | 0.029 (<0.001) | ||||
| Win 2014yes | 1.597*** | ||||
| 0.186 (<0.001) | |||||
| degreeDoctor | 0.472** | ||||
| 0.148 (0.001) | |||||
| degreePhD | 0.942*** | ||||
| 0.222 (<0.001) | |||||
| Inst capWorks with | 0.777*** | ||||
| 0.170 (<0.001) | |||||
| Inst capMember | -0.675 | ||||
| 0.525 (0.199) | |||||
| Inst Cap(Missing) | -1.784** | ||||
| 0.632 (0.005) | |||||
| Org prestigeNational | -0.159 | ||||
| 0.241 (0.509) | |||||
| Org prestigeInternational | 1.014 | ||||
| 0.668 (0.129) | |||||
| Org prestigeOther | 0.831*** | ||||
| 0.196 (<0.001) | |||||
| Num.Obs. | 4496 | 4496 | 4496 | 4496 | 4496 |
| R2 | 0.006 | 0.029 | 0.040 | 0.078 | 0.110 |
| R2 Adj. | 0.005 | 0.028 | 0.038 | 0.075 | 0.106 |
| AIC | 26595.2 | 26493.5 | 26456.2 | 26281.6 | 26139.1 |
| BIC | 26614.5 | 26531.9 | 26533.2 | 26384.1 | 26299.4 |
| Log.Lik. | -13294.621 | -13240.740 | -13216.118 | -13124.786 | -13044.552 |
| RMSE | 4.66 | 4.60 | 4.57 | 4.48 | 4.40 |
| Science | Energy | Natural_rm | Culture | Life | Agriculture | |
|---|---|---|---|---|---|---|
| hirsh | 0.291*** | 0.191* | 0.196*** | 0.280 | 0.229** | 0.170 |
| 0.048 (<0.001) | 0.089 (0.032) | 0.057 (<0.001) | 0.185 (0.131) | 0.073 (0.002) | 0.136 (0.212) | |
| win_2014Yes | 1.963*** | 1.536* | 0.982+ | 1.763*** | 1.703*** | 1.333** |
| 0.437 (<0.001) | 0.642 (0.017) | 0.524 (0.061) | 0.366 (<0.001) | 0.463 (<0.001) | 0.471 (0.005) | |
| rintsYes | 1.265** | 0.142 | 0.537 | 0.820* | -0.118 | 0.959+ |
| 0.478 (0.008) | 0.672 (0.833) | 0.355 (0.131) | 0.416 (0.049) | 0.613 (0.847) | 0.521 (0.066) | |
| scopusYes | 1.097+ | 1.829** | -0.441 | 0.387 | -0.405 | 0.037 |
| 0.572 (0.056) | 0.684 (0.008) | 0.320 (0.169) | 0.360 (0.283) | 0.451 (0.370) | 0.440 (0.934) | |
| fakeYes | -2.562*** | -1.430* | 0.323 | -0.932** | -2.719*** | -0.848* |
| 0.583 (<0.001) | 0.645 (0.027) | 0.343 (0.346) | 0.340 (0.006) | 0.662 (<0.001) | 0.416 (0.042) | |
| sexFemale | 0.484 | 0.225 | -0.175 | 0.109 | -0.616 | -0.023 |
| 0.405 (0.233) | 0.623 (0.718) | 0.265 (0.510) | 0.280 (0.696) | 0.399 (0.124) | 0.363 (0.949) | |
| regionАстана | 0.325 | -1.389* | -0.556 | -0.129 | 0.939+ | 0.504 |
| 0.479 (0.497) | 0.662 (0.037) | 0.393 (0.158) | 0.342 (0.707) | 0.537 (0.081) | 0.498 (0.312) | |
| regionШымкент | -0.619 | -3.499** | 0.494 | -3.094*** | 1.073 | -0.419 |
| 1.073 (0.564) | 1.210 (0.004) | 0.612 (0.420) | 0.551 (<0.001) | 1.289 (0.406) | 0.856 (0.625) | |
| regionOther | 0.190 | -1.111 | -0.006 | -0.434 | 0.692 | -0.458 |
| 0.746 (0.799) | 0.815 (0.174) | 0.409 (0.989) | 0.434 (0.318) | 0.658 (0.293) | 0.470 (0.331) | |
| degreeDoctor | 0.358 | 0.051 | 0.683* | 0.688* | -0.208 | 0.452 |
| 0.432 (0.408) | 0.570 (0.928) | 0.286 (0.017) | 0.285 (0.016) | 0.423 (0.622) | 0.386 (0.243) | |
| degreePhD | 1.459** | 0.406 | 1.672*** | 0.570 | 0.070 | -0.505 |
| 0.519 (0.005) | 0.701 (0.563) | 0.435 (<0.001) | 0.483 (0.238) | 0.630 (0.911) | 0.776 (0.515) | |
| inst_capWorks with | -0.363 | 2.275*** | 1.354*** | 1.268** | 1.172* | 0.043 |
| 0.523 (0.488) | 0.645 (<0.001) | 0.392 (<0.001) | 0.437 (0.004) | 0.540 (0.030) | 0.419 (0.918) | |
| inst_capMember | -2.647* | -1.277 | 0.112 | 0.756 | -0.758 | -1.029 |
| 1.209 (0.029) | 1.557 (0.412) | 1.128 (0.921) | 1.446 (0.601) | 1.588 (0.633) | 1.224 (0.401) | |
| inst_cap(Missing) | 0.055 | -4.542*** | -0.488 | -2.435 | ||
| 2.468 (0.982) | 1.202 (<0.001) | 0.895 (0.586) | 1.876 (0.195) | |||
| org_prestigeNational | 1.759* | -1.052 | -0.419 | -0.508 | 1.020 | -0.894 |
| 0.764 (0.022) | 0.803 (0.191) | 0.532 (0.431) | 0.550 (0.356) | 0.798 (0.202) | 0.596 (0.134) | |
| org_prestigeInternational | 2.724+ | 6.351* | 2.601 | 1.498 | -2.187 | |
| 1.469 (0.064) | 3.182 (0.047) | 1.713 (0.129) | 1.109 (0.177) | 1.608 (0.174) | ||
| org_prestigeOther | 1.763** | 1.343+ | 1.153** | 1.000* | 1.696* | 0.076 |
| 0.658 (0.008) | 0.741 (0.071) | 0.407 (0.005) | 0.412 (0.015) | 0.657 (0.010) | 0.458 (0.868) | |
| Num.Obs. | 565 | 326 | 1045 | 1304 | 561 | 583 |
| R2 | 0.255 | 0.238 | 0.083 | 0.114 | 0.161 | 0.050 |
| R2 Adj. | 0.232 | 0.199 | 0.068 | 0.102 | 0.135 | 0.025 |
| AIC | 3240.1 | 1904.4 | 5929.9 | 7732.8 | 3303.3 | 3309.3 |
| BIC | 3322.5 | 1972.6 | 6024.0 | 7831.0 | 3385.6 | 3383.6 |
| Log.Lik. | -1601.066 | -934.197 | -2945.941 | -3847.376 | -1632.674 | -1637.667 |
| RMSE | 4.12 | 4.25 | 4.06 | 4.63 | 4.44 | 4.02 |
- А теперь вернемся к логистическим моделям победы. В таблице ниже восемь моделей; интерсепт я убрал из таблицы для экономии места. Коэффициенты — это, как мы теперь знаем, прирост логарифма шансов при изменении соответствующей переменной на единицу.
| merit | merit+memory | merit+memory+demo | full-inst_cap | full | full, scoreXsex | full, scoreXdomain | full, hirshXsex | |
|---|---|---|---|---|---|---|---|---|
| Score | 0.246*** | 0.232*** | 0.224*** | 0.232*** | 0.227*** | 0.327*** | 0.232*** | |
| 0.010 (<0.001) | 0.011 (<0.001) | 0.011 (<0.001) | 0.012 (<0.001) | 0.015 (<0.001) | 0.026 (<0.001) | 0.012 (<0.001) | ||
| Hirsh | 0.143*** | 0.074*** | 0.041* | 0.020 | 0.020 | 0.023 | 0.010 | |
| 0.016 (<0.001) | 0.016 (<0.001) | 0.016 (0.012) | 0.017 (0.240) | 0.017 (0.227) | 0.017 (0.175) | 0.018 (0.559) | ||
| rintsYes | 0.284** | 0.177+ | 0.168 | 0.131 | 0.131 | 0.129 | 0.135 | |
| 0.097 (0.003) | 0.104 (0.089) | 0.110 (0.127) | 0.113 (0.244) | 0.113 (0.245) | 0.113 (0.253) | 0.113 (0.231) | ||
| scopusYes | 0.079 | 0.028 | 0.092 | 0.110 | 0.110 | 0.105 | 0.100 | |
| 0.090 (0.381) | 0.097 (0.770) | 0.103 (0.369) | 0.105 (0.294) | 0.105 (0.295) | 0.106 (0.320) | 0.106 (0.344) | ||
| fakeYes | -0.390*** | -0.207* | -0.069 | -0.058 | -0.057 | -0.021 | -0.058 | |
| 0.092 (<0.001) | 0.099 (0.036) | 0.109 (0.526) | 0.111 (0.599) | 0.111 (0.604) | 0.112 (0.848) | 0.111 (0.600) | ||
| Win 2014yes | 0.563*** | 0.520*** | 0.520*** | 0.509*** | 0.521*** | |||
| 0.102 (<0.001) | 0.104 (<0.001) | 0.104 (<0.001) | 0.104 (<0.001) | 0.104 (<0.001) | ||||
| degreeDoctor | 0.425*** | 0.399*** | 0.399*** | 0.398*** | 0.395*** | |||
| 0.087 (<0.001) | 0.088 (<0.001) | 0.088 (<0.001) | 0.089 (<0.001) | 0.088 (<0.001) | ||||
| degreePhD | -0.021 | -0.096 | -0.097 | -0.094 | -0.094 | |||
| 0.133 (0.877) | 0.137 (0.480) | 0.137 (0.480) | 0.137 (0.492) | 0.137 (0.491) | ||||
| domainAgriculture | -0.447** | -0.545*** | -0.544*** | 2.857* | -0.562*** | |||
| 0.157 (0.004) | 0.162 (<0.001) | 0.162 (<0.001) | 1.207 (0.018) | 0.162 (<0.001) | ||||
| domainScience | 0.058 | 0.004 | 0.004 | 2.827** | -0.012 | |||
| 0.149 (0.698) | 0.152 (0.982) | 0.152 (0.977) | 1.037 (0.006) | 0.153 (0.939) | ||||
| domainLife | 0.938*** | 1.040*** | 1.042*** | 4.142*** | 1.030*** | |||
| 0.137 (<0.001) | 0.141 (<0.001) | 0.141 (<0.001) | 0.943 (<0.001) | 0.141 (<0.001) | ||||
| domainSecurity | 0.230 | 0.135 | 0.136 | 6.837*** | 0.112 | |||
| 0.269 (0.392) | 0.284 (0.634) | 0.284 (0.633) | 1.554 (<0.001) | 0.285 (0.693) | ||||
| domainNatural Rm | 0.498*** | 0.518*** | 0.518*** | 3.883*** | 0.496*** | |||
| 0.118 (<0.001) | 0.120 (<0.001) | 0.120 (<0.001) | 0.896 (<0.001) | 0.121 (<0.001) | ||||
| domainEnergy | 0.103 | 0.076 | 0.075 | 1.988 | 0.055 | |||
| 0.175 (0.557) | 0.179 (0.671) | 0.179 (0.675) | 1.320 (0.132) | 0.179 (0.757) | ||||
| sexFemale | -0.221** | -0.203* | -0.464 | -0.211* | -0.268** | |||
| 0.085 (0.009) | 0.086 (0.019) | 0.584 (0.428) | 0.087 (0.015) | 0.097 (0.006) | ||||
| regionАстана | -0.129 | -0.238* | -0.238* | -0.247* | -0.235* | |||
| 0.104 (0.214) | 0.108 (0.027) | 0.108 (0.027) | 0.108 (0.022) | 0.108 (0.029) | ||||
| regionШымкент | -0.397+ | -0.365 | -0.365 | -0.335 | -0.369+ | |||
| 0.221 (0.072) | 0.224 (0.102) | 0.224 (0.103) | 0.224 (0.135) | 0.224 (0.099) | ||||
| regionOther | -0.336** | -0.323* | -0.323* | -0.325* | -0.329* | |||
| 0.130 (0.010) | 0.133 (0.015) | 0.133 (0.015) | 0.134 (0.015) | 0.133 (0.014) | ||||
| Org prestigeNational | 0.062 | -0.307* | -0.307* | -0.289+ | -0.317* | |||
| 0.136 (0.649) | 0.153 (0.045) | 0.153 (0.045) | 0.153 (0.059) | 0.153 (0.038) | ||||
| Org prestigeInternational | 0.397 | 0.353 | 0.354 | 0.326 | 0.349 | |||
| 0.381 (0.298) | 0.389 (0.364) | 0.389 (0.362) | 0.395 (0.410) | 0.389 (0.370) | ||||
| Org prestigeOther | 0.151 | 0.055 | 0.055 | 0.059 | 0.049 | |||
| 0.122 (0.215) | 0.127 (0.664) | 0.127 (0.664) | 0.127 (0.644) | 0.127 (0.697) | ||||
| Pr Ranksecond | -0.675*** | -0.726*** | -0.727*** | -0.719*** | -0.731*** | |||
| 0.141 (<0.001) | 0.145 (<0.001) | 0.145 (<0.001) | 0.145 (<0.001) | 0.145 (<0.001) | ||||
| Pr Rankbest | -0.083 | -0.100 | -0.098 | -0.089 | -0.105 | |||
| 0.110 (0.451) | 0.112 (0.372) | 0.112 (0.380) | 0.112 (0.428) | 0.112 (0.351) | ||||
| Pr Ranktie | 0.379 | 0.415 | 0.417 | 0.346 | 0.416 | |||
| 0.479 (0.429) | 0.476 (0.384) | 0.476 (0.381) | 0.479 (0.469) | 0.476 (0.382) | ||||
| Inst capWorks with | 0.588*** | 0.588*** | 0.575*** | 0.590*** | ||||
| 0.102 (<0.001) | 0.102 (<0.001) | 0.102 (<0.001) | 0.102 (<0.001) | |||||
| Inst capMember | 3.093*** | 3.092*** | 3.084*** | 3.098*** | ||||
| 0.337 (<0.001) | 0.337 (<0.001) | 0.342 (<0.001) | 0.336 (<0.001) | |||||
| Inst Cap(Missing) | 0.284 | 0.287 | 0.246 | 0.290 | ||||
| 0.406 (0.484) | 0.406 (0.480) | 0.413 (0.552) | 0.407 (0.475) | |||||
| score:sexFemale | 0.010 | |||||||
| 0.022 (0.652) | ||||||||
| score:domainAgriculture | -0.129** | |||||||
| 0.046 (0.005) | ||||||||
| score:domainScience | -0.106** | |||||||
| 0.038 (0.006) | ||||||||
| score:domainLife | -0.118** | |||||||
| 0.036 (0.001) | ||||||||
| score:domainSecurity | -0.259*** | |||||||
| 0.061 (<0.001) | ||||||||
| score:domainNatural Rm | -0.128*** | |||||||
| 0.034 (<0.001) | ||||||||
| score:domainEnergy | -0.073 | |||||||
| 0.049 (0.137) | ||||||||
| hirsh:sexFemale | 0.055 | |||||||
| 0.038 (0.146) | ||||||||
| Num.Obs. | 4488 | 4488 | 4488 | 4488 | 4488 | 4488 | 4488 | 4488 |
| AIC | 4250.2 | 4838.3 | 4217.7 | 4031.0 | 3913.5 | 3915.3 | 3898.0 | 3913.4 |
| BIC | 4263.0 | 4870.4 | 4256.1 | 4191.3 | 4093.0 | 4101.2 | 4115.9 | 4099.3 |
| Log.Lik. | -2123.111 | -2414.162 | -2102.828 | -1990.511 | -1928.771 | -1928.669 | -1915.019 | -1927.704 |
| RMSE | 0.39 | 0.42 | 0.39 | 0.38 | 0.37 | 0.37 | 0.37 | 0.37 |
Давайте потренируемся в интерпретации.
- Базовая модель (merit). В ней всего одна переменная — баллы: гипотетическая ситуация, в которой члены ННС смотрят только на баллы и игнорируют все остальное. Наивная модель, но она нужна как базовый уровень для сравнения. Коэффициент при баллах ≈ 0.24: за каждый дополнительный балл логарифм шансов растет на 0.24, а сами шансы — на экспоненту от этого числа (~27%). Три звезды — p-значение меньше 0.1%, эффект значим.
- Академические характеристики. Вторая модель вместо баллов включает характеристики руководителя: индекс Хирша, РИНЦ (российский индекс научного цитирования — аналог Скопуса для русскоязычных публикаций), Скопус и индикатор публикаций в «хищнических» журналах (тех, что позже были отозваны). Коэффициент Хирша ≈ 0.14: единица прироста индекса увеличивает шансы победы примерно на 15% (\(e^{0.14}\)). А публикации в отозванных журналах значимо уменьшали шансы выиграть.
- Объединение блоков. В третьей модели баллы и академические характеристики вместе. Обратите внимание: значимость Хирша сохранилась, но размер коэффициента упал почти вдвое. Почему? Баллы и Хирш коррелируют: люди с высоким Хиршем писали заявки, которые получали более высокие баллы. То, что во второй модели выглядело как влияние Хирша, частично объясняется баллами — а тем, у кого Хирш был высокий, но баллы низкие, Хирш помогал уже не так сильно. Аналогично изменился и коэффициент «хищнических» журналов: люди с более высокими баллами реже в них печатались.
- Полная модель. Когда я добавил все переменные (включая докторскую степень и победу в конкурсе 2014 года), значимость индекса Хирша практически исчезла. Одна из интерпретаций: сам по себе Хирш на решение не влиял — он влиял опосредованно, через коррелирующие с ним вещи. Например, победитель 2014 года получил финансирование, написал статьи, их процитировали — и его Хирш выше среднего. Или докторская степень: докторские степени перестали присуждаться после перехода на болонскую систему, так что «доктор наук» — это, по сути, индикатор «человек защитился давно, он давно в академии, у него есть репутация и связи» — а это, конечно, коррелирует с высоким Хиршем. Похоже, что при принятии решений смотрят не на Хирш, а на степень, прошлые победы и подобные вещи. Интересное наблюдение: индекс Хирша был задуман как прямой способ сравнивать продуктивность ученых, но в нашем конкурсе на него обращают внимание разве что косвенно. И заметьте: если вы раз выиграли грант, вам, скорее всего, дадут и следующий — преимущество накапливается.
- Сравнение по AIC. Первая модель (только баллы) справлялась существенно лучше второй (четыре академические переменные) — хорошая модель это не обязательно модель с большим числом переменных, а та, что описывает данные экономно. Дальше AIC улучшается по мере добавления переменных (я проверял — все эти разницы статистически значимы), пока не выходит на плато. Добавление интеракции «баллы × пол» модель не улучшило (баллы работают одинаково для мужчин и женщин), а вот интеракция «баллы × направление» дала резкое падение AIC — баллы действительно по-разному интерпретируются в разных направлениях, как мы и видели на графиках выше.
Немного о качестве моделей
Разработан в 1971 как «an information criterion» («(некий) информационный критерий») Хироцугу Акаике↩︎