| sleep | GPA |
|---|---|
| 5.373546 | 2.541726 |
| 6.183643 | 2.925353 |
| 5.164371 | 2.418771 |
| 7.595281 | 3.386143 |
| 6.329508 | 2.831231 |
| 5.179532 | 2.959112 |
12 Линейная регрессия
Линейная регрессия
Перейдем к линейной регрессии. Это рабочая лошадка всей статистики: во многом благодаря линейной регрессии статистика и приобрела свою популярность. Универсальный — и, в каком-то смысле, даже немного заезженный — метод оценки линейной зависимости между переменными: в самом простом случае между двумя, а в общем случае — между неограниченным количеством переменных. Давайте сначала разберемся в логике концептуально, а потом перейдем к техническим деталям.
Начнем с небольшого примера, который подготовит почву. Рассмотрим две переменные:
- \(X\) -
sleep- среднее время сна в сутки случайного студента - \(Y\) -
GPA- его/ее GPA
Мы набрали какое-то количество студентов и узнали у них, сколько они в среднем спят и какой у них GPA. Данные выглядят примерно так: первый студент спит около 5 часов, и у него GPA чуть меньше 2.5, и так далее.
На принципиальном уровне нам интересно понять, связано ли время сна статистически с повышенным или пониженным GPA. Мы можем придумать разные теории, которые так или иначе связывали бы эти переменные. Например, можно подумать, что для хороших оценок студенту нужно много учиться — а значит, сокращать время сна. Или наоборот: чтобы хорошо учиться, нужно находиться в хорошем тонусе и фокусе, а для этого нужно спать больше. У нас есть несколько конкурирующих гипотез, и мы хотели бы проверить, насколько они оправданы.
Когда у нас есть две числовые переменные, первое, что мы делаем (мы об этом говорили в первых главах), — рисуем диаграмму рассеяния и смотрим на совместное распределение.
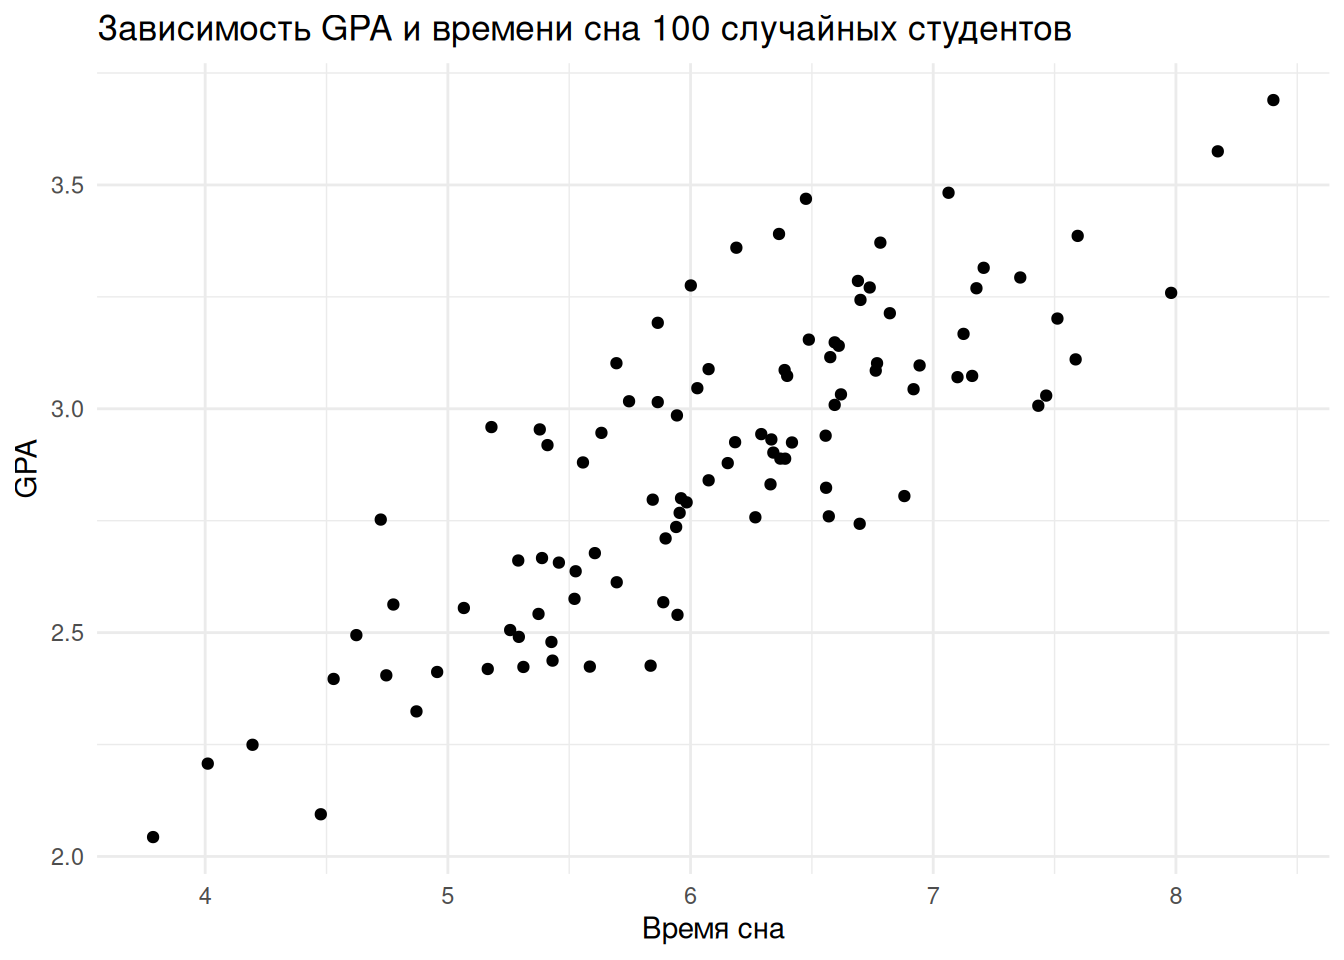
Данные здесь синтетические — я сам их произвел и заранее заложил в них зависимость между временем сна и GPA. Глядя на диаграмму, мы видим, что зависимость в среднем положительная: студенты, которые больше спят, в среднем имеют более высокий GPA. Визуально у нас явно есть тренд — давайте попробуем его описать.
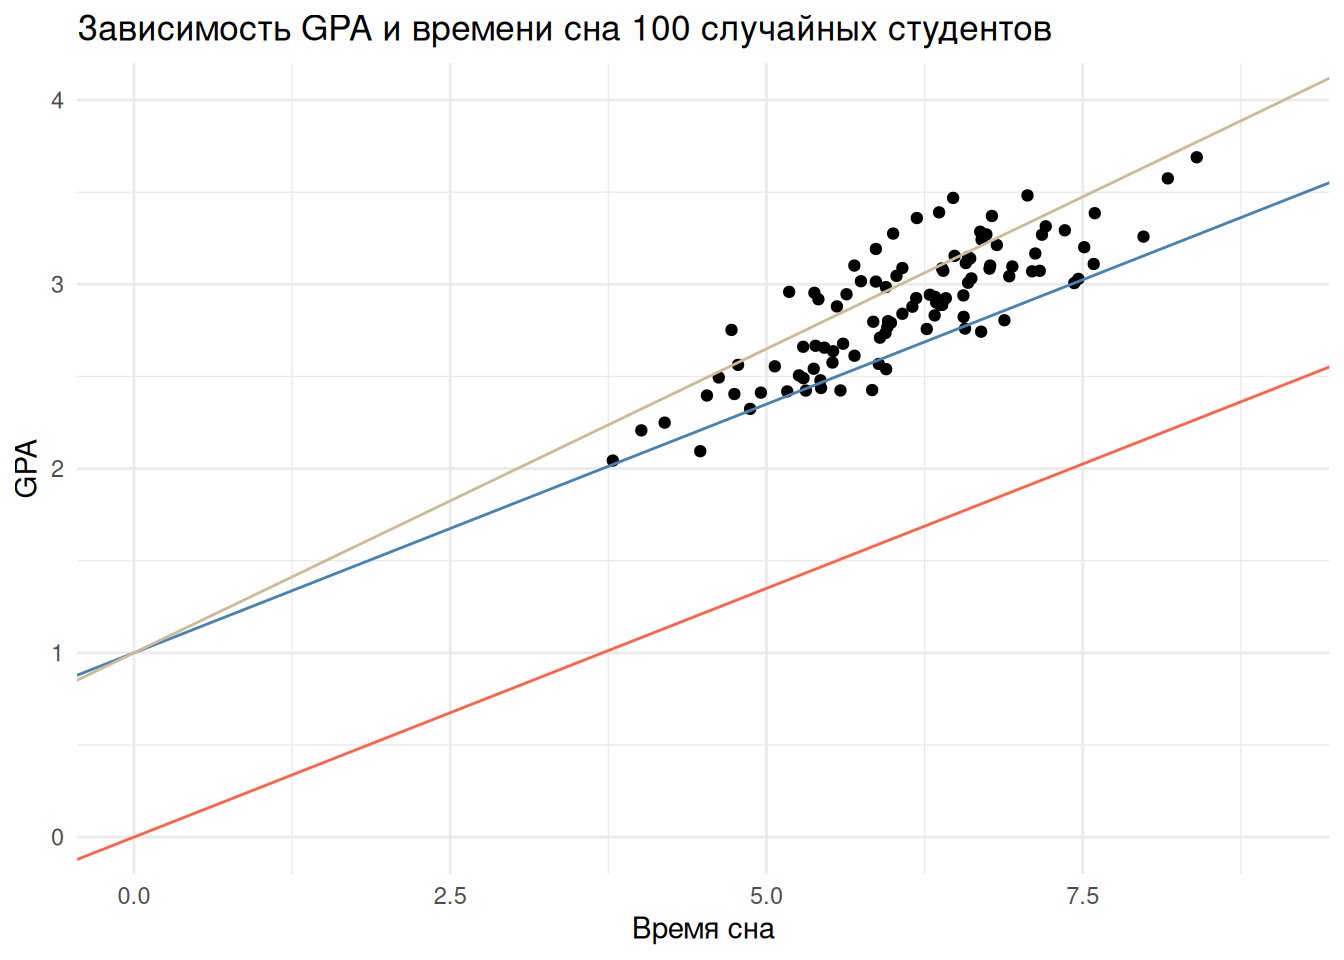
Как вы думаете, какая из линий лучше описывает тренд? И почему?
- Красная
- Синяя
- Пшеничная
Можно спорить, лучше ли синяя или пшеничная, но все мы, наверное, согласимся, что красная описывает зависимость плохо. Что именно делает ее плохой кандидатурой? Она даже не проходит через облако точек: модель целиком находится в той зоне значений, для которых у нас нет данных, — она попросту промахивается мимо реальных наблюдений.
Давайте немного формализуем то, что мы тут проделали. Когда мы проводим линию на плоскости \(x, y\), мы, по сути, задаем уравнение. Из школьного курса алгебры мы помним, что каждая прямая — это уравнение вида \(y = kx + b\): коэффициент \(k\) контролирует угол наклона, а свободный член \(b\) показывает, где линия пересекает ось \(Y\). Фактически, нарисовав три линии, я задал три уравнения, и каждое из них — это модель моих данных: с его помощью я пытаюсь описать хотя бы систематическую часть тренда.
Немного алгебры
В статистике принято обозначать эти уравнения немного иначе. Прямая линия - это, по сути, модель данных: \(GPA = \beta_0 + \beta_1*sleep\)
- \(\beta_0\) - это точка пересечения с осью Y (intercept)
- \(\beta_1\) - наклон прямой (slope) (aka угловой коэффициент)
Когда мы проводим прямую, мы задаем параметры \(\beta_1\) и \(\beta_0\)
- Можно проинтерпретировать \(\beta_1\) - наклон - так: за каждый \(1\) дополнительный час сна, студент в среднем улучшает свой GPA на \(\beta_1\)
Это хорошо, но прямых можно провести сколько угодно — и 10, и 20, и 50, и какие-то из них будут описывать данные хорошо, а какие-то плохо. Как решить, какая из них лучше? Интуитивно понятно, что синяя лучше описывает данные чем красная. Менее очевидна, однако, разница между синей и пшеничной прямой. Было бы неплохо найти численную характеристику того, насколько линия хорошо описывает данные.
Заметим, что линия дает нам предсказанные значения зависимой переменной. Скажем, согласно синей модели, у студента, который спит 7.5 часов, GPA должен быть где-то в районе 3. У нас есть наблюдения за GPA, \(y_i\), а также есть предсказанные значения, \(\hat{y}_i\). Разница между ними - это ошибка предсказания \(\epsilon_i = y_i - \hat{y}_i\). Эти ошибки называются остатками1 (residuals). Что произойдет, если мы возьмем все наши остатки, возведем их в квадрат (чтобы положительные и отрицательные ошибки не “самоуничтожились”) и сложим? Обозначим эту сумму \(J\)
\(J(\beta_0, \beta_1) = \sum_{i=1}^{n}(\epsilon^2) = \sum_{i=1}^{n}(y_i - \hat{y}_i)^2 = \sum_{i=1}^{n}(y_i - \beta_0 - \beta_1 x_i)^2\)
Выглядит как неплохой способ описать близость между прямой и данными.
Маленькие значения \(J\) означают, что сумма наших ошибок невелика - то есть прямая хорошо описывает данные. Большие значения \(J\), что сумма наших ошибок велика, то есть прямая плохо описывает данные. \(J\) - называется функцией потерь. Обратите внимание: данные нам даны, с ними мы ничего сделать не можем, поэтому \(J\) зависит только от двух параметров — от того, как мы провели линию, то есть от \(\beta_0\) и \(\beta_1\). Теперь, используя эту метрику, сравним те три линии.
Попробуем проверить. У нас есть три модели
- Модель 1, красная прямая: \(\beta_0 = 0, \beta_1 = 0.27\) or \(\hat{Y}_{red} = 0 + 0.27X\)
- Модель 2, синяя прямая: \(\beta_0 = 1, \beta_1 = 0.27\) or \(\hat{Y}_{blue} = 1 + 0.27X\)
- Модель 3, пшеничная прямая: \(\beta_0 = 1, \beta_1 = 0.33\) or \(\hat{Y}_{wheat} = 1 + 0.33X\)
students_sleep_reg <-
  students_sleep %>%
  mutate(res_red = GPA - (0 + 0.27*sleep),
         res_blue = GPA - (1 + 0.27*sleep),
         res_wheat = GPA - (1 + 0.33*sleep))
students_sleep_reg %>%
  summarise(j_red = sum(res_red^2),
            j_blue = sum(res_blue^2),
            j_wheat = sum(res_wheat^2)) %>%
knitr::kable(col.names = c("Красная", "Синяя", "Пшеничная"))| Красная | Синяя | Пшеничная |
|---|---|---|
| 156.7258 | 9.366998 | 5.349284 |
У нас появился конкретный численный критерий, по которому можно сказать, что одна модель лучше другой, — не нужно прикидывать на глаз.
Как найти самую-самую?
Из трех изначальных моделей, мы смогли выбрать лучшую. Но в принципе-то моделей бесконечное множество? Существует ли самая-самая лучшая? Что подразумевает вопрос: а имеет ли \(J(\beta_0, \beta_1)\) минимум? \(J()\) — это сумма квадратов, поэтому да, имеет, и один-единственный к тому же. (Это, кстати, одна из причин, почему математики так любят все возводить в квадрат: производная квадратичной функции — линейная функция, у которой есть вполне себе нормальный ноль, поэтому минимум находится простым решением системы уравнений.) Значит, мы можем найти некие \(\beta_0^{'}\) and \(\beta_1^{'}\) такие что \(J(\beta_0^{'}, \beta_1^{'})\) примет минимальное значение или на “математическом”,
\[ \arg\min_{\beta_0, \beta_1}(J(\beta_0, \beta_1)) = \arg\min_{\beta_0, \beta_1}(\sum_{i=1}^{n}(y_i - \beta_0 - \beta_1 x_i)^2) \]
Если мы найдем эти два заветных параметра, мы будем точно уверены: лучше уже не будет, это лучшая линия, которую можно провести через наше облако данных. Вручную это, естественно, никто не делает — все давно реализовано в статистических программах. К счастью, R позволяет нам не думать о технических деталях.
my_linear_model <- lm(data = students_sleep, GPA ~ sleep) # подгоняем модель
summary(my_linear_model) # смотрим на результаты
Call:
lm(formula = GPA ~ sleep, data = students_sleep)

Residuals:
    Min      1Q  Median      3Q     Max
-0.3754 -0.1227 -0.0279  0.1079  0.4692

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept)  0.99373    0.13302   7.471 3.36e-11 ***
sleep        0.30979    0.02155  14.378  < 2e-16 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 0.1926 on 98 degrees of freedom
Multiple R-squared:  0.6784,    Adjusted R-squared:  0.6751
F-statistic: 206.7 on 1 and 98 DF,  p-value: < 2.2e-16
Давайте научимся читать этот вывод — самая важная его часть это таблица коэффициентов. В ней две строки, соответствующие \(\beta_0\) (строка (Intercept)) и \(\beta_1\) (строка sleep), и несколько столбцов:
- Estimate — оценка коэффициента: то значение, которое максимально хорошо описывает наши данные. Поскольку я сам произвел эти данные, я точно знаю, что заложил внутрь: интерсепт 1 и наклон 0.31. Модель вернула значения, очень близкие к истинным — статистика дает приближенные оценки, но при выполнении базовых допущений они будут достаточно близки к тому, что происходит “в реальности”.
- Std. Error — стандартная ошибка оценки. Задумайтесь: оценка коэффициента — это тоже случайная переменная. Если бы мы взяли другую выборку студентов из той же популяции, мы получили бы немного другие значения коэффициентов. Стандартная ошибка показывает, насколько эти оценки варьировались бы от выборки к выборке. Здесь работает знакомое правило трех сигм: интервал “оценка ± 3 стандартные ошибки” накрывает истинное значение коэффициента примерно в 99% случаев. У нас стандартная ошибка наклона около 0.02: умножаем на 3, получаем ±0.06, то есть истинный коэффициент где-то между 0.24 и 0.36.
- t value — отношение оценки коэффициента к его стандартной ошибке: насколько далеко оценка ушла от нуля, если измерять расстояние в стандартных ошибках.
- Pr(>|t|) — p-значение: вероятность наблюдать такую оценку коэффициента, как у нас, при условии, что истинный коэффициент равен нулю.
Почему нам так интересно сравнивать коэффициент с нулем? Что было бы, если бы коэффициент на самом деле был равен нулю? Это описывало бы ситуацию, в которой сон не оказывает никакого влияния на GPA. По сути, это наша нулевая гипотеза: проверяя значимость коэффициента, мы занимаемся уже знакомой проверкой гипотез. Нулевая гипотеза — влияния нет (\(\beta_1 = 0\)), альтернативная — влияние есть. Чем меньше p-значение, тем больше свидетельств в пользу альтернативной. Здесь p-значение равно \(2\times10^{-16}\) — очень близко к нулю, значит, у нас есть основания верить, что между сном и GPA есть статистическая связь.
Последний столбец без названия — это звезды, они показывают уровень значимости: три звезды — p-значение меньше 0.001, две — меньше 0.01, одна — меньше 0.05, точка — меньше 0.1. Звезды — быстрый способ увидеть, где вы максимально уверены в связи между переменными (а у статистиков очень много шуток и мемов про охоту за звездами).
Теперь мы можем взять посчитанные коэффициенты и провести соответствующую им линию:
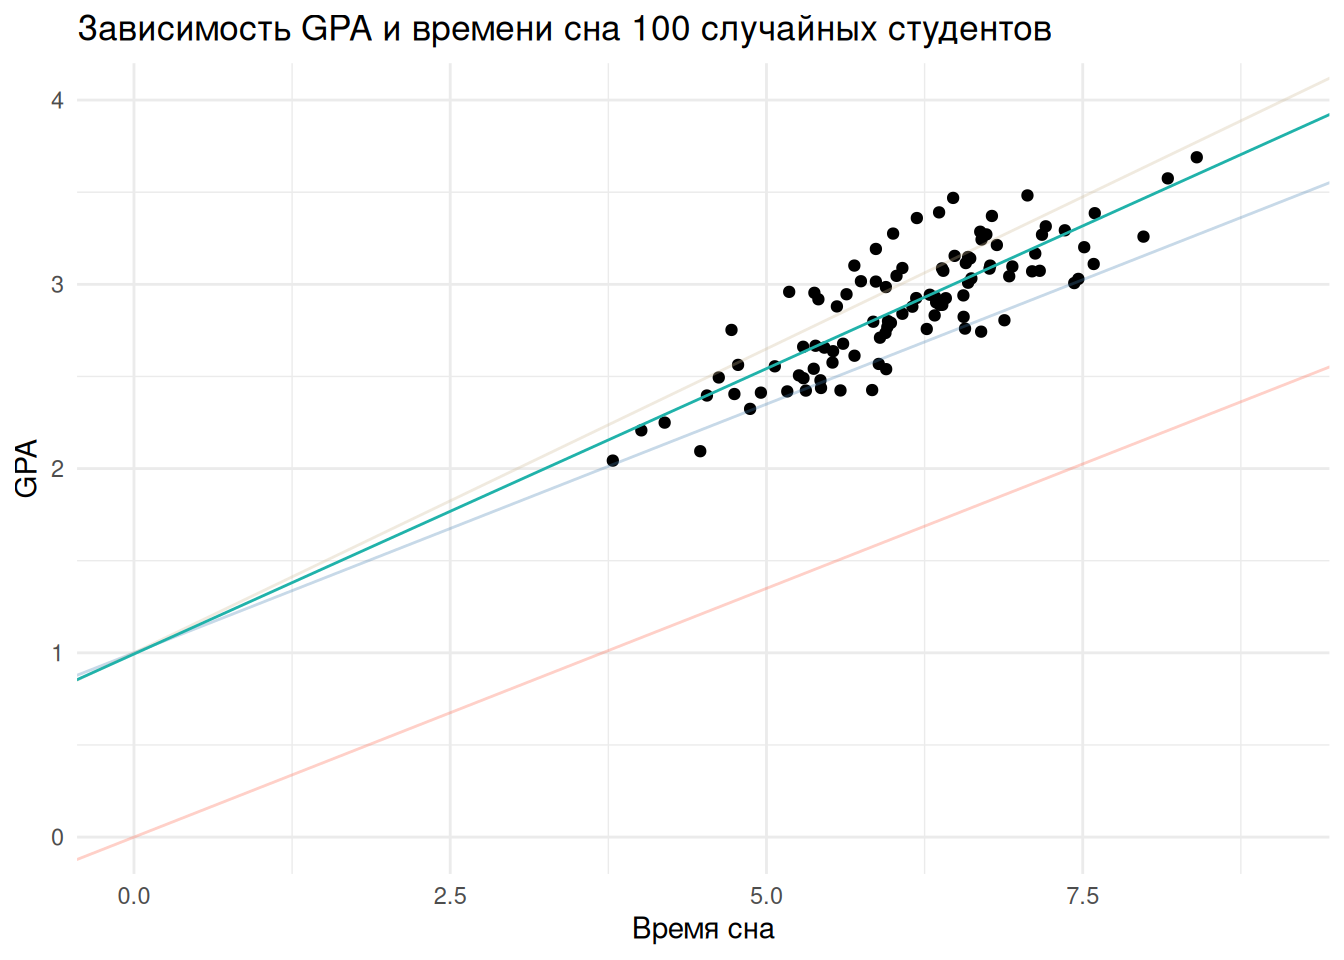
Числа тоже подтверждают
| j_red | j_blue | j_wheat | j_best |
|---|---|---|---|
| 156.7258 | 9.366998 | 5.349284 | 3.633424 |
Значение функции потерь для новой модели — минимально возможное на этих данных: меньше точно быть не может.
Подумаем об остатках
Давайте немного подумаем об остатках. Остатки — это, по сути, ошибки, которые сделала наша модель. Построим диаграмму рассеяния остатков против значений объясняющей переменной. Среднее остатков для красной модели равно \(1.25\)
students_sleep_reg %>%
  ggplot(aes(x = sleep, y = res_red)) +
  geom_point() +
  geom_hline(yintercept = mean(students_sleep_reg$res_red))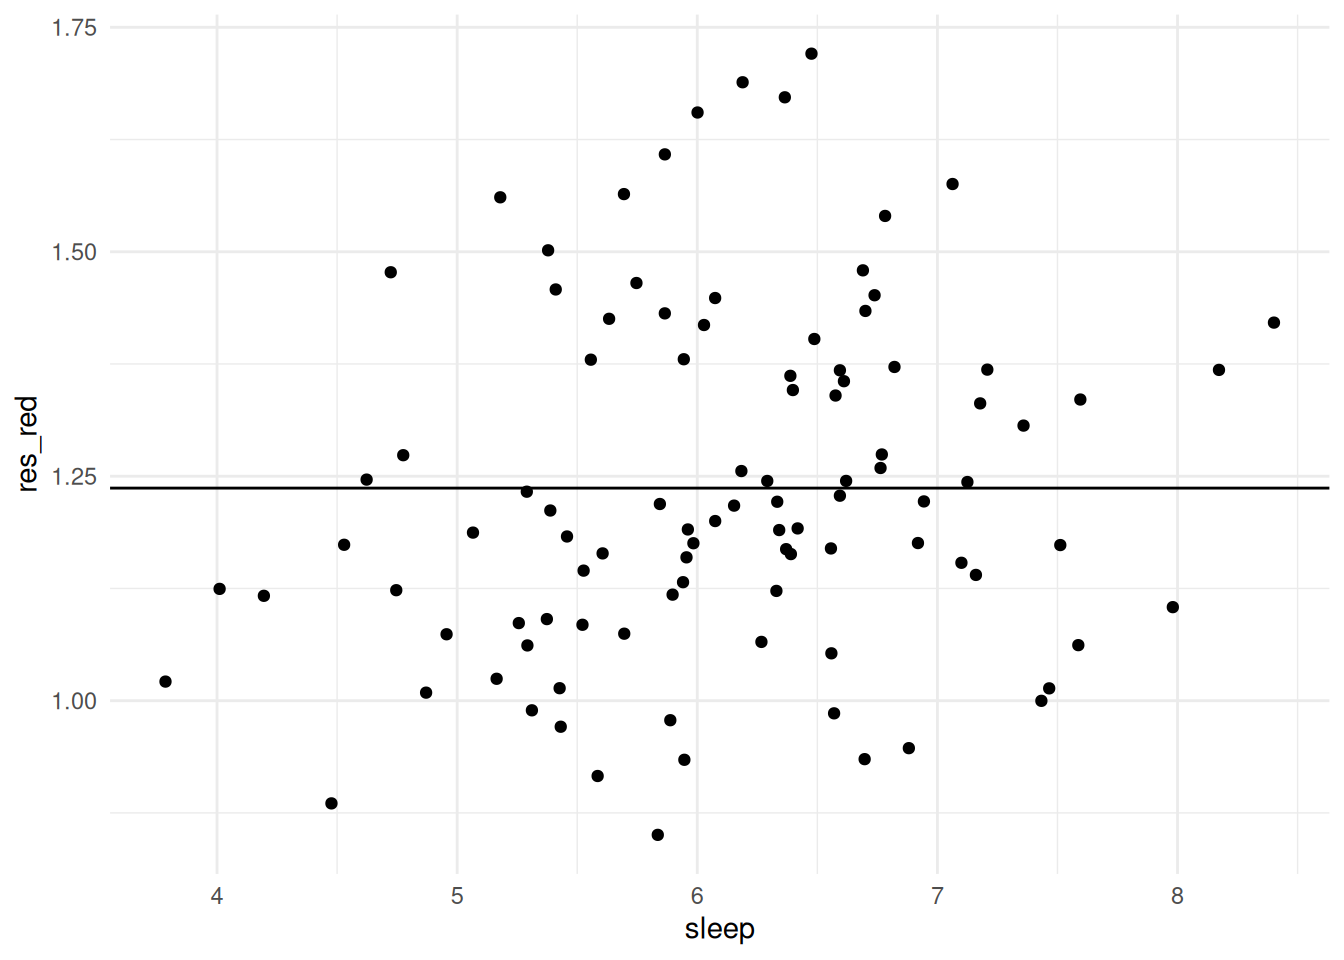
Если присмотреться, все ошибки красной модели положительные. Это плохо: мы понимаем, что модель может ошибаться — в статистике все делают ошибки, — но мы хотели бы, чтобы ошибки не были систематическими, чтобы модель с равной вероятностью переоценивала и недооценивала. А красная модель систематически недооценивает зависимую переменную: у нее вообще нет отрицательных ошибок, все ошибки на одной чаше весов.
Среднее остатков для синей модели \(0.25\)
students_sleep_reg %>%
  ggplot(aes(x = sleep, y = res_blue)) +
  geom_point() +
  geom_hline(yintercept = mean(students_sleep_reg$res_blue))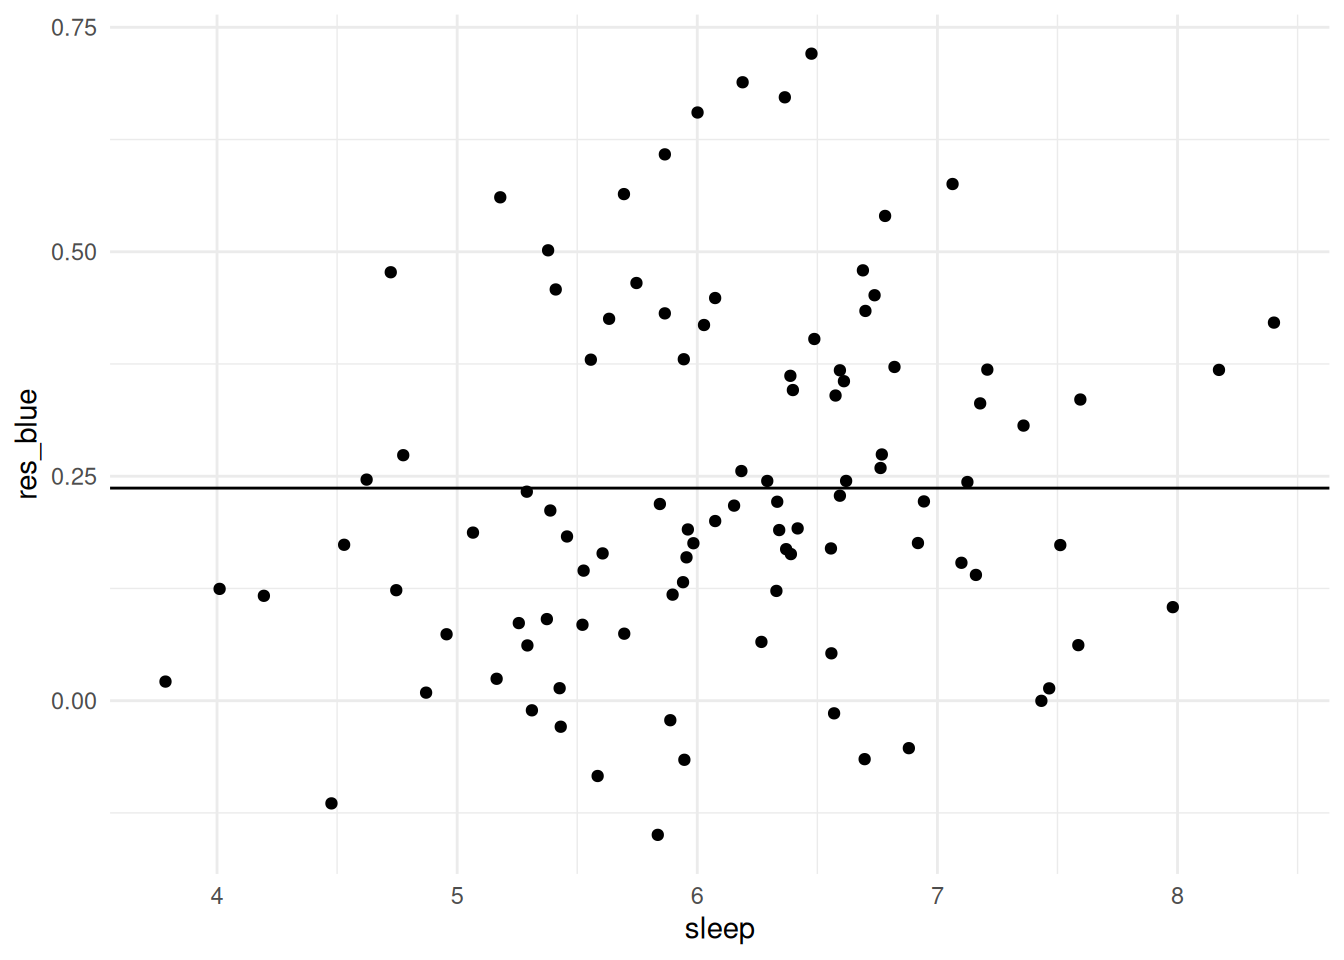
Уже лучше, но систематический сдвиг остается: большая часть ошибок все-таки положительная.
Среднее остатков пшеничной модели \(-0.1\)
students_sleep_reg %>%
  ggplot(aes(x = sleep, y = res_wheat)) +
  geom_point() +
  geom_hline(yintercept = mean(students_sleep_reg$res_wheat))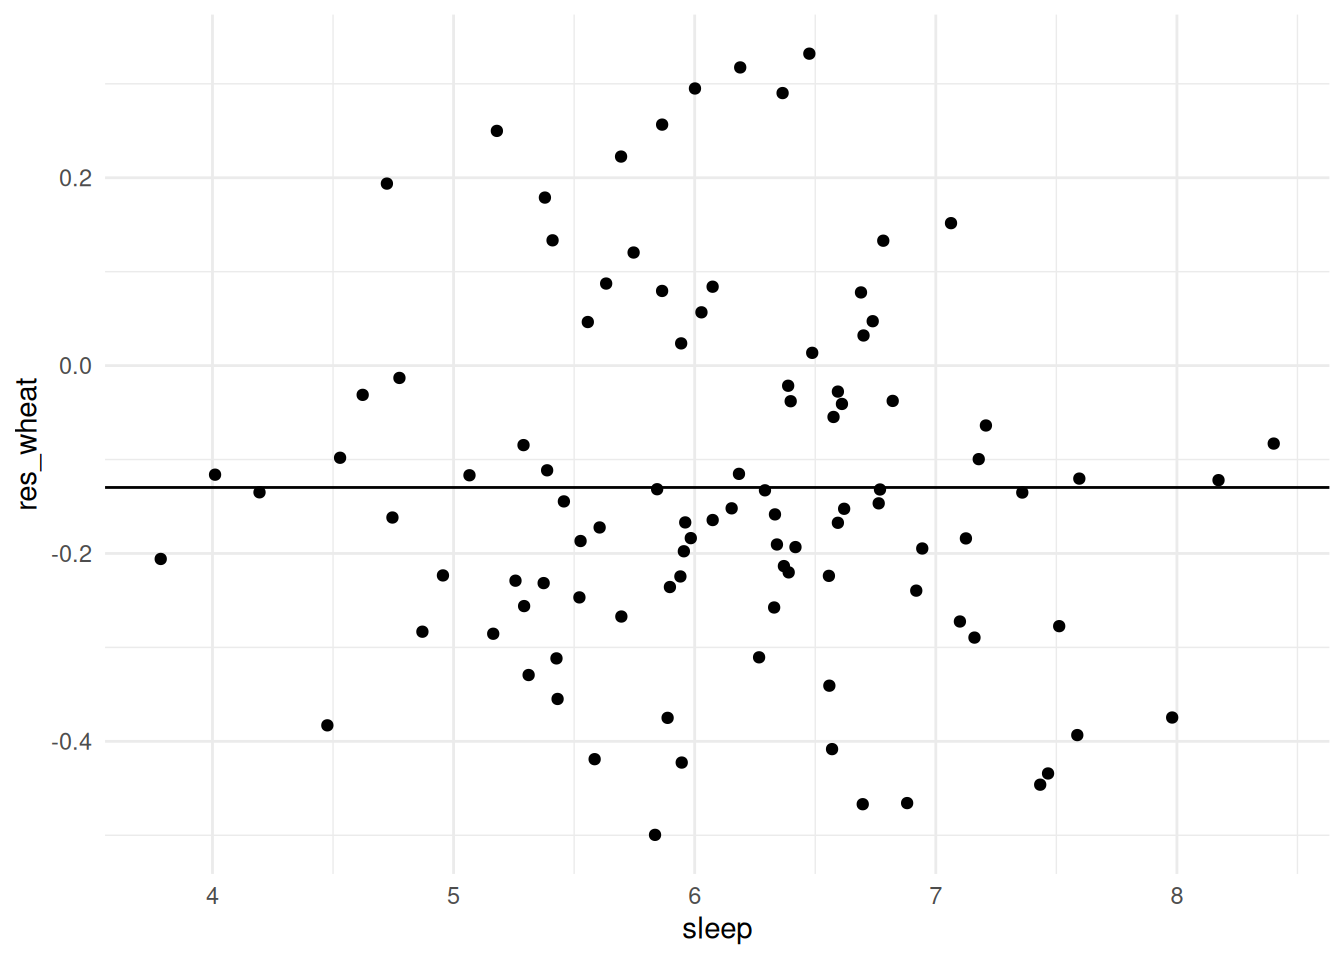
Пшеничная модель скошена в другую сторону — она переоценивает истинные значения, у нее больше ошибок на отрицательной стороне.
А вот для нашей лучшей модели среднее остатков оказывается \(0\)
students_sleep_reg %>%
  ggplot(aes(x = sleep, y = res_best)) +
  geom_point() +
  geom_hline(yintercept = mean(students_sleep_reg$res_best))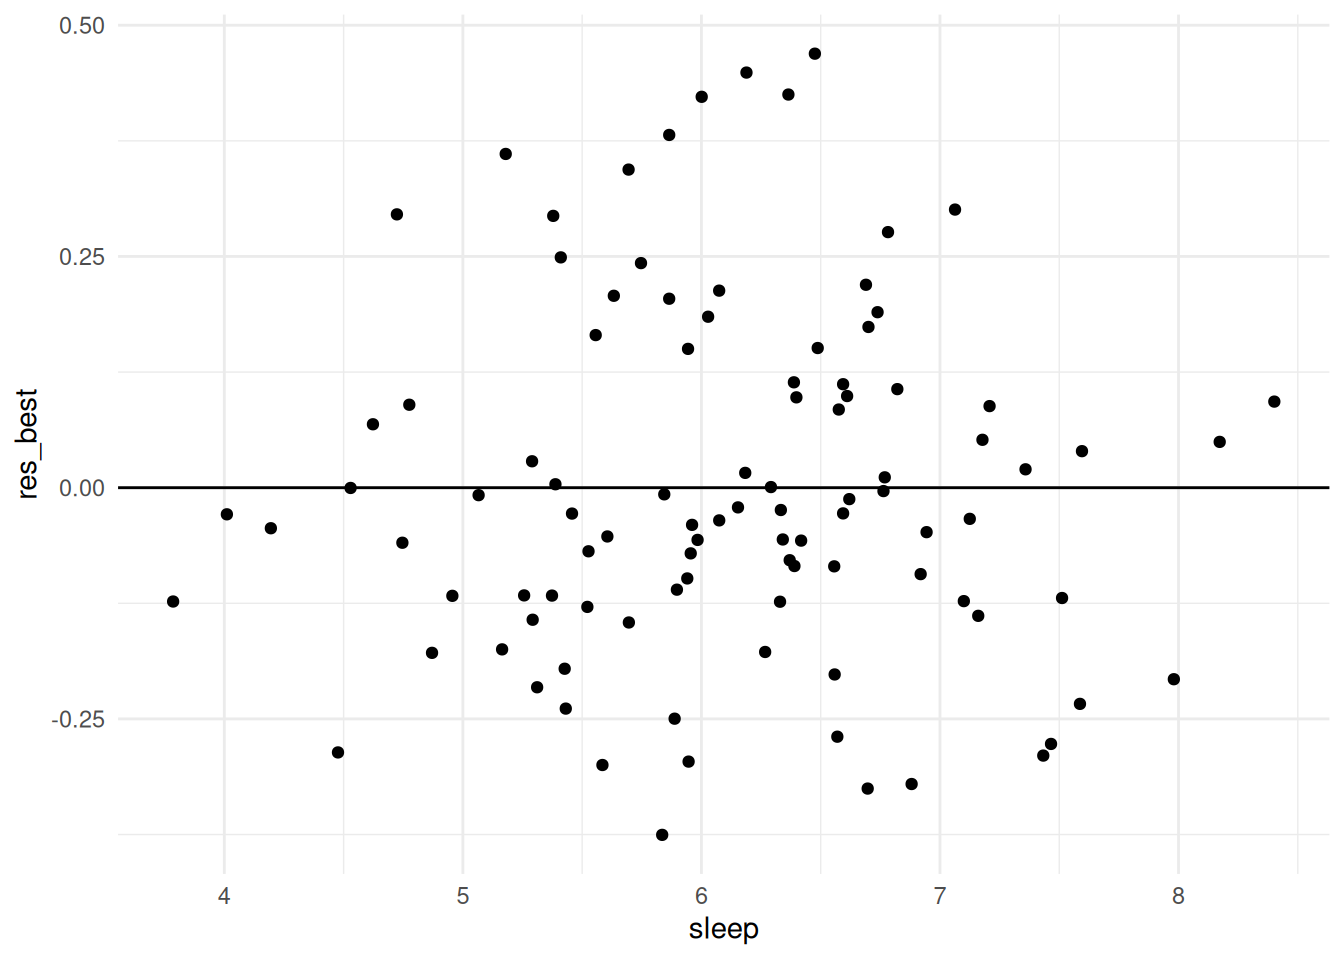
Есть ошибки отрицательные, есть положительные, но в среднем общая ошибка равна нулю — я ошибаюсь в обе стороны с равной вероятностью, без систематического уклона. Это свойство лучшей линейной модели: можно математически доказать, что у модели, минимизирующей квадратичную функцию потерь, ошибки будут сбалансированы.
Вообще, о линейной модели полезно думать как о состоящей из двух частей: есть систематическая часть — сигнал, тренд внутри данных, — и есть шум, который накладывается сверху. Когда мы проверяем качество модели, мы хотим, чтобы остатки выглядели как чистый шум: максимальный хаос, никакого тренда, никакого систематического паттерна. Если в ошибках виден паттерн, значит, в них осталась информация, которую мы не вытащили. На этом построен один из основных методов диагностики моделей: подгоняете модель — смотрите на остатки. Чуть позже я покажу, как выглядят “плохие” остатки и что с этим делать.
tibble(R_calculated = my_linear_model$residuals,
       Darkhan_calculated = students_sleep_reg$res_best) %>%
head()| R_calculated | Darkhan_calculated |
|---|---|
| -0.1166677 | -0.1166677 |
| 0.0160006 | 0.0160006 |
| -0.1748230 | -0.1748230 |
| 0.0394826 | 0.0394826 |
| -0.1233085 | -0.1233085 |
| 0.3608220 | 0.3608220 |
Интерпретация коэффициентов
Взглянем на модель в более читабельном виде. Обычно в статьях регрессионные таблицы выглядят как-то так
| Model | |
|---|---|
| (Intercept) | 0.994 (0.133)*** |
| [0.730, 1.258] | |
| sleep | 0.310 (0.022)*** |
| [0.267, 0.353] | |
| Num.Obs. | 100 |
| R2 | 0.678 |
| R2 Adj. | 0.675 |
| F | 206.738 |
| RMSE | 0.19 |
В таких таблицах приводятся названия коэффициентов, их оценки, в скобках — стандартные ошибки, звезды — уровни значимости, а иногда и доверительные интервалы для коэффициентов. Обратите внимание: нам важно, чтобы в доверительный интервал коэффициента не входил ноль — у нуля, как мы обсудили, особое концептуальное значение: коэффициент равен нулю — связи нет. Внизу таблицы — характеристики модели в целом; про \(R^2\) поговорим ниже, а RMSE — это, грубо говоря, средняя ошибка: насколько в среднем расходятся наблюдаемые и предсказанные значения.
Как использовать коэффициенты? Подставим их в уравнение — и теперь у нас есть полная спецификация модели: можно подставлять разные значения независимой переменной и смотреть предсказанные значения зависимой.
\[\begin{align*} GPA = 0.99373 + 0.30979*sleep \\ \textrm{if sleep} = 7 \\ GPA = 0.99373 + 0.30979*7 = 3.16226 \\ \textrm{if sleep} = 8 \\ GPA = 0.99373 + 0.30979*8 = 3.47205 \end{align*}\]
Разница между двумя предсказаниями как раз равна коэффициенту при независимой переменной — так мы его и интерпретируем: студенты, которые спят на час больше, имеют в среднем на \(\beta_1 \approx 0.31\) балла выше GPA.
А как интерпретировать интерсепт? Формально это значение зависимой переменной в ситуации, когда \(x = 0\), — то есть GPA, который модель предсказывает для человека, который не спит вообще. В нашей ситуации это не имеет смысла: человек не может не спать. Поэтому запомните правило: коэффициент \(\beta_1\) всегда имеет интерпретацию, а вот \(\beta_0\) может иметь, а может и не иметь — это зависит от контекста. Интерсепт осмыслен тогда, когда независимая переменная может осмысленно принимать значение 0. Например, если \(y\) — количество посетителей кафе, а \(x\) — температура на улице, интерсепт вполне интерпретируем: сколько посетителей ждать при нуле градусов. Или количество выкуренных сигарет и продолжительность жизни: человек вполне может не курить совсем. А вот, скажем, объем двигателя или цена поездки на такси нулю равняться не могут — в таких моделях интерсепт сам по себе не интерпретируется.
R-squared
И наконец, R-squared, что это? Сначала взглянем на уравнение регрессии
\[\begin{align*} Y = \beta_0 + \beta_1X + \epsilon (\sim N(\mu_{\epsilon}, \sigma^2_{\epsilon})) \\ Var(Y) = Var(\hat{Y}) + \sigma^2_{\epsilon} \\ Var(Y) = \beta_{1}^{2}Var(X) + \sigma^2_{\epsilon} \\ \end{align*}\]
Мы можем проинтерпретировать это как
- Дисперсия переменной отклика может быть разложена на дисперсию, объясняемую моделью и дисперсию остатков (т.е. шума)
- R-squared2 - это доля объясненной дисперсии в общей дисперсии переменной отклика, \((var(Y) - \sigma^2_{\epsilon})/var(Y)\). Иными словами, это процент объясненной дисперсии.
- Представьте, что вам удалось подобрать модель, которая не делает ошибок, тогда \(\sigma^2_{\epsilon} = 0\) а \(\textrm{R-squared} = 1\), что значит, что вы объяснили всю дисперсию переменной отклика
R-squared варьируется от 0 до 1: 0 означает, что модель ничего не объяснила, 1 — что объяснила все и шума не осталось. У нашей модели \(R^2 \approx 0.67\): я смог на 67% объяснить, почему варьируется GPA. Это очень хороший результат — что неудивительно, ведь я сам заложил в данные структуру, которую потом сам же с помощью регрессии и вскрыл. На реальных данных объяснить и 20% дисперсии часто считается большим успехом.
| Дисперсия Y | Дисперсия Остатков | R^2 |
|---|---|---|
| 0.114125 | 0.0367013 | 0.6784119 |
В выводе summary() рядом с \(R^2\) есть еще Adjusted R-squared. Идея такая: когда переменных больше одной, с добавлением каждой новой переменной \(R^2\) механически растет — любая добавленная переменная какую-то долю дисперсии да “объяснит”, даже если никакой связи нет. Скорректированный \(R^2\) вводит штраф за каждую новую переменную; детали расчета не принципиальны, воспринимайте adjusted \(R^2\) как более консервативную оценку качества модели — он всегда будет чуть меньше обычного.
Давайте разберем еще немного примеров с \(R^2\)
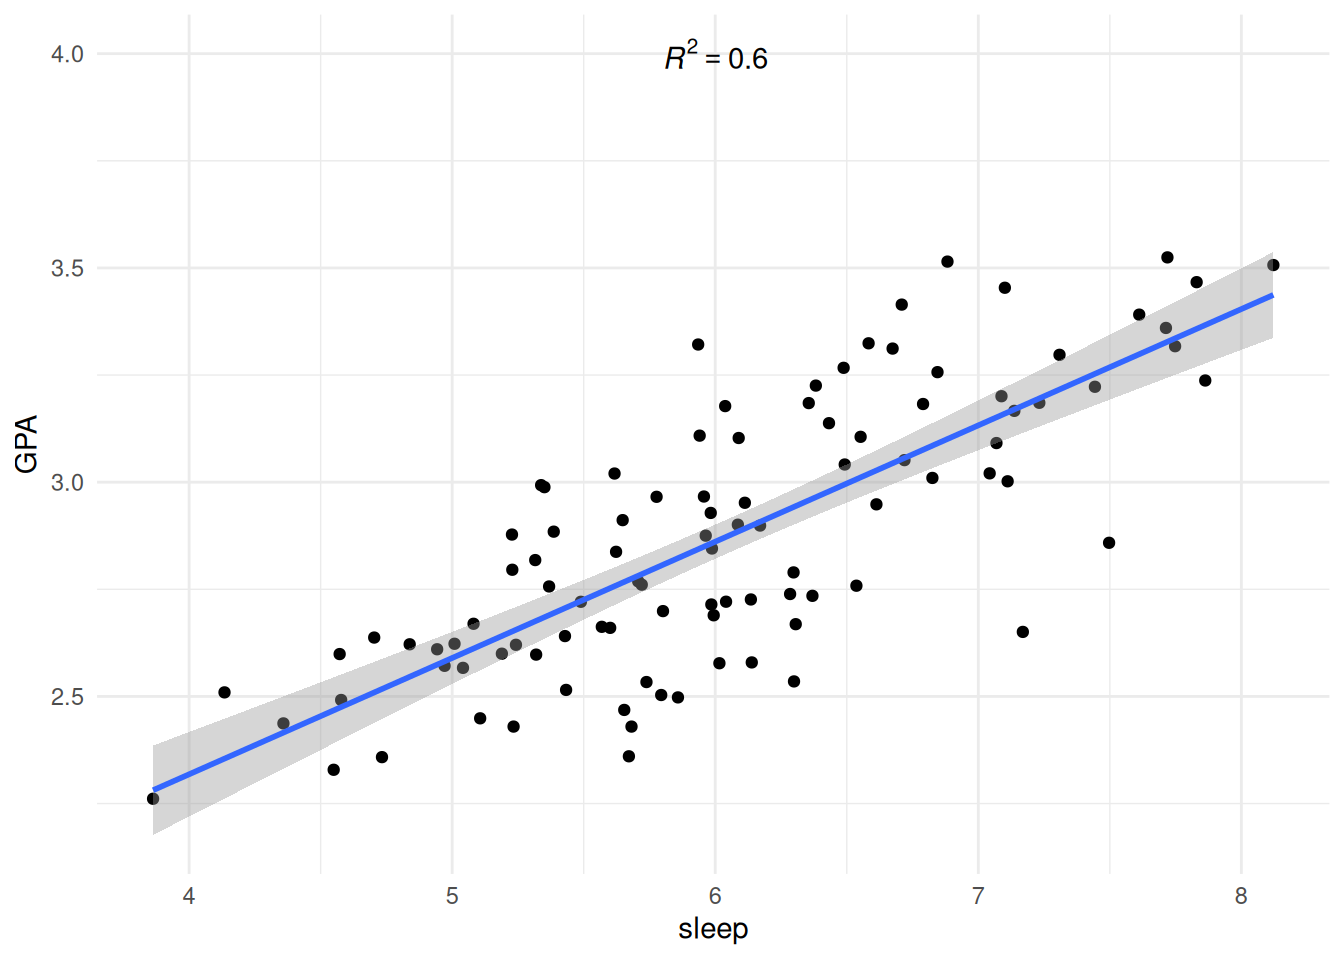
- Остатки
Warning: `fortify(<lm>)` was deprecated in ggplot2 4.0.0.
ℹ Please use `broom::augment(<lm>)` instead.
ℹ The deprecated feature was likely used in the ggplot2 package.
  Please report the issue at <https://github.com/tidyverse/ggplot2/issues>.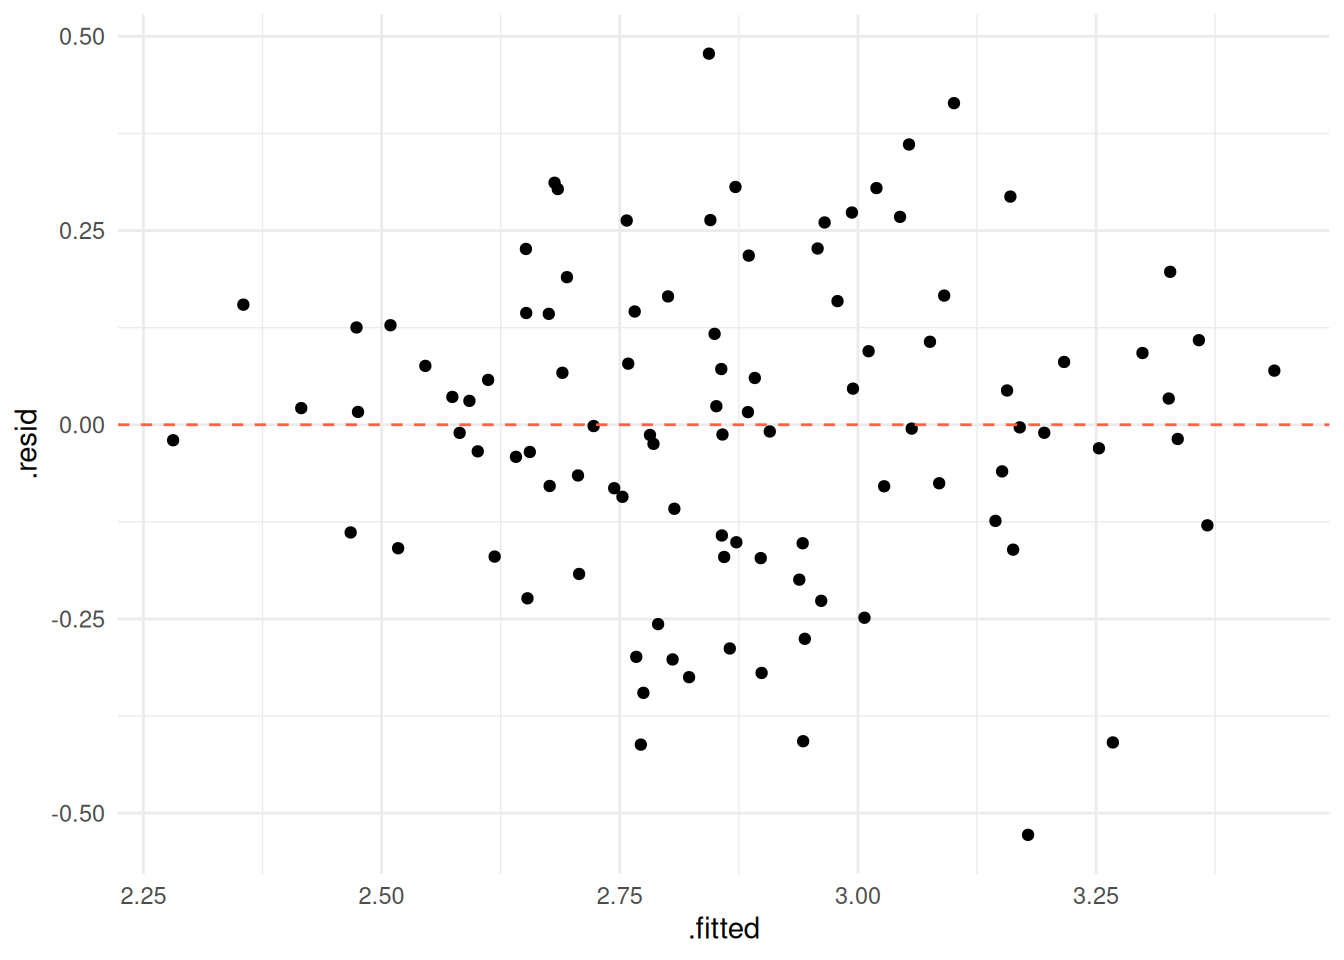
tibble(`Total Variance` = students_sleep_2$GPA_1 %>% var() %>% round(2),
       `Explained Variance` = fitr1$fitted.values %>% var() %>% round(2),
`Residual Variance` = fitr1$residuals %>% var() %>% round(2))| Total Variance | Explained Variance | Residual Variance |
|---|---|---|
| 0.1 | 0.06 | 0.04 |
Теперь та же модель, та же систематическая часть, но я увеличил уровень шума вокруг тренда. \(R^2\) падает до 0.2: разброс вокруг линии больше, доля объясненной дисперсии меньше.
`geom_smooth()` using formula = 'y ~ x'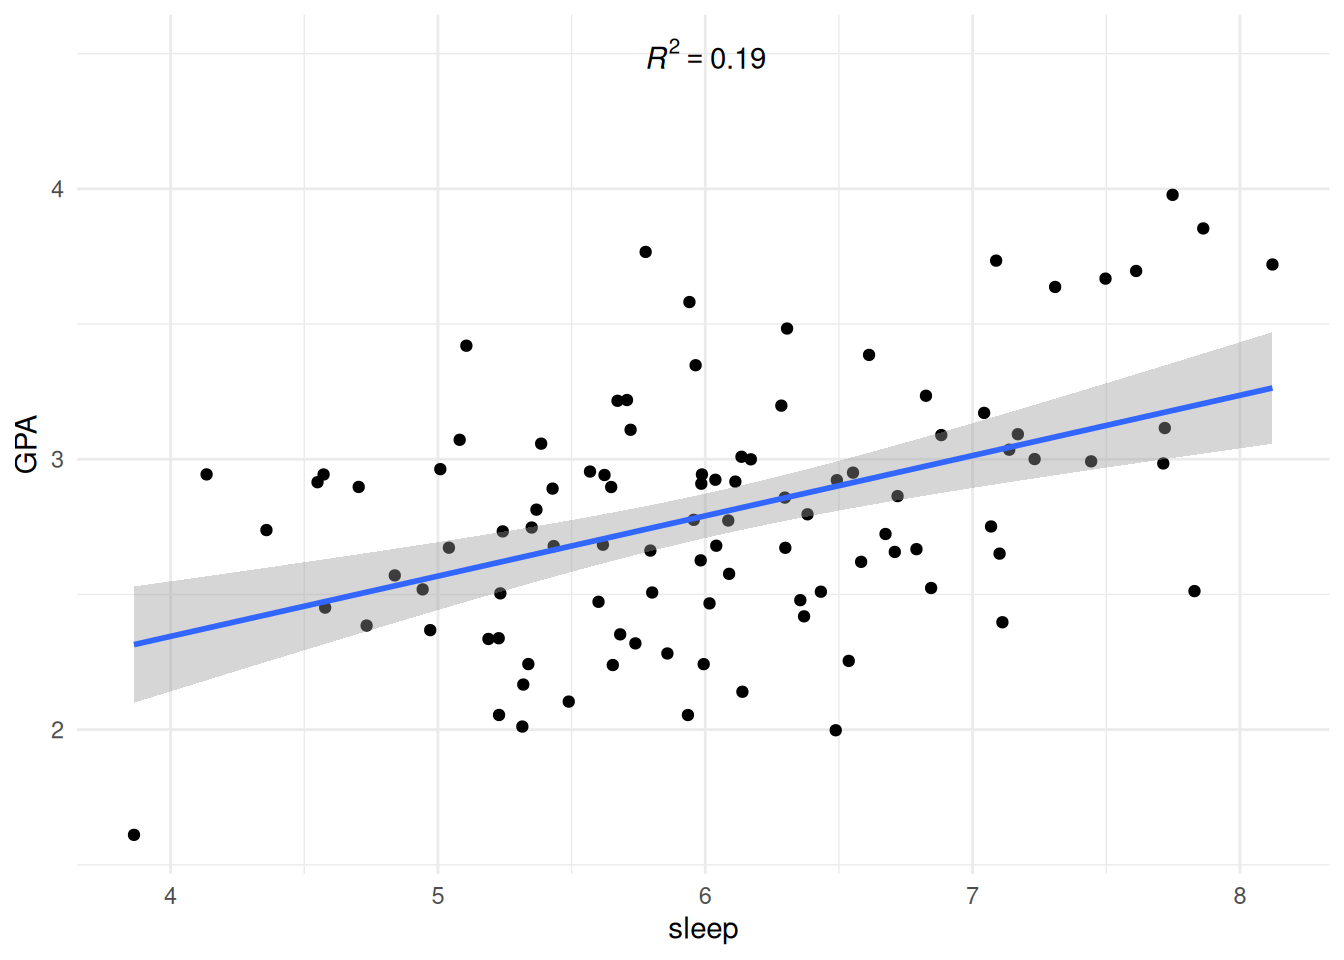
- Остатки — теперь они разбросаны в пределах от \(-1\) до \(1\): шум просто увеличился. \(R^2\), по сути, показывает, насколько плотно данные прижаты к систематической части.
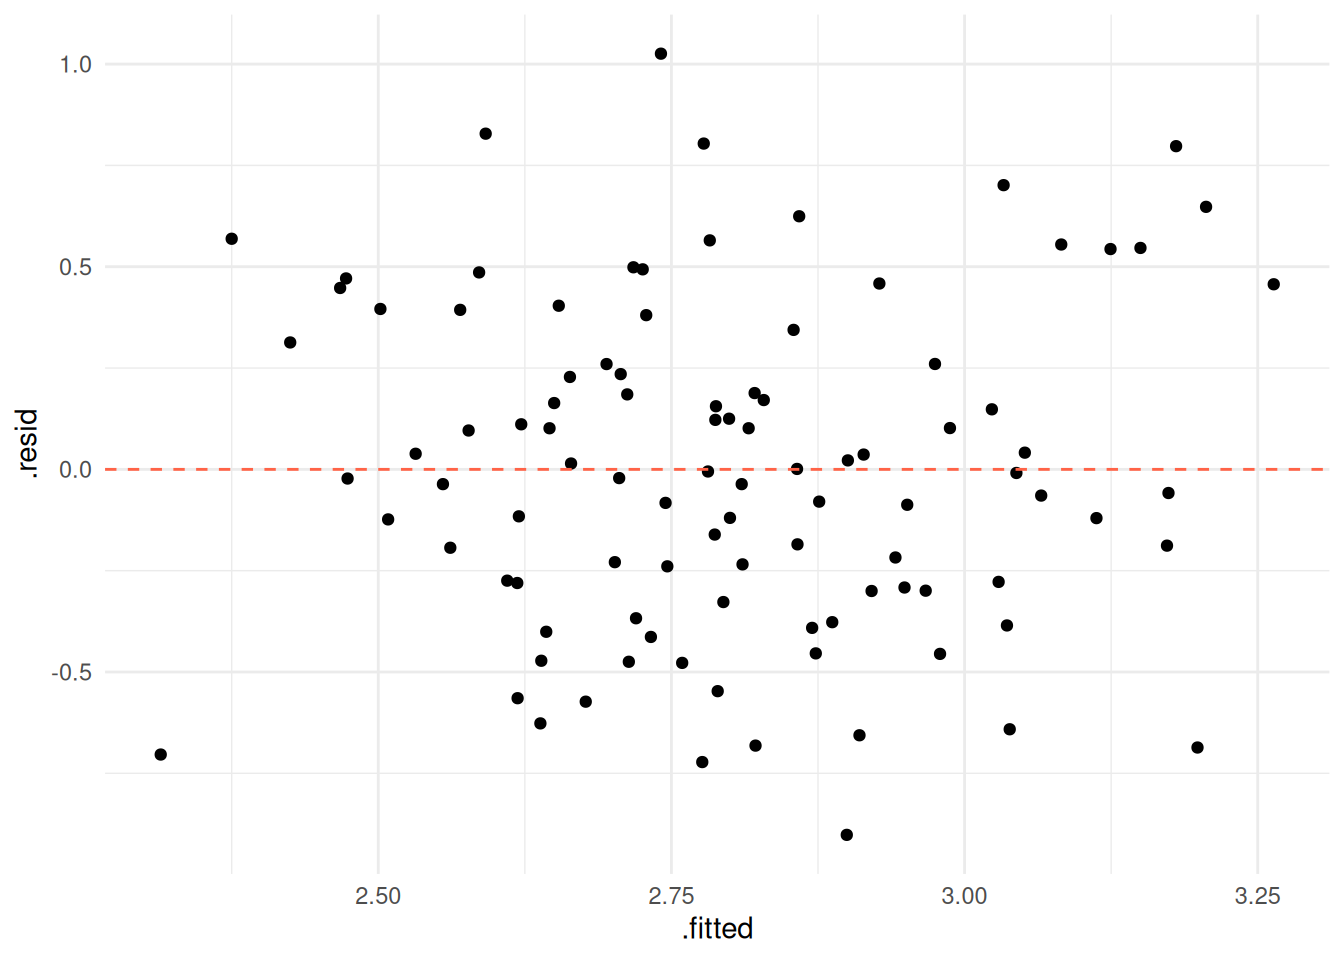
| Total Variance | Explained Variance | Residual Variance |
|---|---|---|
| 0.21 | 0.04 | 0.17 |
И, наконец, вариант с \(R^2 = 0.01\). В данных по-прежнему есть тренд — я его сам заложил, переменные точно связаны, — но шума поверх этой связи так много, что объясненной дисперсии остается 1%, а остальные 99% — шум.
`geom_smooth()` using formula = 'y ~ x'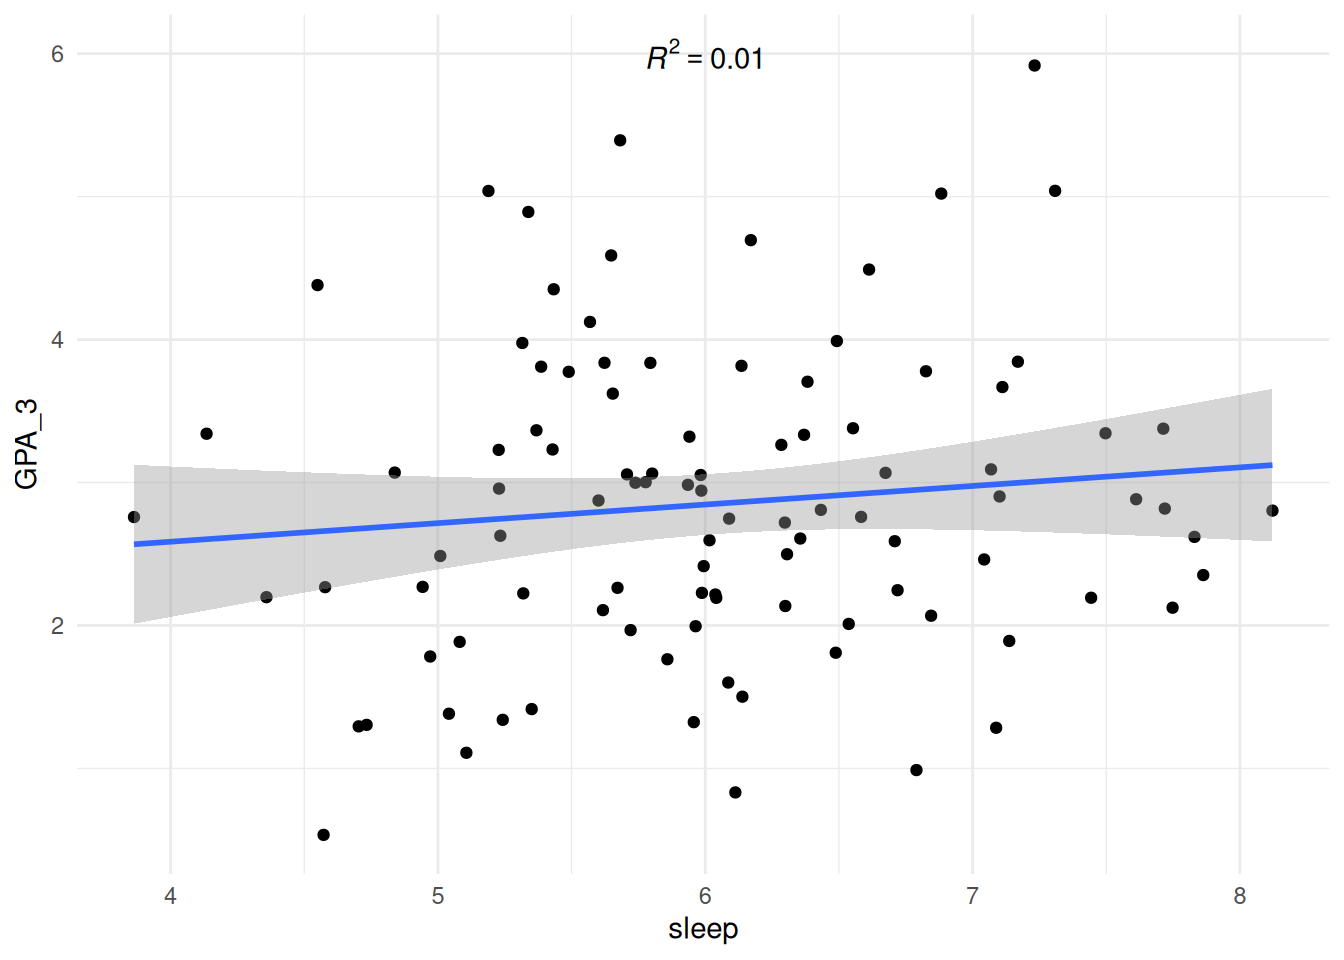
- Остатки
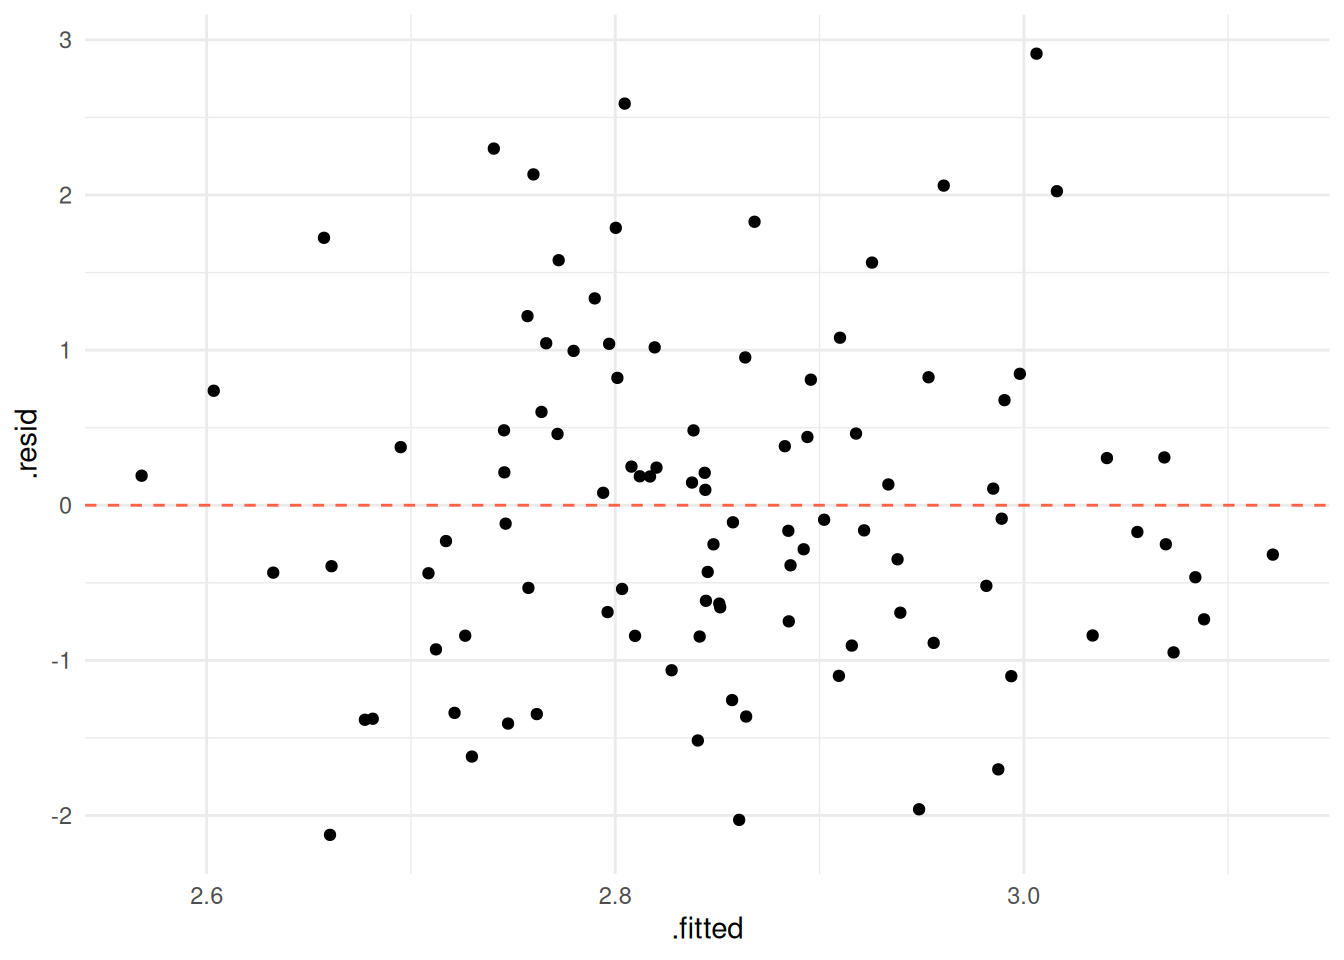
| Total Variance | Explained Variance | Residual Variance |
|---|---|---|
| 1.146 | 0.014 | 1.132 |
Линейная регрессия: допущения
В примерах выше, у нас были данные, которые мы попытались описать линейной моделью. Для этого, на самом деле, мы сделали несколько неявных допущений. Давайте разберем их подробнее.
Линейность: Мы явным образом предположили, что переменная отклика зависит от линейной функции объясняющей переменной. То есть когда \(X\) изменяется на единицу, \(Y\) всегда изменяется на одно и то же число, которое мы захватываем коэффициентом при независимой переменной.
Нормальность остатков: Мы также посчитали, что остатки/ошибки имеют нормальное распределение. То есть мы предполагаем, что модель делает ошибки, но эти ошибки симметричны и в целом уравновешивают друг-друга
Постоянная дисперсия3: Мы также приняли, что дисперсия переменной отклика не изменяется для разных значений объясняющей переменной (то есть ошибки, всегда примерно одни и те же). Нарушается это допущение, когда для одних значений независимой переменной мы делаем маленькие ошибки, а для других — большие.
Независимые наблюдения: И наконец, мы посчитали, что наблюдения за переменными не зависят друг от друга. Примером, где это допущение нарушается, могут быть временные ряды. Например, зависимость температуры и времени дня. Если в 15:00 температура была 3˚C, то в 16:00 она будет недалеко от трех.
Что происходит, когда условия не выполняются
Давайте посмотрим, что происходит, когда мы пытаемся подогнать линейную регрессию в условиях, когда не все допущения выполняются. Начнем с линейности.
- Допустим мы рассматриваем зависимость между стрессом,
stress, и успеваемостью,performance. Данные опять синтетические, и я заложил в них нелинейную зависимость: совсем без стресса успеваемость не очень, слишком много стресса — тоже плохо, а оптимальный уровень где-то посередине.
set.seed(123)
temp_df <-
  tibble(stress = rnorm(1000, mean = 6, 1),
         performance = 13 - ((stress - 5)^2) + rnorm(1000, mean = 0, sd = 2)) %>%
  mutate(performance =
           10*(performance - min(performance))/(max(performance) - min(performance) + 0.5))
p_ex2 <-
  temp_df %>%
  ggplot(aes(x = stress, y = performance)) +
  geom_point() +
  labs(x = "Уровень стресса", y = "Успеваемость")
p_ex2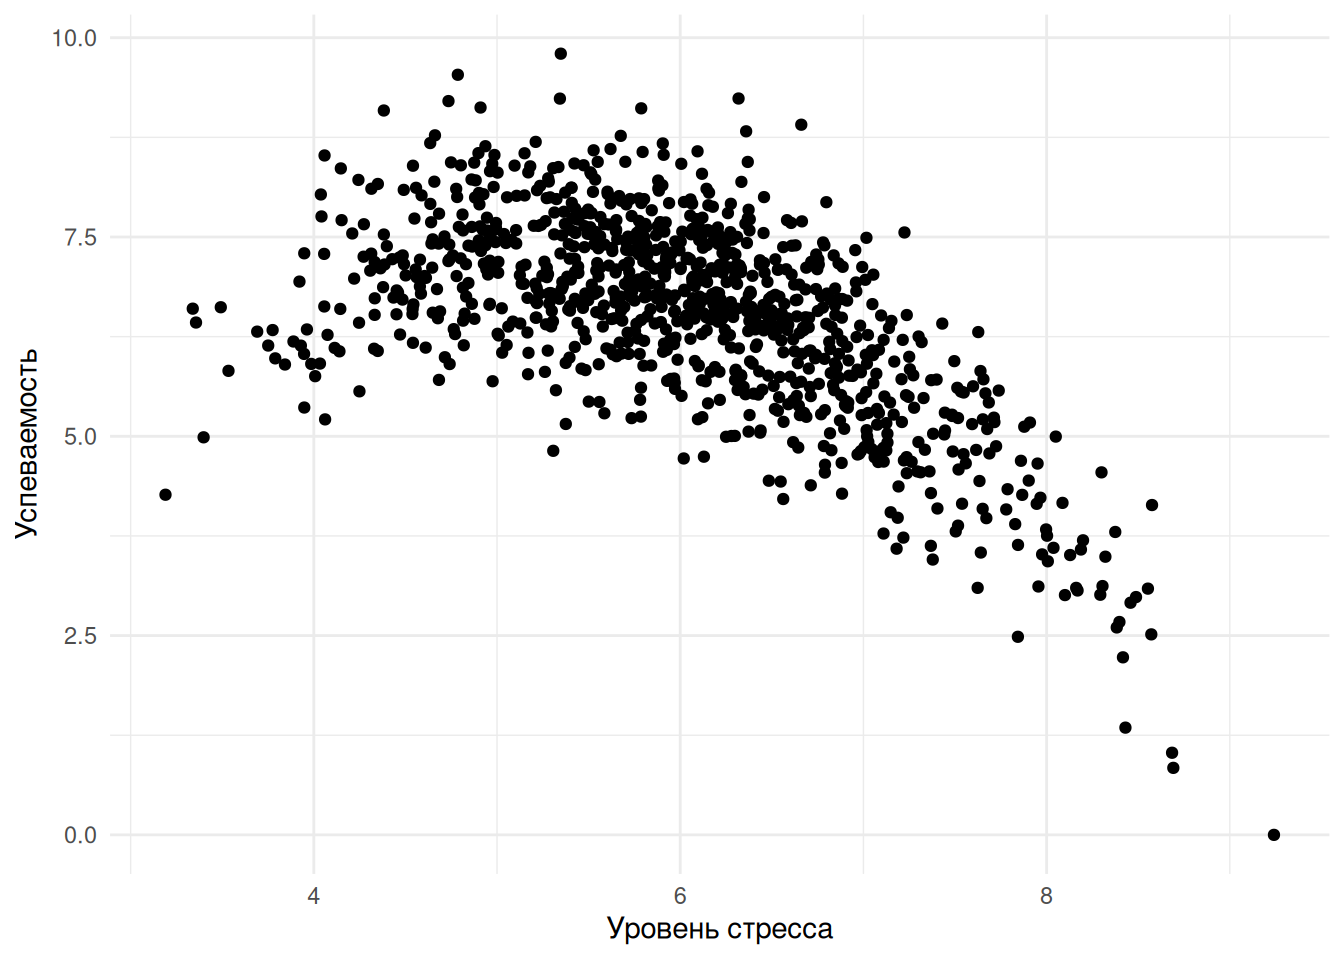
- Попробуем описать данные прямой линией
p_ex2 +
  geom_smooth(method = "lm")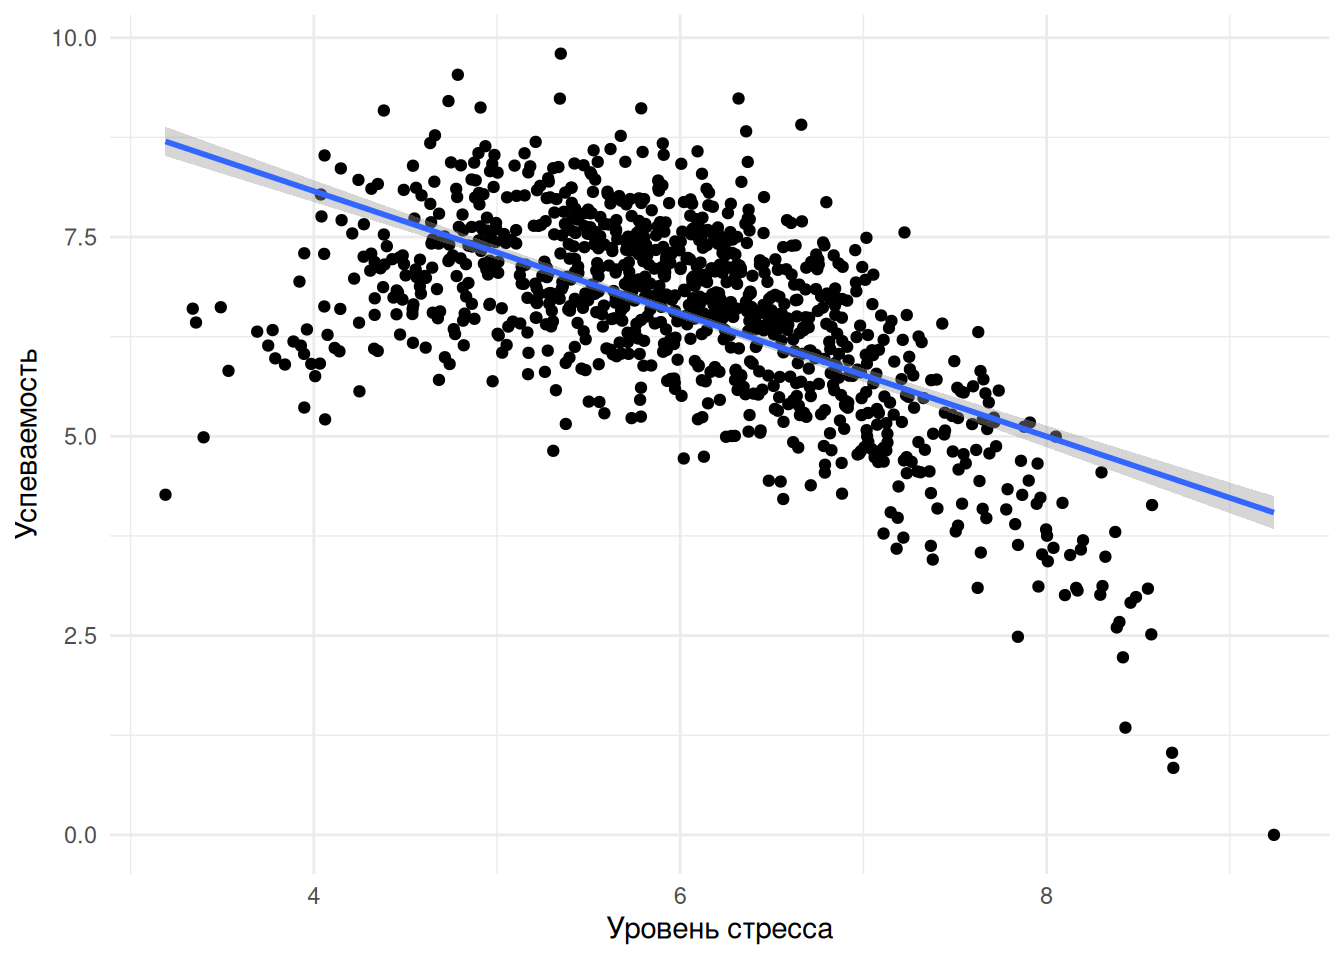
- Что-то явно не так!
Что именно? Посмотрите, в каком диапазоне независимой переменной модель предсказывает относительно хорошо, а в каком — плохо. Посередине (уровень стресса около 6) модель неплохо показывает центр разброса. Но на краях спектра начинаются проблемы: для низкого стресса (около 3) модель ожидает успеваемость около 8, а реальные значения в этом диапазоне систематически ниже — модель систематически переоценивает. То же самое на другом конце. Систематическая ошибка в одну сторону — это ровно то, чего мы не хотим.
Проблема еще и в том, что если попросить R подогнать эту модель, он ничего не спросит и не скажет — просто выдаст результат. И на первый взгляд все выглядит прекрасно:
- Скажем, что несмотря на дурные предчувствия, мы все же “подогнали” модель под данные
- Мы смотрим результат и все казалось бы выглядит просто прекрасно. Коэффициенты значимы, R-squared равен \(0.37\). Вау! Мы взяли да объяснили больше чем треть дисперсии!
fit1 <-
  lm(performance ~ stress, data = temp_df)
summary(fit1)
Call:
lm(formula = performance ~ stress, data = temp_df)

Residuals:
    Min      1Q  Median      3Q     Max
-4.4317 -0.6240  0.0841  0.6980  2.9457

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept) 11.15337    0.19052   58.54   <2e-16 ***
stress      -0.76947    0.03125  -24.62   <2e-16 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 0.9794 on 998 degrees of freedom
Multiple R-squared:  0.378, Adjusted R-squared:  0.3773
F-statistic: 606.4 on 1 and 998 DF, p-value: < 2.2e-16- Не так быстро! Взглянем на остатки!
ggplot(fit1, aes(x = .fitted, y = .resid)) +
  geom_point() +
  geom_hline(yintercept = 0, linetype = "dashed", color = "red")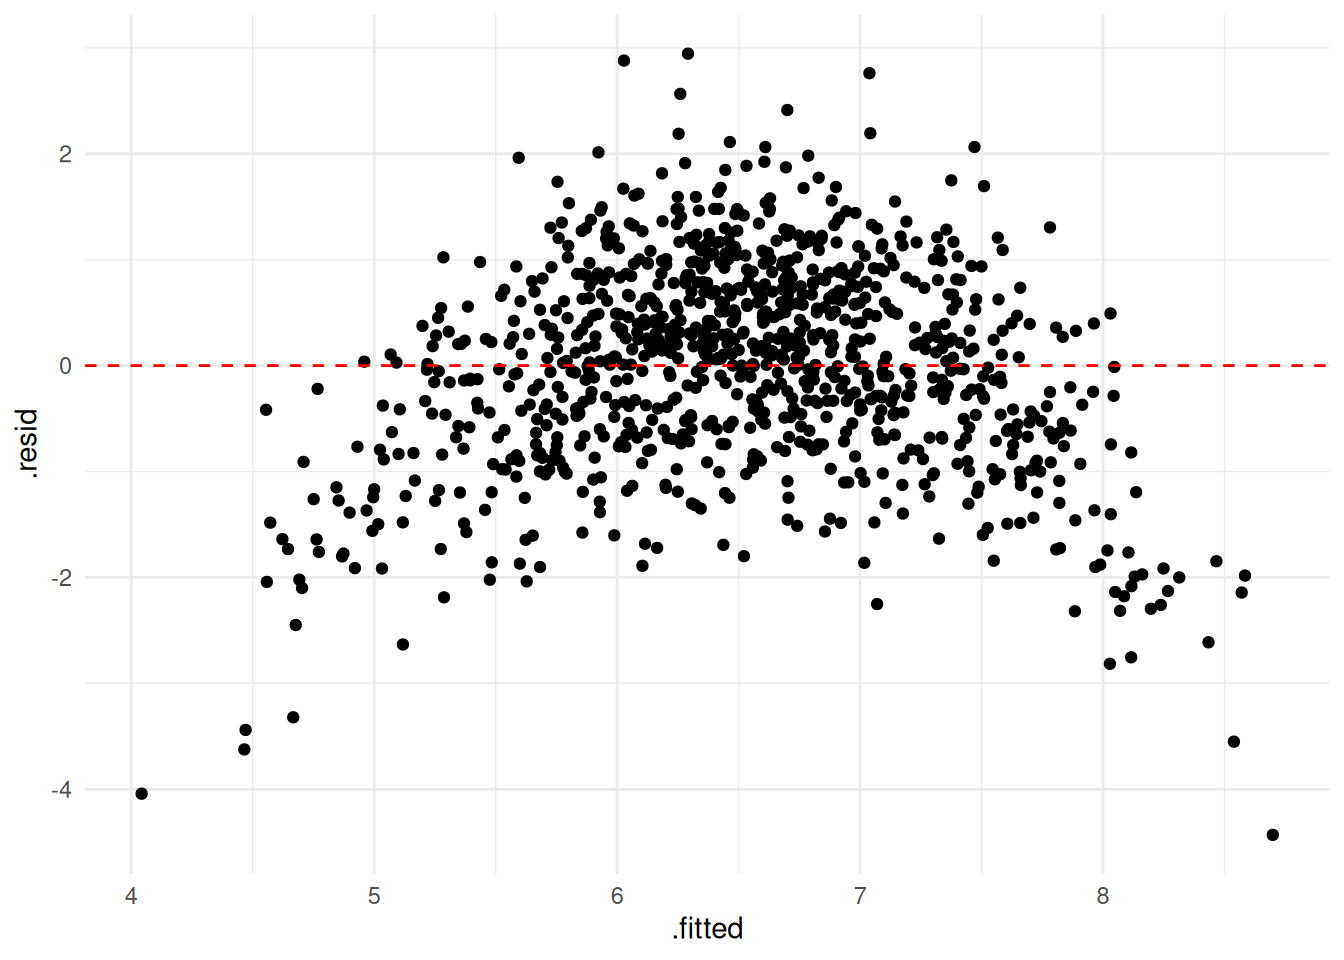
- И что же остатки поведали нам?
- Наша модель систематически переоценивает (overestimate) успеваемость людей с низким или высоким уровнем стресса
- А еще она недооценивает (underestimate) успеваемость людей, со средним уровнем стресса
В остатках есть паттерн, а это красный флаг. Мораль: после того как вы подогнали модель, всегда проверяйте остатки. В идеале вы хотите видеть полностью случайную диаграмму рассеяния вокруг нуля; если видите что-то такое, как выше, — нужно внимательно посмотреть на данные и понять, откуда берется нелинейность.
Нормальность остатков
Как еще можно тестировать свою модель? У нас есть допущение о том, что остатки берутся из нормального распределения. Можно банально построить гистограмму или плотность распределения остатков и сравнить с нормальным распределением.
- Если мы взглянем на распределение остатков модели из примера выше, то можем обнаружить, что оно скошено влево (left-skewed)
ggplot(data = fit1, aes(x = .resid)) +
  geom_blank() +
  geom_histogram(aes(y = ..density..), color = "grey50",
                 bins = 30) +
  geom_density(color = "steelblue") +
  xlab("Residuals") +
  stat_function(fun = dnorm, args = c(mean = 0, sd = sd(fit1$residuals)),
                color = "tomato")
Warning: The dot-dot notation (`..density..`) was deprecated in ggplot2 3.4.0.
ℹ Please use `after_stat(density)` instead.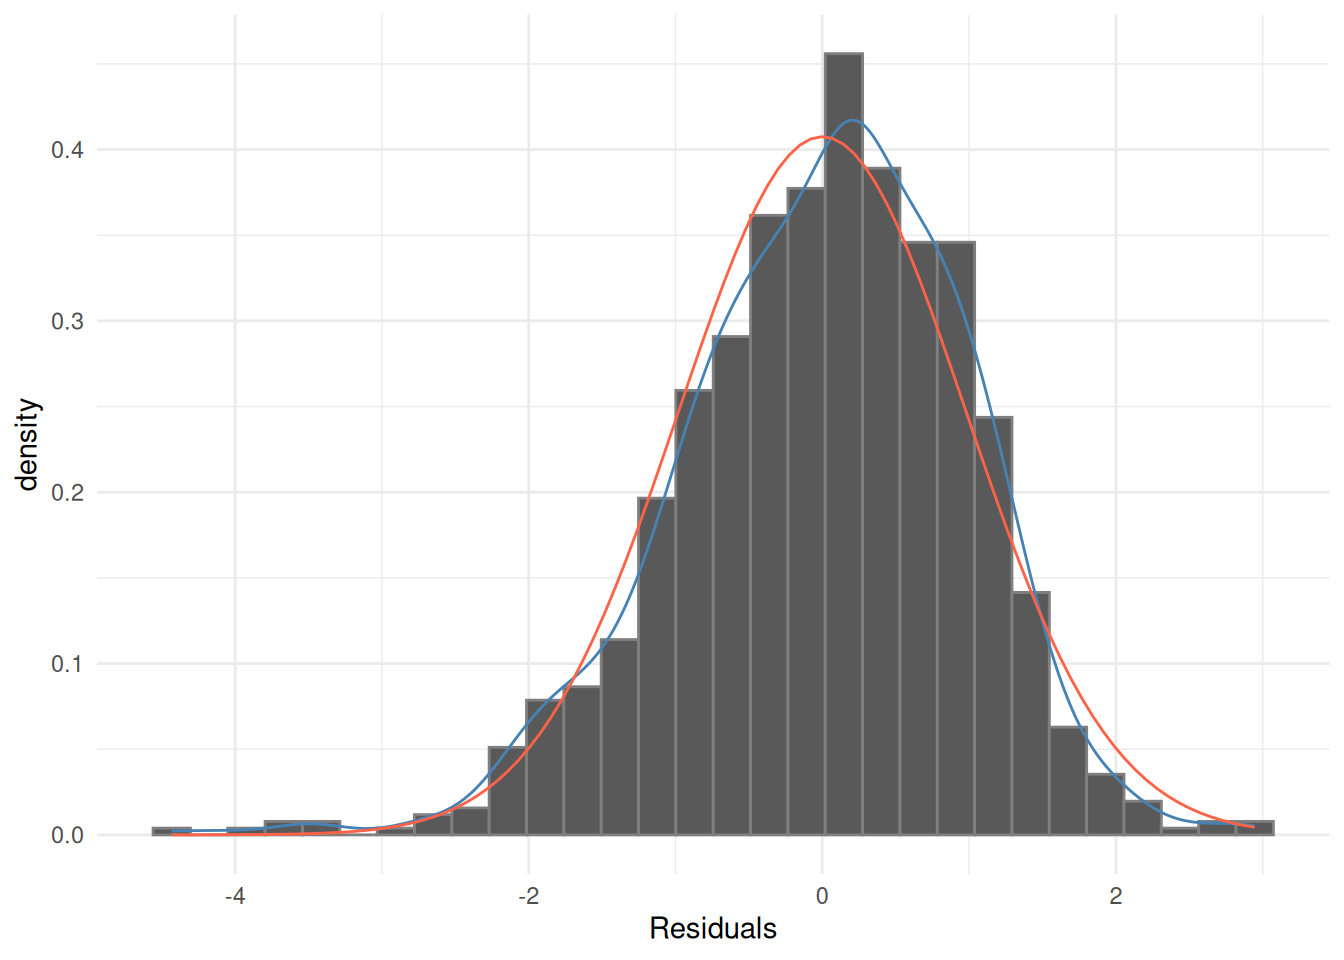
Синяя линия — эмпирическая плотность распределения остатков, красная — теоретическая плотность нормального распределения с той же дисперсией. В теории эти две линии должны совпадать; у нас же видно расхождение: эмпирическое распределение скошено, у него более тяжелый левый хвост. Если допущение нормальности остатков не выполняется, к результатам регрессии стоит относиться с изрядным подозрением.
- Наконец, давайте попробуем новую вещь, которая называется Q-Q plot.
Q-Q plot - это графический метод сравнения двух распределений путем построения их квантилей друг против друга. Точка на графике соответствует одному из квантилей второго распределения, построенного против того же квантиля первого распределения. (Квантиль, напомним, — это точка, которая делит распределение в заданной пропорции: например, ниже 99-го квантиля лежит 99% данных. С квантилями мы уже сталкивались, когда вводили квартили и интерквартильный размах.)
ggplot(data = fit1, aes(sample = .resid)) +
  stat_qq() +
  stat_qq_line(color = "red") +
  labs(x = "Нормальные Квантили", y = "Квантили Остатков")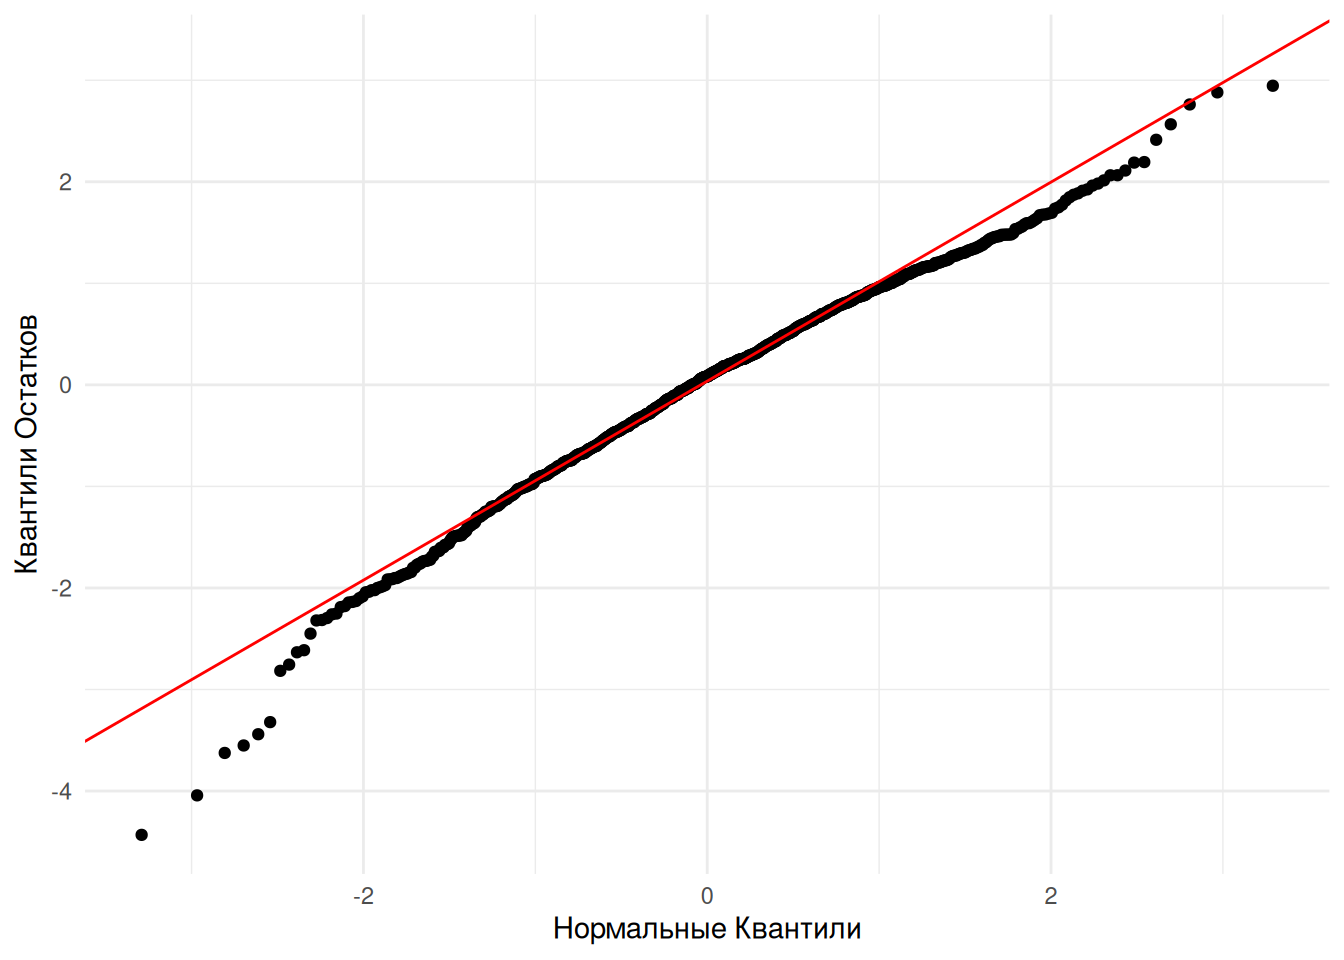
Например, на этом графике мы сравниваем распределение остатков с теоретическим нормальным распределением с таким же центром и дисперсией. Мы видим, что у остатков тяжелее “левый хвост” - отдельные наблюдения уходят аж за 4 стандартных отклонения от среднего. Если бы наши остатки были нормально распределены, то точки лежали бы на прямой.
Другой пример — ситуация, в которой остатки случайны, но сильно скошены в одну сторону. Смоделируем шум с распределением Вейбулла: центр на нуле, но тяжелый правый хвост — остатки имеют склонность принимать очень большие значения, но только с одной стороны.
tibble(x = rweibull(100, shape = 1) - 1) %>%
  ggplot(aes(x = x)) +
  geom_histogram(bins = 30, color = "grey")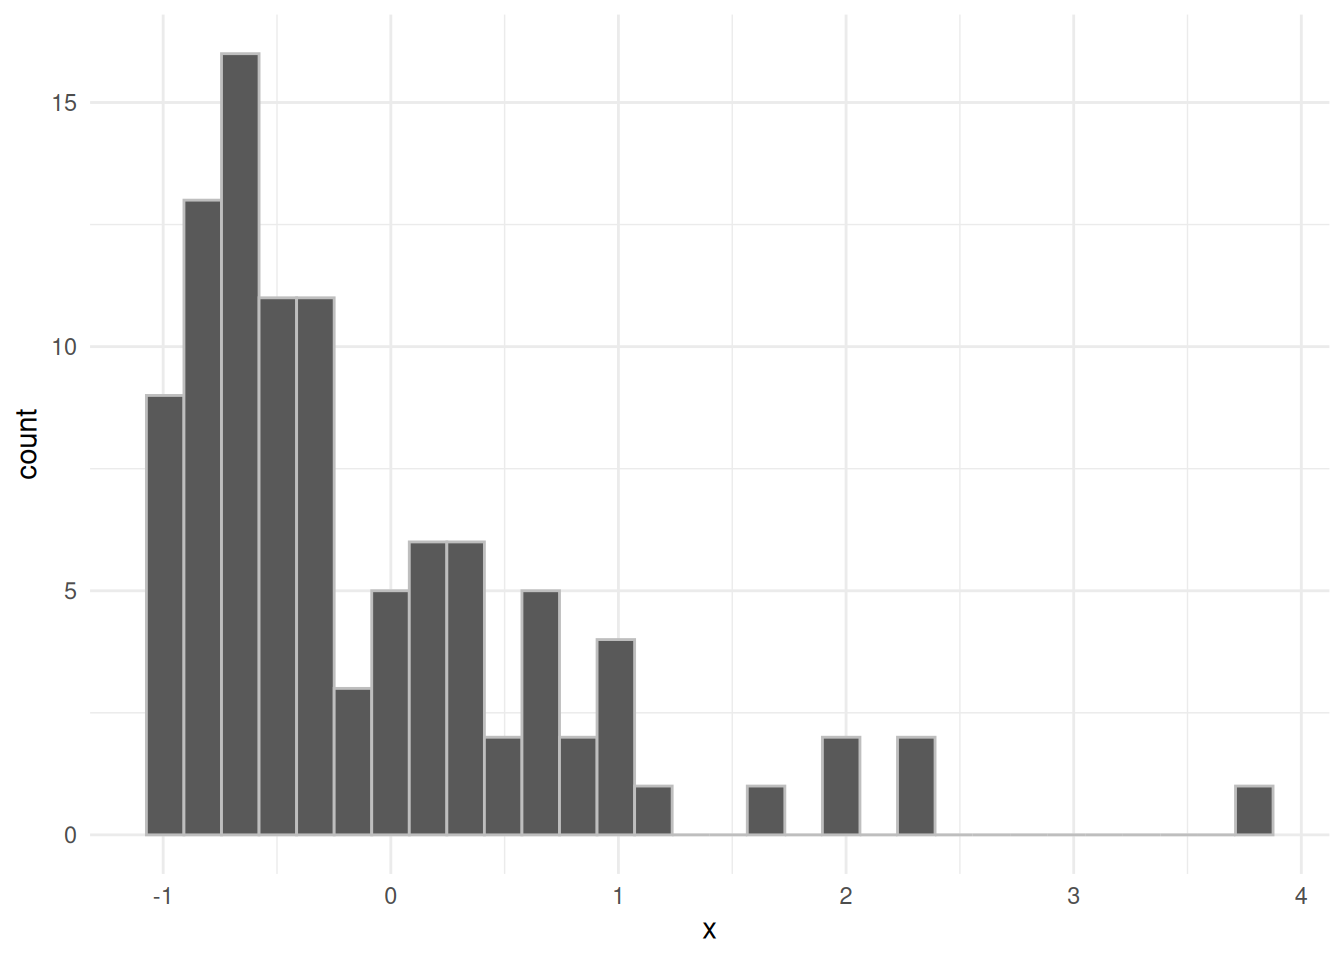
set.seed(1212)
df <- tibble(
  x = runif(100, -1, 1),
  error = rweibull(100, shape = 1) - 1,
  y = 1*x + error)
fit <-
  df %>%
  lm(data = ., y ~ x)
summary(fit)
Call:
lm(formula = y ~ x, data = .)

Residuals:
    Min      1Q  Median      3Q     Max
-1.1496 -0.7185 -0.1893  0.3811  4.2376

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept)  0.16465    0.09833   1.674   0.0972 .
x            1.23180    0.17224   7.152 1.56e-10 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 0.9755 on 98 degrees of freedom
Multiple R-squared:  0.3429,    Adjusted R-squared:  0.3362
F-statistic: 51.15 on 1 and 98 DF,  p-value: 1.559e-10
R опять все сделает без вопросов: коэффициент при \(x\) значимый, объясненная дисперсия приличная — 34%. Но посмотрите на данные: ошибки в одну сторону идут плотно к линии тренда, а в другую — уходят очень далеко. Когда ошибки ненормальны, результатам линейной регрессии нельзя доверять в полной мере.
df %>%
  ggplot(aes(x = x, y = y)) +
  geom_point() +
  geom_smooth(method = "lm")
`geom_smooth()` using formula = 'y ~ x'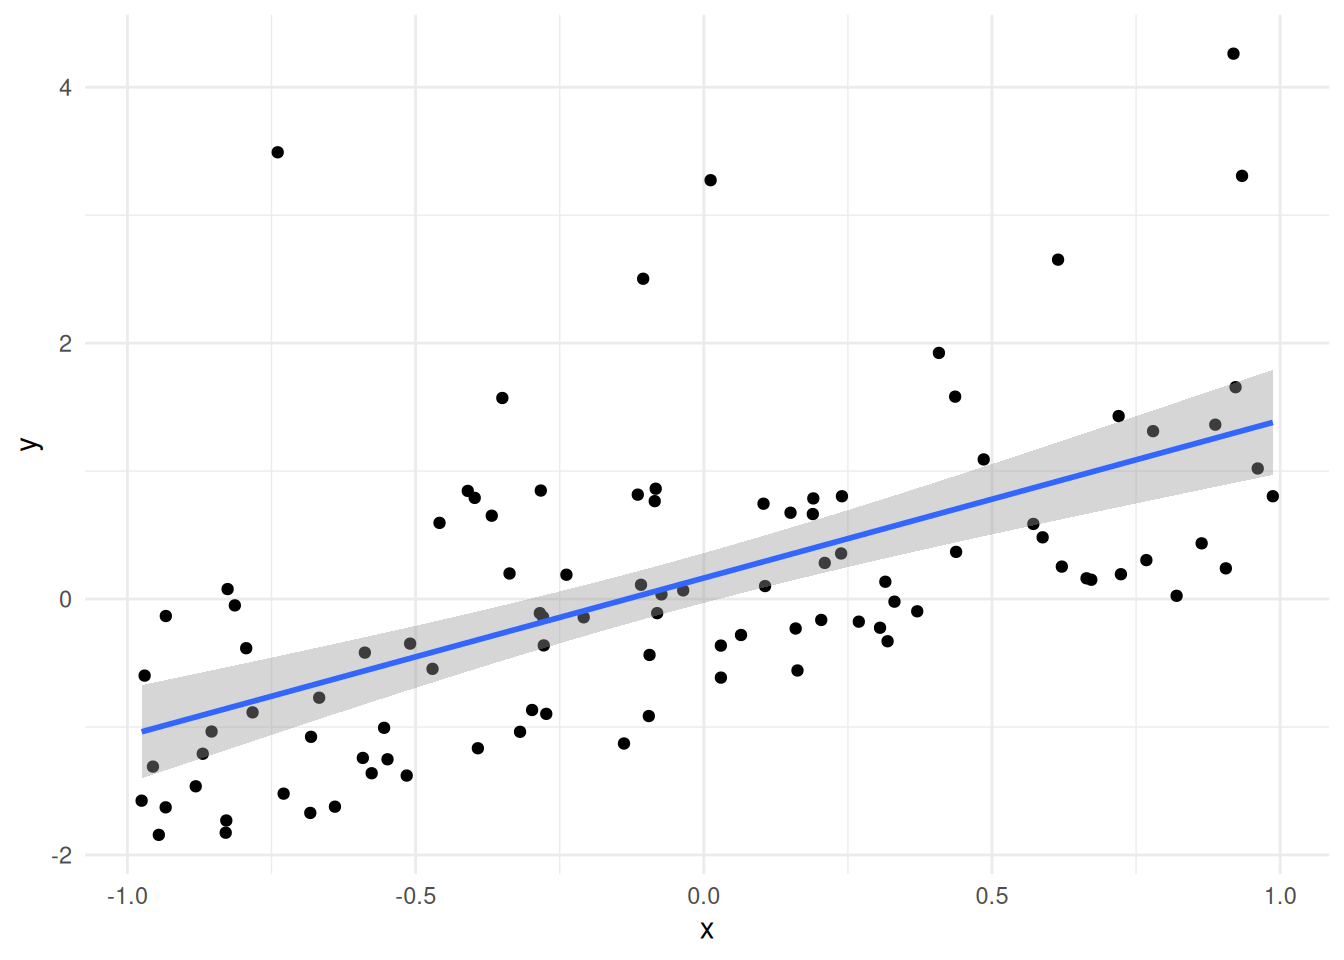
Упражнения: регрессия на данных PISA
Давайте потренируемся: я буду давать регрессии, а вы будете интерпретировать их. Данные возьмем из PISA 2018 для Казахстана. В датасете куча переменных: код страны, ID школы, язык тестирования, вопросы о том, насколько семья ученика обеспечена ресурсами (есть ли у ребенка свой стол, своя комната, тихое место для занятий, компьютер), вопросы о богатстве семьи (сколько дома телевизоров, машин) и так далее.
pisa_kz <-
  read_rds("data/processed/pisa_2018_kz_jp.rds") %>%
  filter(CNT == "Kazakhstan")
pisa_kz %>% head()| CNT | LANGTEST_COG | Gender | ESCS | WEALTH | TMINS | PV1MATH | PV1READ | PV1SCIE |
|---|---|---|---|---|---|---|---|---|
| Kazakhstan | Kazakh | Male | -1.3482 | -1.9957 | 1620 | 414.520 | 396.672 | 348.232 |
| Kazakhstan | Kazakh | Male | -0.6018 | -0.8302 | 2240 | 353.766 | 308.628 | 371.455 |
| Kazakhstan | Kazakh | Female | -1.1250 | NA | NA | 350.357 | 414.048 | 335.833 |
| Kazakhstan | Kazakh | Male | -0.6677 | -1.8445 | NA | 275.045 | 268.966 | 207.007 |
| Kazakhstan | Kazakh | Female | -1.1238 | -1.9130 | 1530 | 250.600 | 411.113 | 366.879 |
| Kazakhstan | Kazakh | Male | -1.4306 | -1.2780 | NA | 408.725 | 361.051 | 334.163 |
- Посмотрим в кодбук
Rows: 60 Columns: 2
── Column specification ────────────────────────────────────────────────────────
Delimiter: ","
chr (2): name, value

ℹ Use `spec()` to retrieve the full column specification for this data.
ℹ Specify the column types or set `show_col_types = FALSE` to quiet this message.| name | value |
|---|---|
| CNT | Country code 3-character |
| CNTSCHID | Intl. School ID |
| LANGTEST_COG | Language of Assessment |
| ST011Q01TA | In your home: A desk to study at |
| ST011Q02TA | In your home: A room of your own |
| ST011Q03TA | In your home: A quiet place to study |
| ST011Q04TA | In your home: A computer you can use for school work |
| ST011Q05TA | In your home: Educational software |
| ST011Q06TA | In your home: A link to the Internet |
| ST011Q07TA | In your home: Classic literature (e.g. |
| ST019AQ01T | In what country were you and your parents born? You |
| ST012Q01TA | How many in your home: Televisions |
| ST012Q02TA | How many in your home: Cars |
| ST012Q03TA | How many in your home: Rooms with a bath or shower |
| ST012Q05NA | How many in your home: |
| ST012Q06NA | How many in your home: Computers (desktop computer, portable laptop, or notebook) |
| ST012Q07NA | How many in your home: |
| ST012Q08NA | How many in your home: E-book readers (e.g. |
| ST012Q09NA | How many in your home: Musical instruments (e.g. guitar, piano) |
| ST013Q01TA | How many books are there in your home? |
| ST097Q01TA | How often during |
| ST097Q02TA | How often during |
| ST097Q03TA | How often during |
| ST097Q04TA | How often during |
| ST097Q05TA | How often during |
| ST100Q01TA | How often during |
| ST100Q02TA | How often during |
| ST100Q03TA | How often during |
| ST100Q04TA | How often during |
| ST102Q01TA | How often during |
| ST102Q02TA | How often during |
| ST102Q03TA | How often during |
| ST102Q04TA | How often during |
| ST158Q01HA | Taught at school: How to use keywords when using a search engine such as <Google©>, <Yahoo©>, etc. |
| ST158Q02HA | Taught at school: How to decide whether to trust information from the Internet |
| ST158Q03HA | Taught at school: How to compare different web pages and decide what information is more relevant for your school work |
| ST158Q04HA | Taught at school: To understand the consequences of making information publicly available online on |
| ST158Q05HA | Taught at school: How to use the short description below the links in the list of results of a search |
| ST158Q06HA | Taught at school: How to detect whether the information is subjective or biased |
| ST158Q07HA | Taught at school: How to detect phishing or spam emails |
| ST160Q01IA | How much do you agree or disagree? I read only if I have to. |
| ST160Q02IA | How much do you agree or disagree? Reading is one of my favourite hobbies. |
| ST160Q03IA | How much do you agree or disagree? I like talking about books with other people. |
| ST160Q04IA | How much do you agree or disagree? For me, reading is a waste of time. |
| ST160Q05IA | How much do you agree or disagree? I read only to get information that I need. |
| ST167Q01IA | How often do you read these materials because you want to? Magazines |
| ST167Q02IA | How often do you read these materials because you want to? Comic books |
| ST167Q03IA | How often do you read these materials because you want to? Fiction (novels, narratives, stories) |
| ST167Q04IA | How often do you read these materials because you want to? Non-fiction books (informational, documentary) |
| ST167Q05IA | How often do you read these materials because you want to? Newspapers |
| ST175Q01IA | About how much time do you usually spend reading for enjoyment? |
| FISCED | Father’s Education (ISCED) |
| MISCED | Mother’s Education (ISCED) |
| TMINS | Learning time (minutes per week) - in total |
| ESCS | Index of economic, social and cultural status |
| WEALTH | Family wealth (WLE) |
| PV1MATH | Plausible Value 1 in Mathematics |
| PV1READ | Plausible Value 1 in Reading |
| PV1SCIE | Plausible Value 1 in Science |
| ST004D01T | Student (Standardized) Gender |
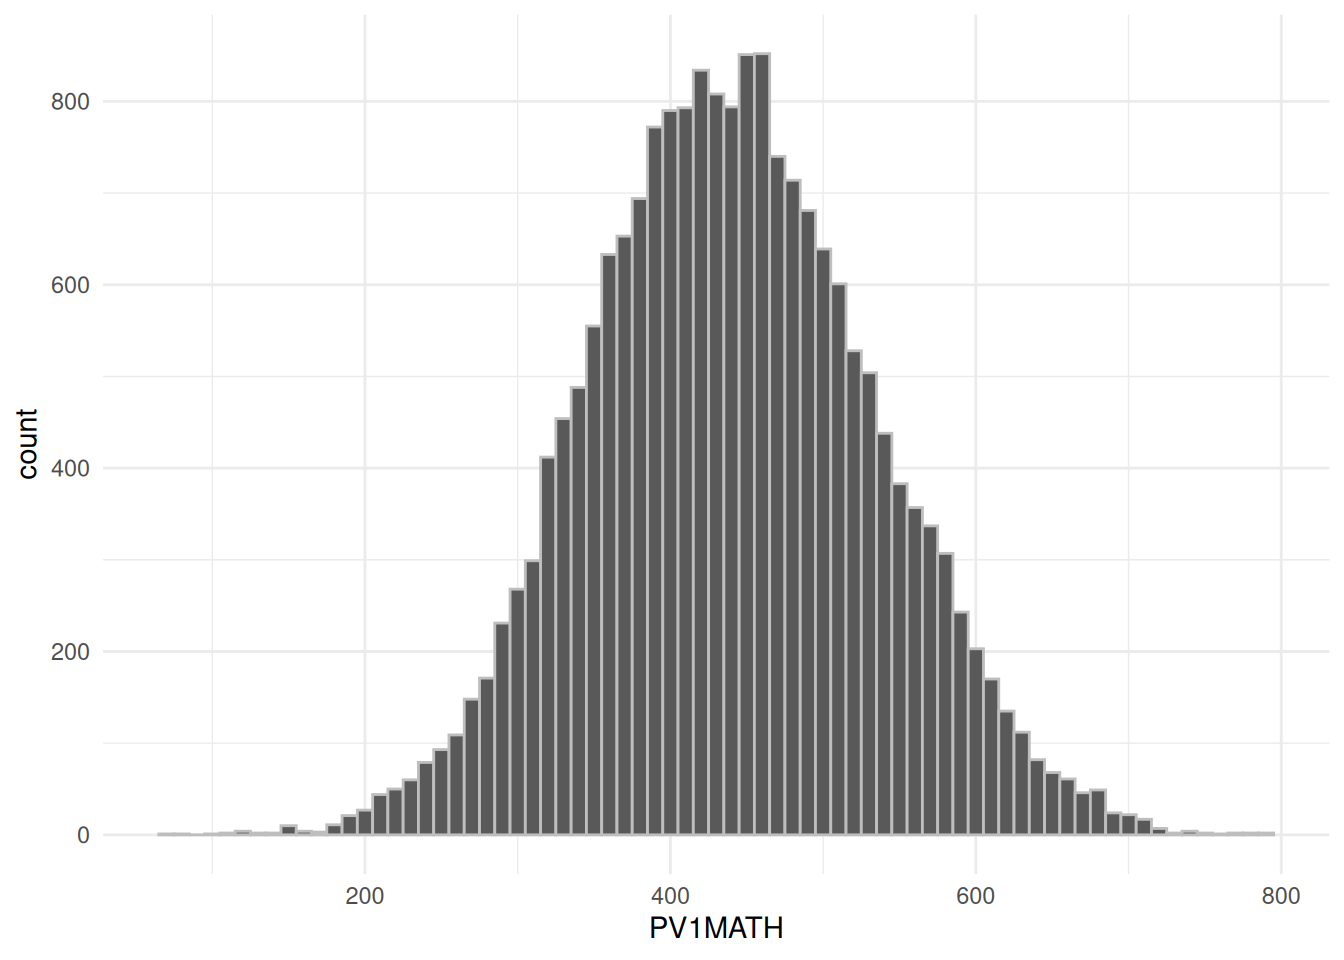
Сначала посмотрим на переменные. Вот распределение баллов по математике: среднее чуть выше 400, небольшой процент набрал больше 600, и есть небольшой процент детей, набравших меньше 200. Разброс большой — к слову о неравенстве в казахстанской школьной системе: есть 15-летние, которые знают математику хорошо, и есть те, кто знает ее весьма поверхностно.
Вторая переменная, TMINS, — количество времени в минутах, которое ребенок тратит на обучение в течение недели. Это self-report: дети сами оценивали свое время в анкете. Есть те, кто (по их собственным словам) занимается по 60 часов в неделю, и есть те, кто почти не занимается. Насколько этим данным можно доверять — отдельный вопрос, но пока примем их за чистую монету.
Warning: Removed 7152 rows containing non-finite outside the scale range
(`stat_bin()`).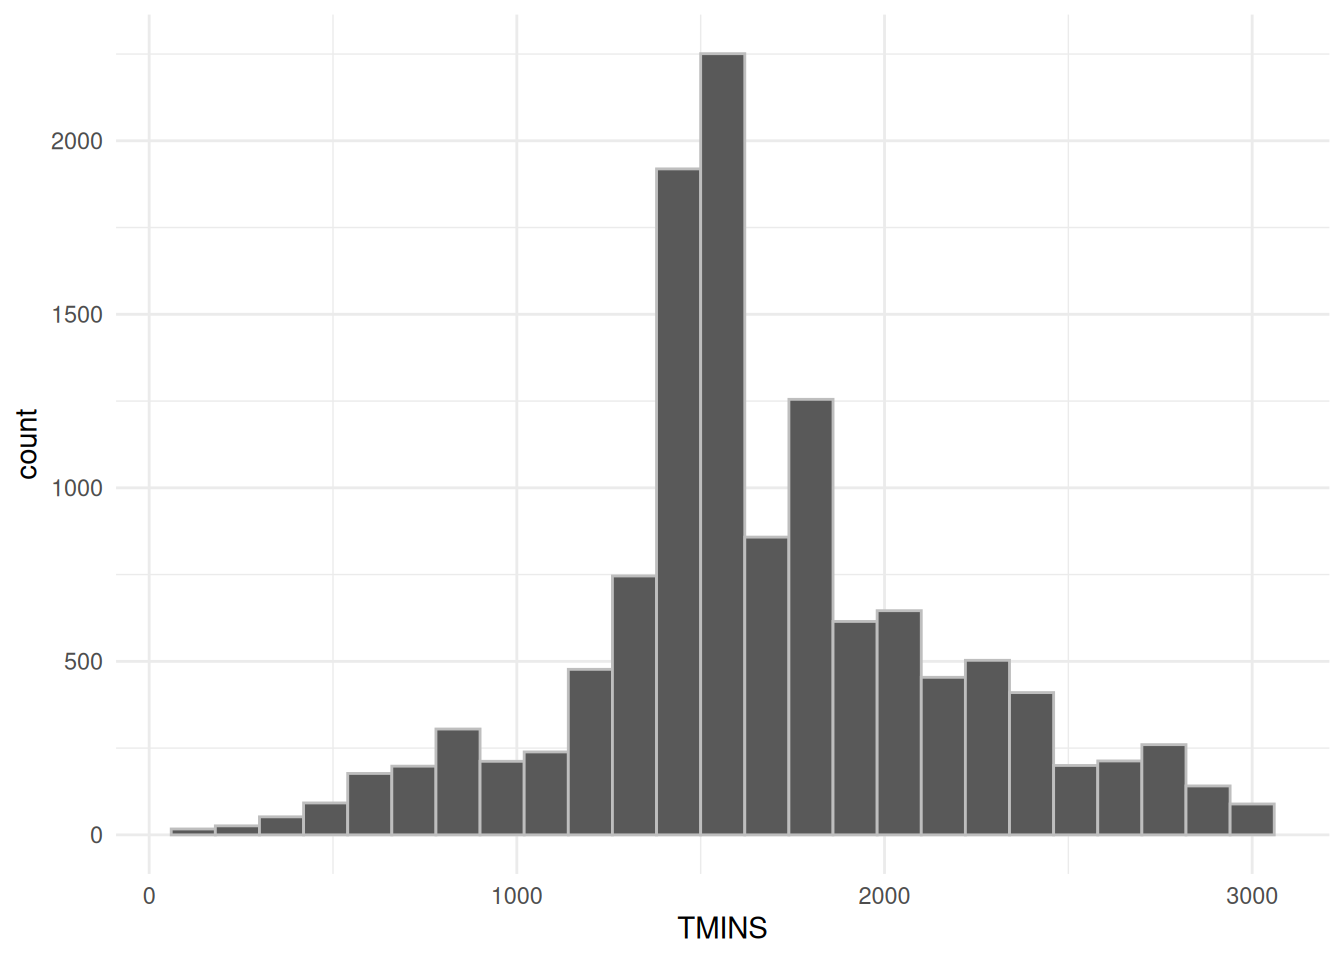
Call:
lm(formula = PV1MATH ~ TMINS, data = pisa_kz)

Residuals:
    Min      1Q  Median      3Q     Max
-359.30  -61.79    1.03   61.21  336.15

Coefficients:
             Estimate Std. Error t value Pr(>|t|)
(Intercept) 4.016e+02  2.840e+00  141.42   <2e-16 ***
TMINS       3.292e-02  1.627e-03   20.24   <2e-16 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 90.48 on 12353 degrees of freedom
  (7152 observations deleted due to missingness)
Multiple R-squared:  0.03209,   Adjusted R-squared:  0.03201
F-statistic: 409.5 on 1 and 12353 DF,  p-value: < 2.2e-16
Небольшое замечание о научной нотации: 4.016e+02 следует читать как \(4.016 \times 10^2\), то есть 401.6, а 3.3e-02 — как \(0.033\).
Как интерпретировать оценку интерсепта, 401.6? Это ожидаемый балл по математике для ребенка, который написал в анкете, что не занимается вообще (\(TMINS = 0\)). Таких детей в данных, кстати, практически не было, поэтому к этому коэффициенту относимся с легким подозрением.
А как интерпретировать коэффициент при TMINS, 0.033? Он кажется близким к нулю — но не спешите заключать, что связи нет. Во-первых, он близок к нулю отчасти потому, что единица измерения — минута: за каждую дополнительную минуту занятий в неделю ребенок в среднем получает +0.033 балла. Если бы мы измеряли время в часах, значение было бы другим. Во-вторых, близость к нулю надо оценивать относительно стандартной ошибки: t-значение показывает, что оценка находится в 20 стандартных ошибках от нуля — это очень далеко, и вероятность наблюдать такую оценку при истинном нуле составляет \(2\times10^{-16}\). Отсюда три звезды: мы уверены, что связь есть. Удобнее выражаться в сотнях минут: каждые дополнительные 100 минут занятий в неделю связаны с приростом в 3.3 балла по математике.
Давайте интерпретировать:
Модель: \(\textrm{Баллы по математике} = (Intercept) + \beta_1*TMINS + \textrm{Шум}\)
Подставим коэффициенты: \(\textrm{Баллы по математике} = 401.6 + 0.033*TMINS + \textrm{Шум}\)
Теперь давайте посчитаем, какие баллы по математике можно ожидать от школьника, который занимается, скажем, \(2400\) минут в неделю (\(40\) часов).
- \(\textrm{E[Баллы по математике]} = 401.6 + 0.033*2400 + Шум = 480.8\)
Давайте посмотрим насколько мы близки к реальным данным
pisa_kz %>%
  ggplot(aes(x = TMINS, y = PV1MATH)) +
  geom_point(alpha = 0.4) +
  geom_smooth(method = "lm") +
  geom_vline(xintercept = 2400, color = "tomato", size = 3, alpha = 0.4) +
  geom_hline(yintercept = 480.8, color = "green", size = 3, alpha = 0.4)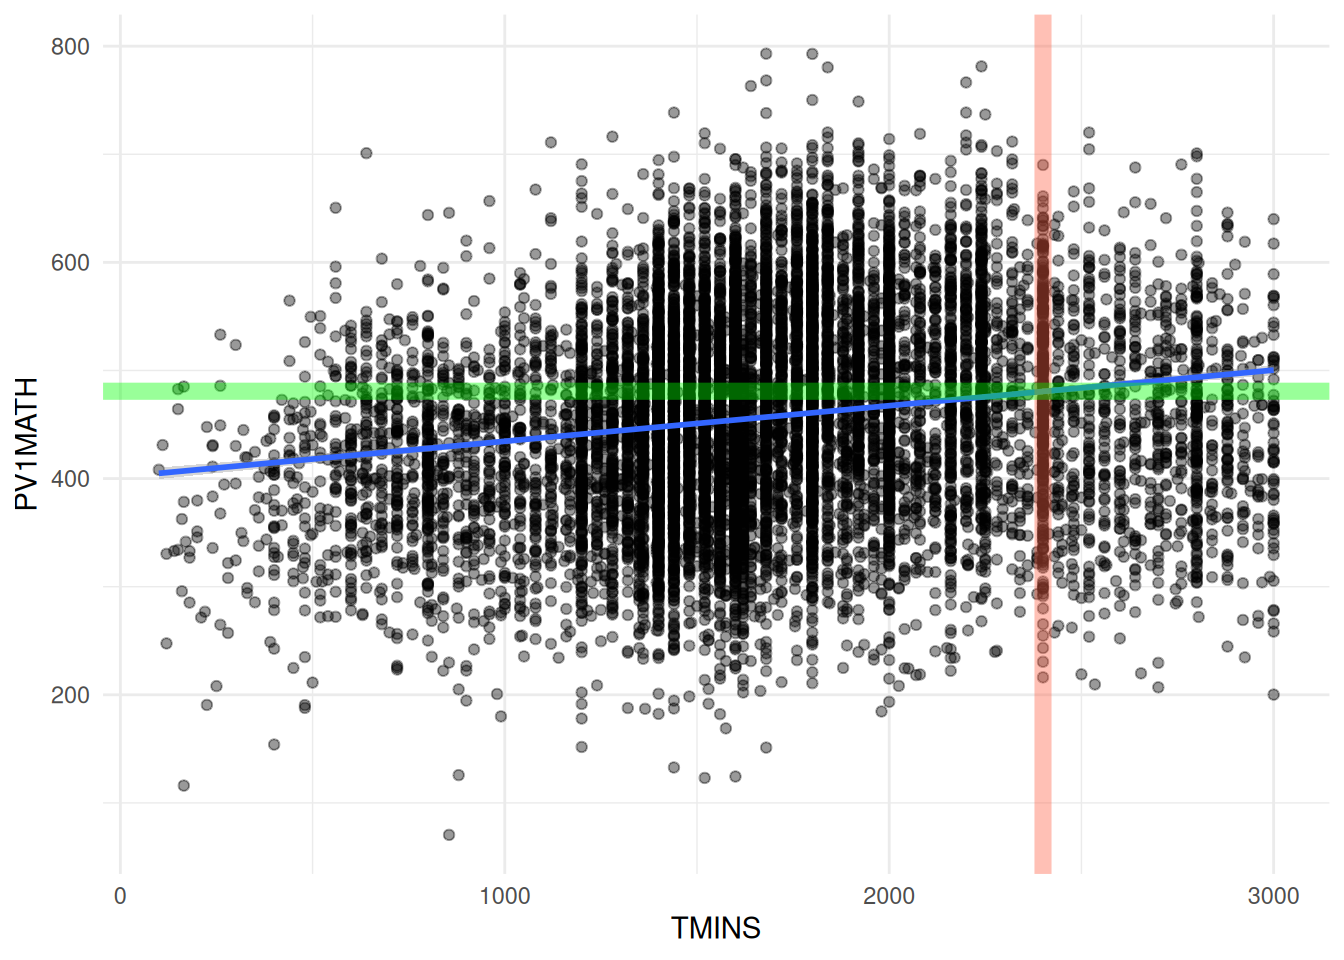
Модель неплохо показывает, где находится среднее ожидание для заданного значения независимой переменной. Но обратите внимание на разброс вокруг ожидаемого значения: среди тех, кто занимается по 40 часов в неделю, есть дети с баллом около 700 и есть с баллом около 200. Время, потраченное на обучение, не конвертируется в знание математики автоматически — что логично: человек может тратить эти часы, например, на языки. Уже по диаграмме можно предположить, что уровень объясненной дисперсии будет низким, — и действительно, \(R^2\) у этой модели около 3%. Зная, сколько человек занимается в неделю, мы можем объяснить лишь 3% разброса баллов по математике. Это логично: знания по математике складываются из огромного количества факторов, а мы учли лишь один.
Заметьте: модель объясняет мало, но то, что она объясняет, она объясняет уверенно — эффект значимый, а допущения модели, как мы сейчас увидим, не нарушены. Значимый эффект и маленький \(R^2\) — совершенно нормальное сочетание.
И еще посмотрим на остатки
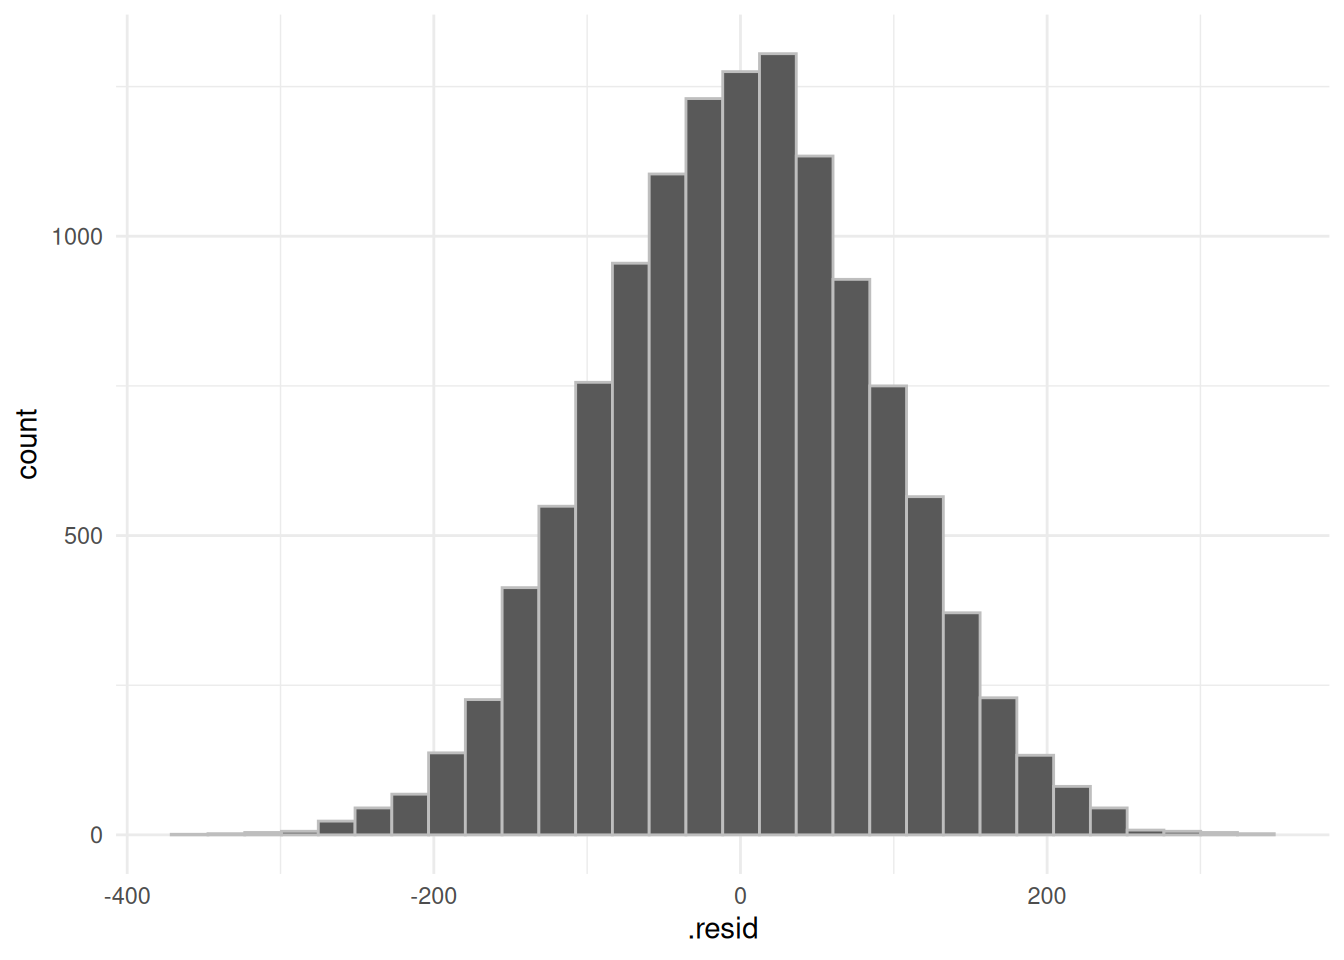
В целом, очень даже неплохо: остатки центрированы на нуле, симметричны и похожи на нормальное распределение.
Проверим это с помощью Q-Q plot.
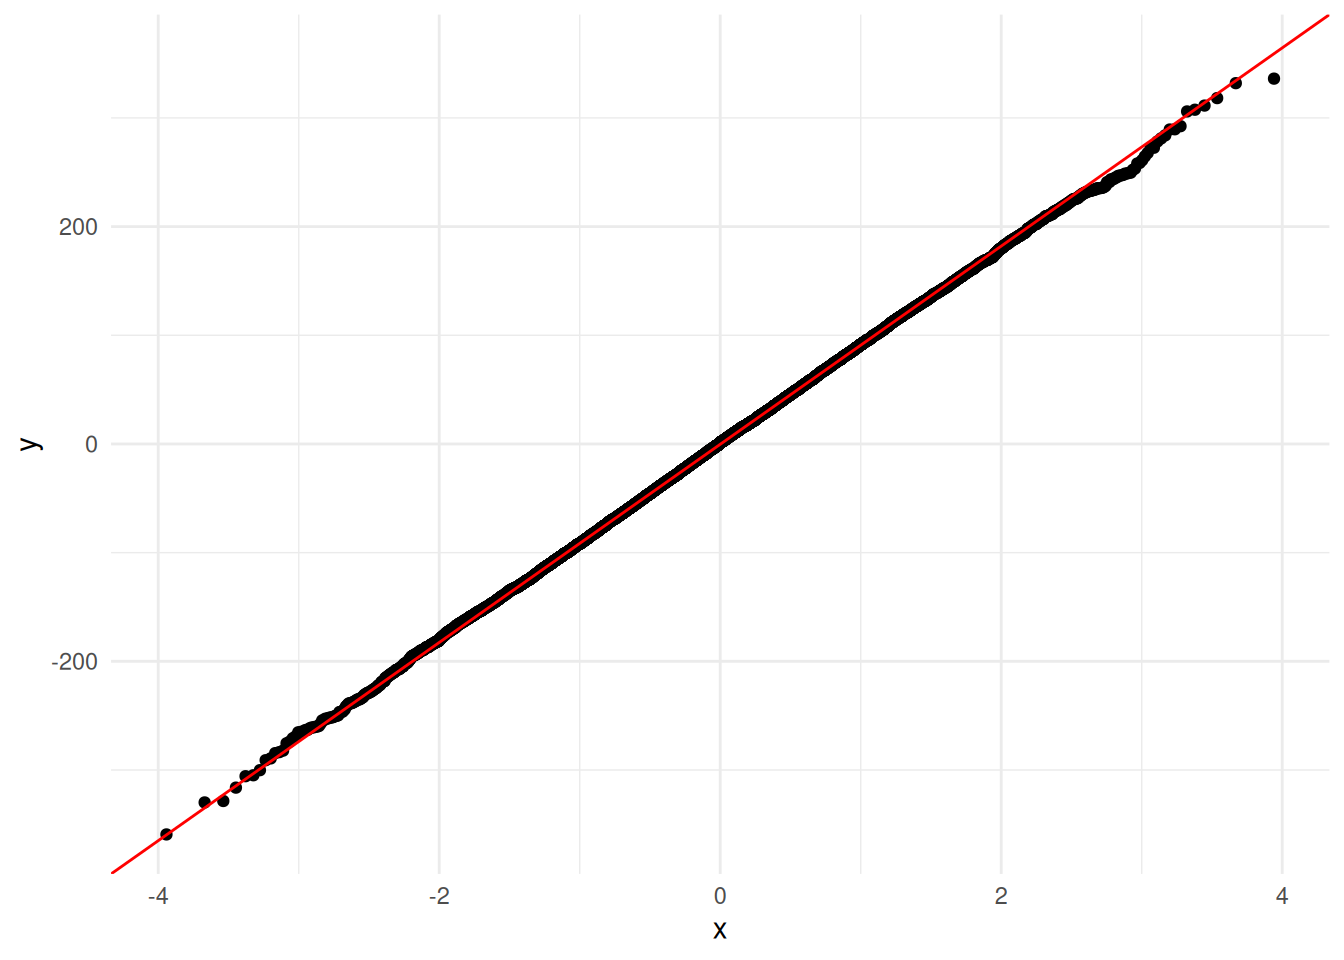
Так и есть. Остатки, похоже, нормально распределены: все выстраивается вдоль одной прямой линии — та ситуация, которую мы и хотим видеть. Кстати, на практике проверять остатки несколькими способами не обязательно: как правило, достаточно построить Q-Q plot.
[1] 90.47834Множественная регрессия
Пока что, мы только работали с одной объясняющей переменной. На практике же, нам интереснее использовать гораздо больше переменных: социальная реальность сложная, и наивно думать, что все разнообразие баллов по математике можно объяснить только временем, потраченным на обучение. Давайте расширим идею линейной регрессии, до случая с множеством объясняющих переменных.
\[ Y = \beta_0 + \beta_1 X_1 + \beta_2 X_2 + \dots + \beta_p X_p + Шум \]
Каждая независимая переменная вносит свой вклад через свой коэффициент. Принципиальной разницы между моделью с одной и с несколькими переменными нет: R точно так же найдет для каждой переменной оптимальное значение коэффициента — такое, чтобы функция потерь была минимальна, — а коэффициент \(\beta_j\) будет показывать, насколько изменится зависимая переменная, когда переменная \(X_j\) изменится на одну единицу.
Давайте возьмем наши данные из PISA, и попробуем добавить к старой модели всего одну переменную, Gender. У нее два возможных значения — мальчик и девочка, — и мы можем моделировать ее с помощью уже знакомой переменной-индикатора: если студент мальчик, индикатор равен единице и коэффициент \(\beta_2\) “включается”; если девочка — индикатор равен нулю. Коэффициент \(\beta_2\) тогда интерпретируется как средняя разница между мальчиками и девочками.
Формально, наша модель будет выглядеть так
\[ \textrm{Баллы по математике} = (Intercept) + \beta_1*TMINS + \beta_2*I(Gender = Male) + Шум \]
В R мы можем подогнать модель к данным используя такой синтаксис.
Посмотрим на результаты регрессии
Call:
lm(formula = PV1MATH ~ TMINS + Gender, data = .)

Residuals:
    Min      1Q  Median      3Q     Max
-361.18  -61.82    0.99   61.32  334.16

Coefficients:
             Estimate Std. Error t value Pr(>|t|)
(Intercept) 3.994e+02  2.978e+00 134.124   <2e-16 ***
TMINS       3.305e-02  1.627e-03  20.309   <2e-16 ***
GenderMale  3.953e+00  1.629e+00   2.427   0.0152 *
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 90.46 on 12352 degrees of freedom
  (7152 observations deleted due to missingness)
Multiple R-squared:  0.03255,   Adjusted R-squared:  0.03239
F-statistic: 207.8 on 2 and 12352 DF,  p-value: < 2.2e-16
Строк в таблице коэффициентов стало больше — по одной на каждую переменную. Что мы видим? Во-первых, интерсепт немного изменился: был 401, стал 399. Во-вторых, появилась строка GenderMale: для мальчиков балл по математике в среднем на 4 балла выше, чем для девочек.
Обратите внимание на само название GenderMale: R автоматически прикрепил к имени переменной название уровня, которому соответствует коэффициент. Когда одна из переменных в регрессии категориальная, одна из ее категорий автоматически становится базовой — она “прячется” в интерсепте, а коэффициенты оцениваются для остальных категорий относительно нее. По умолчанию R берет в качестве базовой ту категорию, которая идет первой по алфавиту: female раньше male, поэтому базовой стала девочка. Если бы мы явно попросили взять за базовую категорию мальчика, в таблице стояло бы GenderFemale, значение коэффициента не изменилось бы, но поменялся бы знак — мы просто взяли бы другую точку отсчета.
Кстати, теперь и интерсепт приобретает более осмысленное значение: это ожидаемый балл по математике для девочки (базовая категория), которая совсем не занимается.
Еще одна деталь: коэффициент для мальчиков значим, но уровень значимости не такой уж большой — оценка 3.95 находится всего в 2.5 стандартных ошибках от нуля, и вероятность наблюдать ее при истинном нуле около 1.5%. Я бы относился к этому значению с легким подозрением: это еще далеко не доказательство того, что мальчики лучше знают математику. Возможно, при добавлении переменных, контролирующих те или иные факторы, значимость этого коэффициента улетучится.
Мы можем взять оценки коэффициентов и подставить их в формулу, чтобы лучше понять что происходит
\[ \textrm{Баллы по математике} = 399.4 + 0.033*TMINS + 3.953*I(Gender = Male) + Шум \]
Давайте посчитаем, сколько ожидать баллов от девушки и парня, которые занимаются по 40 часов в неделю.
Для девушки:
\[ E[\textrm{Баллы по математике}] = 399.4 + 0.033*2400 + 3.953*0 + Шум \approx 478.6 \]
Для парня:
\[ E[\textrm{Баллы по математике}] = 399.4 + 0.033*2400 + 3.953*1 + Шум \approx 482.6 \]
Итак, мы выяснили, что при прочих равных, парни сдают математический экзамен в ПИЗЕ на примерно 4 балла лучше чем девушки. Разница небольшая, но она статистически значима (хотя и на границе значимости).
Больше переменных
Теперь давайте добавим больше переменных. Добавим переменную ESCS — индекс социально-экономического статуса семьи. Это числовая характеристика, варьирующаяся примерно от \(-3\) до \(3\): высокие значения означают, что в семье много ресурсов (машины, компьютеры, регулярный отдых за границей), низкие — что доступа к этим ресурсам нет. По сути, это форма измерения социально-экономического класса.
Call:
lm(formula = PV1MATH ~ TMINS + Gender + ESCS, data = .)

Residuals:
    Min      1Q  Median      3Q     Max
-349.20  -59.21    1.25   59.27  332.17

Coefficients:
             Estimate Std. Error t value Pr(>|t|)
(Intercept) 4.163e+02  2.944e+00 141.407   <2e-16 ***
TMINS       2.675e-02  1.591e-03  16.815   <2e-16 ***
GenderMale  4.518e+00  1.578e+00   2.863   0.0042 **
ESCS        2.674e+01  9.401e-01  28.439   <2e-16 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 87.61 on 12342 degrees of freedom
  (7161 observations deleted due to missingness)
Multiple R-squared:  0.09187,   Adjusted R-squared:  0.09165
F-statistic: 416.2 on 3 and 12342 DF,  p-value: < 2.2e-16
Обратите внимание: оценки всех коэффициентов изменились. Это частая история: добавление новых переменных влияет на оценки старых, отчасти потому, что переменные между собой коррелируют. Это нормально. Пройдемся по изменениям:
- Интерсепт вырос до ~416. Почему? Интерсепт показывает ожидаемый балл, когда все переменные равны нулю, а среднее значение
ESCSв Казахстане чуть ниже нуля — интерсепт “подвинулся”, чтобы учесть детей с отрицательными значениями индекса. - Коэффициент времени обучения упал с 0.033 до 0.026. Это означает, что время обучения коррелирует с социально-экономическим статусом: дети из более ресурсных семей склонны тратить на образование больше времени — например, ходить в кружки по робототехнике или математике. Часть разницы, которую в предыдущей модели мы приписывали времени занятий, на самом деле объясняется разницей в достатке.
- Оценка для
GenderMaleвыросла с 4 до 4.5 балла, и уровень значимости повысился. Это тоже частая история: добавление контрольных переменных позволяет лучше оценить вклад других переменных. Отчасти поэтому хорошая практика подгонки моделей — подгонять много разных моделей и смотреть, как коэффициенты меняются в зависимости от включенных переменных. - Сам коэффициент
ESCSравен ~26.7: за каждую единицу индекса студент в среднем пишет математику на 27 баллов лучше. Между детьми из богатых и бедных семей разница в математике будет весьма существенной. - Объясненная дисперсия выросла до 9%: социально-экономический класс объясняет немало.
Любопытное наблюдение в сторону (не про статистику — можете подумать об этом на досуге): в казахстанских данных PISA средний уровень достатка семей у девочек немного, но статистически значимо выше, чем у мальчиков. Сам по себе пол ребенка не должен влиять на достаток семьи, и в других странах (я проверял, например, Японию) такого не видно. Просто делюсь интересным наблюдением:
| Gender | mean(ESCS, na.rm = TRUE) |
|---|---|
| Female | -0.3198707 |
| Male | -0.3441408 |
В модели можно добавлять эффекты взаимодействия (interaction effects). Эффект взаимодействия возникает, когда влияние одной переменной зависит от значения другой переменной.
- Например, семейное богатство может по-разному влиять на мальчиков и девочек
Мы спрашиваем: будет ли прирост баллов за единицу социально-экономического статуса разным для мальчиков и девочек? Может ли богатство семьи сильнее способствовать математическим знаниям, скажем, девочек? Синтаксически эффект взаимодействия задается перемножением переменных:
Call:
lm(formula = PV1MATH ~ TMINS + Gender * ESCS, data = .)

Residuals:
    Min      1Q  Median      3Q     Max
-348.63  -59.05    1.30   59.37  331.80

Coefficients:
                 Estimate Std. Error t value Pr(>|t|)
(Intercept)     4.161e+02  2.954e+00 140.855  < 2e-16 ***
TMINS           2.677e-02  1.591e-03  16.822  < 2e-16 ***
GenderMale      4.961e+00  1.645e+00   3.016  0.00257 **
ESCS            2.584e+01  1.329e+00  19.450  < 2e-16 ***
GenderMale:ESCS 1.774e+00  1.863e+00   0.952  0.34101
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 87.61 on 12341 degrees of freedom
  (7161 observations deleted due to missingness)
Multiple R-squared:  0.09194,   Adjusted R-squared:  0.09165
F-statistic: 312.4 on 4 and 12341 DF,  p-value: < 2.2e-16
Строк опять стало больше. Коэффициент ESCS теперь соответствует только девочкам (базовой категории): за каждую единицу прироста статуса их средний балл растет примерно на 26 баллов. А строка GenderMale:ESCS — это добавка к эффекту богатства для мальчиков. И мы видим, что оценка у нее есть, а значимости нет: она слишком близка к нулю относительно своей стандартной ошибки. Как это интерпретировать? Между мальчиками и девочками есть разница в среднем балле, но нет разницы в том, как на их баллы влияет достаток семьи, — богатство работает одинаково для всех. Это тот случай, когда у нас “оценка есть, а значимости нет”, и именно так интерпретируются незначимые результаты.
Отличная практика — взять конкретные значения независимых переменных и посчитать ожидаемые значения зависимой. Поскольку коэффициент взаимодействия незначим, при расчетах мы его не добавляем (ставим 0):
\[\begin{align*} \textrm{Баллы по математике} ={} & 416.1 + 0.0268*TMINS + 4.96*Gender \\ & + 25.84*ESCS + 0*(GenderMale \times ESCS) \end{align*}\]
Девочка из богатой семьи: TMINS = 2400, ESCS = 1
\[ \textrm{Баллы по математике} = 416.1 + 0.0268*2400 + 25.84*1 = 506.26 \]
Девочка из средней семьи: TMINS = 2400, ESCS = 0
\[ \textrm{Баллы по математике} = 416.1 + 0.0268*2400 + 25.84*0 = 481 \]
Мальчик из богатой семьи:
\[ \textrm{Баллы по математике} = 416.1 + 0.0268*2400 + 4.96*1 + 25.84*1 = 511.26 \]
Мальчик из средней семьи:
\[ \textrm{Баллы по математике} = 416.1 + 0.0268*2400 + 4.96*1 + 25.84*0 = 485.38 \]
Посчитав несколько таких сценариев, вы почувствуете, что богатство везде вносит один и тот же вклад — те же 25.84 балла за единицу индекса, что для мальчиков, что для девочек.
Эффекты взаимодействия: Казахстан и Япония
В примере выше эффект взаимодействия оказался незначимым. Теперь я покажу ситуацию, где он значим — и приведет нас к достаточно интересным выводам. Будем сравнивать результаты PISA для Казахстана и Японии. Сразу скажу, что сравнение будет не в нашу пользу: средний балл по математике в Японии 528, в Казахстане около 440.
Чтобы добавить контекста: сами создатели PISA говорят, что 40 баллов PISA соответствуют примерно одному году обучения. PISA тестирует 15-летних школьников — и там, и там взяли выборку одного возраста. Разница между Японией и Казахстаном почти 90 баллов, то есть японский 15-летний школьник знает математику так, как будто он учился на два года дольше своего казахстанского сверстника. К слову о том, что нам есть куда расти.
| CNT | Среднее |
|---|---|
| Japan | 528.2104 |
| Kazakhstan | 439.9113 |
- Посмотрим на простую модель с одной объясняющей переменной (страна)
| (1) | |
|---|---|
| (Intercept) | 528.210 |
| (1.174) | |
| CNTKazakhstan | -88.299 |
| (1.345) | |
| Num.Obs. | 25616 |
| R2 | 0.144 |
| R2 Adj. | 0.144 |
| AIC | 304222.3 |
| BIC | 304246.7 |
| Log.Lik. | -152108.137 |
| F | 4308.341 |
| RMSE | 91.75 |
- Здесь мы видим, что в Казахстане в среднем школьники сдавали математику на 88 баллов хуже чем в Японии.
Japan начинается с J и идет раньше по алфавиту, поэтому Япония стала базовым уровнем: интерсепт — это среднее для Японии (528), а чтобы получить среднее для Казахстана, вычитаем “штраф” в 88 баллов.
- Давайте усложним модель и добавим переменную WEALTH (обеспеченность семьи)
Переменная WEALTH, в отличие от ESCS, более таргетированно измеряет именно материальное богатство (сколько машин, телевизоров и т.п.), без социально-культурных факторов вроде предметов искусства или пианино дома. Скептик мог бы сказать: дело не в “Казахстане” как таковом, а просто в том, что у нас много бедных семей. Проверим:
| (1) | |
|---|---|
| (Intercept) | 534.606 |
| (1.198) | |
| CNTKazakhstan | -79.115 |
| (1.397) | |
| WEALTH | 14.850 |
| (0.697) | |
| Num.Obs. | 25487 |
| R2 | 0.159 |
| R2 Adj. | 0.159 |
| AIC | 302112.7 |
| BIC | 302145.3 |
| Log.Lik. | -151052.338 |
| RMSE | 90.71 |
Коэффициент для Казахстана изменился! Почему?
Потому что переменная
CNTкоррелирует с переменнойWEALTH. Взгляните,
Warning: Removed 129 rows containing non-finite outside the scale range
(`stat_bin()`).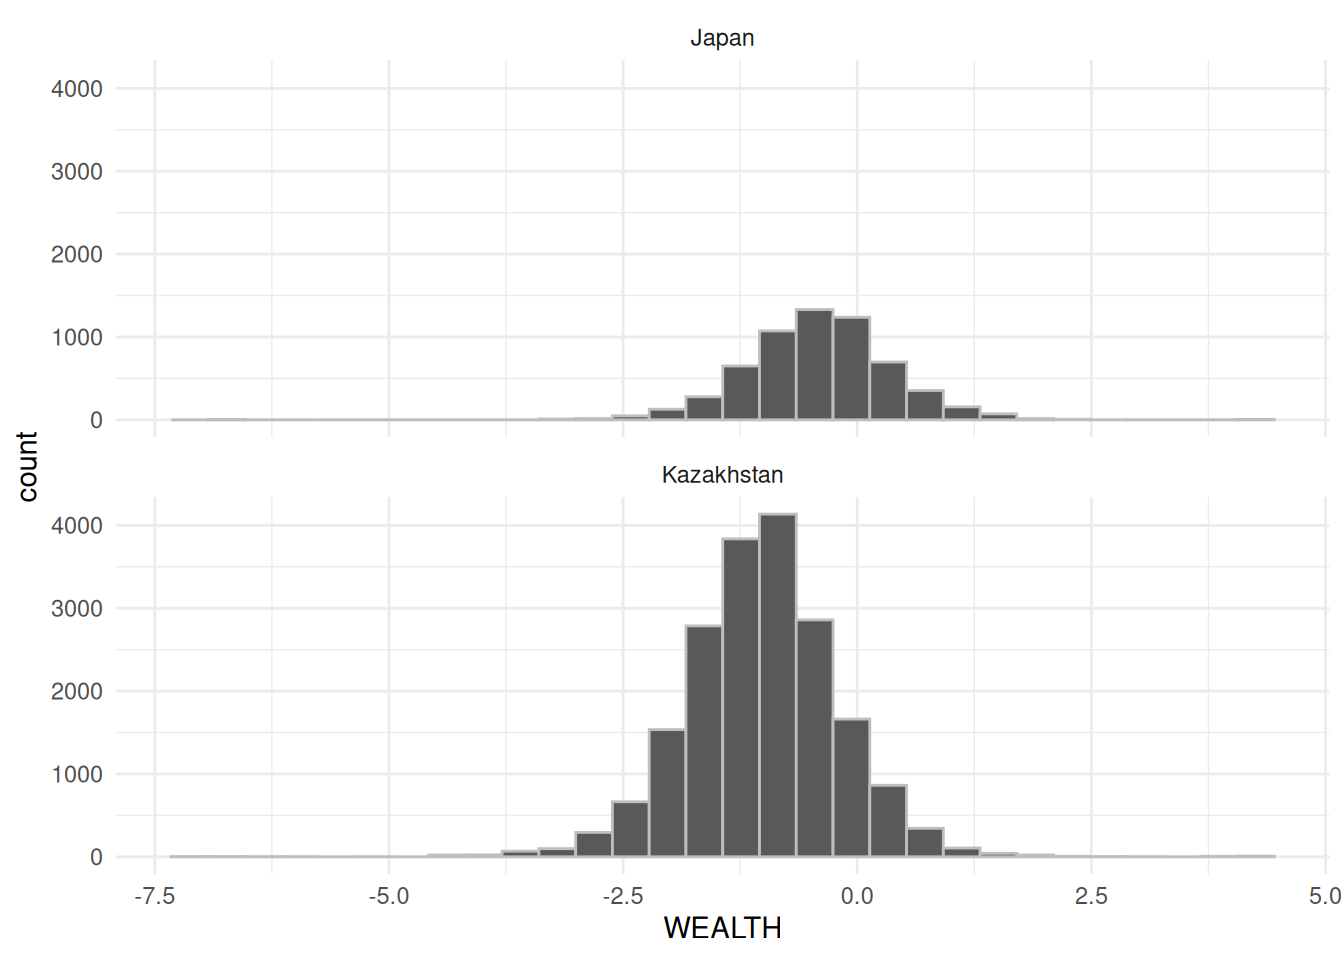
Средний уровень богатства в Японии находится чуть ниже нуля, а в Казахстане — где-то в районе \(-1.5\). Та изначальная разница в 88 баллов частично объясняется просто тем, что Япония богаче. Это стандартная история: мы получаем смещенные оценки коэффициентов, когда они сильно коррелируют с другой переменной, которая и объясняет разницу.
Пойдем дальше. Я слышал, что в Японии существует культ работы, который идеализирует тяжелый труд с раннего возраста, — и школьники там впахивают. Эту теорию можно проверить: добавим переменную THOURS (те же минуты обучения, но переведенные в часы, чтобы интерпретация была проще).
| (1) | |
|---|---|
| (Intercept) | 490.772 |
| (2.812) | |
| CNTKazakhstan | -71.391 |
| (1.489) | |
| WEALTH | 12.564 |
| (0.837) | |
| THOURS | 1.776 |
| (0.089) | |
| Num.Obs. | 17872 |
| R2 | 0.174 |
| R2 Adj. | 0.174 |
| AIC | 210561.1 |
| BIC | 210600.1 |
| Log.Lik. | -105275.571 |
| RMSE | 87.50 |
Опять коэффициент для Казахстана уменьшился (в абсолютном значении)!
Значит, переменные
THOURSиCNTтоже коррелируют
Warning: Removed 7715 rows containing non-finite outside the scale range
(`stat_bin()`).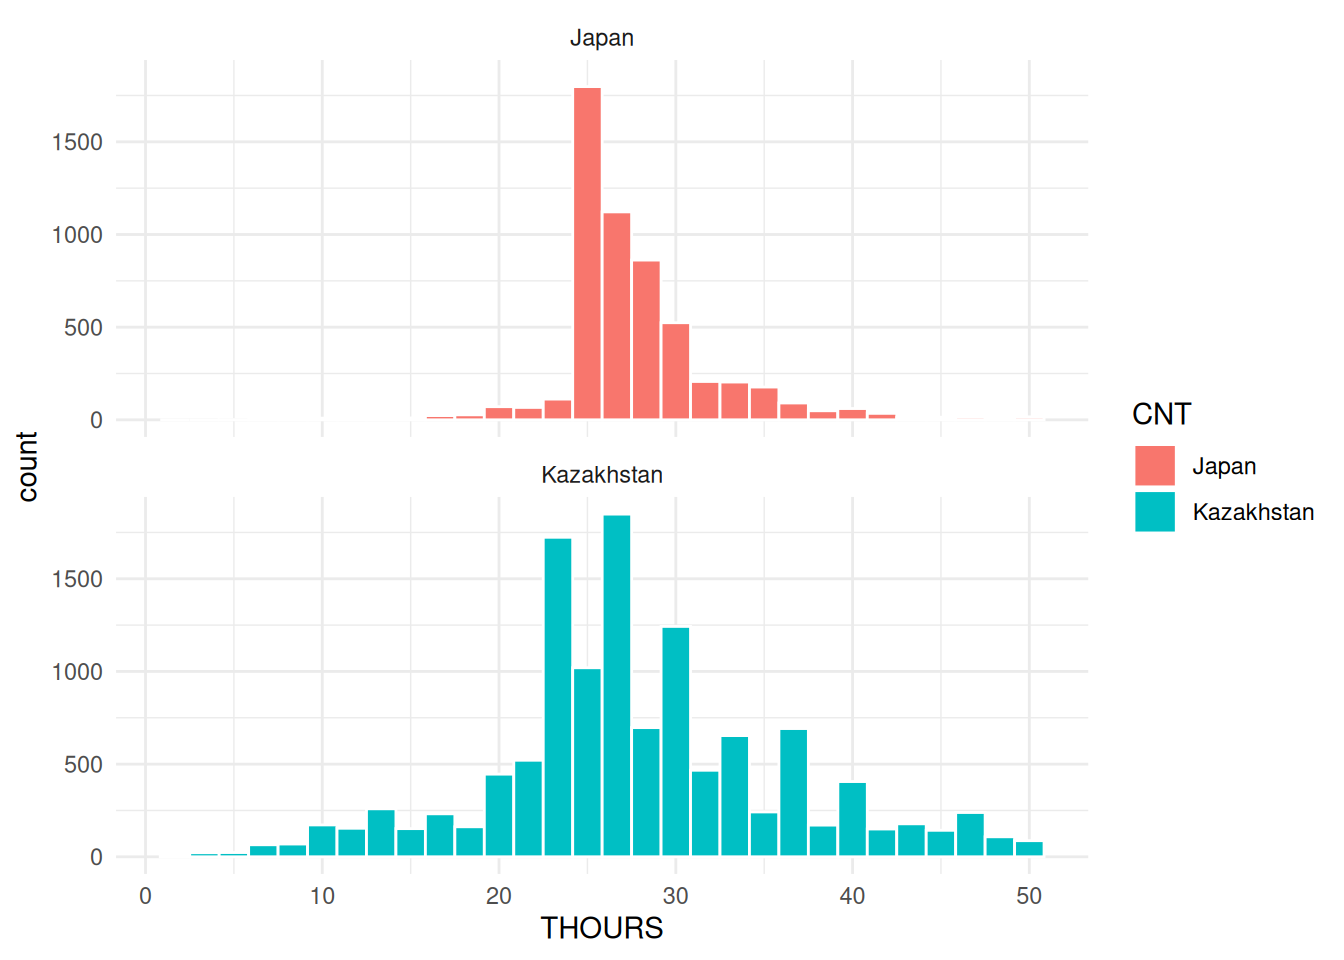
Мне очень нравится эта картинка — она хорошо иллюстрирует культурные различия. В Казахстане есть школьники, которые считают, что учатся по 50 часов в неделю (в Японии таких относительно мало), но при этом хватает и тех, кто не делает почти ничего. А в Японии распределение резко обрезано слева: даже самые ленивые японские школьники свои ~20 часов в неделю отрабатывают.
Концептуально: коэффициент для Казахстана уменьшился с \(-88\) до \(-71\), потому что часть страновой разницы объясняется разницей в богатстве, а еще часть — тем, что в Японии систематически больше учатся.
- Теперь попробуем построить модель с эффектом взаимодействия между страной
CNTи богатствомWEALTH.
Вопрос такой: может ли быть, что в Казахстане и Японии богатство по-разному влияет на баллы по математике? Например, если японская система образования тотально инклюзивна, то происхождение из небогатой семьи не должно сильно сказываться на качестве образования. А в Казахстане — очень даже может.
| (1) | |
|---|---|
| (Intercept) | 486.059 |
| (2.834) | |
| CNTKazakhstan | -59.828 |
| (1.810) | |
| WEALTH | -2.063 |
| (1.554) | |
| THOURS | 1.733 |
| (0.089) | |
| CNTKazakhstan × WEALTH | 20.525 |
| (1.839) | |
| Num.Obs. | 17872 |
| R2 | 0.180 |
| R2 Adj. | 0.180 |
| AIC | 210439.0 |
| BIC | 210485.8 |
| Log.Lik. | -105213.510 |
| RMSE | 87.19 |
- Как это понимать? Взглянем на формулу
(Кстати, в этой таблице нет звезд, но их всегда можно прикинуть: делим коэффициент на стандартную ошибку в скобках — если полученная t-статистика больше трех, уровень значимости высокий.)
Коэффициент WEALTH теперь соответствует базовой категории — Японии, и он незначим: мы даже не уверены, что в Японии богатство семьи вообще влияет на знания по математике. А вот добавка для Казахстана (CNT:WEALTH) — значимая и большая, около 20 баллов. Помните, в модели без взаимодействия коэффициент богатства был ~15? Он маскировал в себе существенную разницу между странами: ноль с одной стороны и двадцать с другой.
Для краткости обозначим \(I(KZ) = I(CNT = Kazakhstan)\):
\[\begin{align*} \textrm{Баллы по Математике} ={} & \beta_0 + \beta_1 I(KZ) + \beta_2 WEALTH \\ & + \beta_3 THOURS + \beta_4 (WEALTH \times I(KZ)) \\ \textrm{Баллы по Математике} ={} & 486 − 59.8\, I(KZ) − 0 \times WEALTH \\ & + 1.733\, THOURS + 20.525\, (WEALTH \times I(KZ)) \end{align*}\]
- Теперь попробуем понять как школьники из богатых и бедных семей в Казахстане и Японии будут сдавать математику
Трудолюбивый японец:ка из небогатой семьи: THOURS = 40, WEALTH = 0
\[ \textrm{Баллы по математике} = 486 - 0 - 0 + 1.733 \times 40 + 20.5 \times 0 \approx 555 \]
Трудолюбивый казахстанец:ка из небогатой семьи: THOURS = 40, WEALTH = 0
\[ \textrm{Баллы по математике} = 486 - 59.8 - 0 + 1.733 \times 40 + 20.5 \times 0 \approx 495.5 \]
Трудолюбивый японец:ка из богатой семьи: THOURS = 40, WEALTH = 3
\[ \textrm{Баллы по математике} = 486 - 0 - 0 + 1.733 \times 40 + 20.5 \times 0 \approx 555 \]
Трудолюбивый казахстанец:ка из богатой семьи: THOURS = 40, WEALTH = 3
\[ \textrm{Баллы по математике} = 486 - 59.8 - 0 + 1.733 \times 40 + 20.5 \times 3 \approx 557 \]
Посмотрите: ожидаемые баллы для богатой и небогатой семьи в Японии одинаковы (555 и 555), а в Казахстане разница большая (495 против 557). Разница между Казахстаном и Японией складывается из того, что у нас дети из бедных семей систематически хуже пишут математику, чем дети из богатых. Более того, дети из богатых казахстанских семей учатся примерно так же, как их японские сверстники, — у них есть ресурсы. А дети из бедных семей отстают: на концах спектра богатства разница в ожидаемых баллах превышает сотню — по конвертации «40 баллов = год обучения» это примерно три года: кто-то только научился делить столбиком, а кто-то уже берет интегралы.
- Можно построить графики. Что нас останавливает от того, чтобы взять разные возможные значения независимых переменных, подставить их в модель и нарисовать ожидаемые значения? Сначала создадим синтетические данные
| CNT | THOURS | WEALTH |
|---|---|---|
| Kazakhstan | 30 | -3 |
| Kazakhstan | 30 | -2 |
| Kazakhstan | 30 | -1 |
| Kazakhstan | 30 | 0 |
| Kazakhstan | 30 | 1 |
| Kazakhstan | 30 | 2 |
| Kazakhstan | 30 | 3 |
| Japan | 30 | -3 |
| Japan | 30 | -2 |
| Japan | 30 | -1 |
| Japan | 30 | 0 |
| Japan | 30 | 1 |
| Japan | 30 | 2 |
| Japan | 30 | 3 |
- А потом построим на них графики
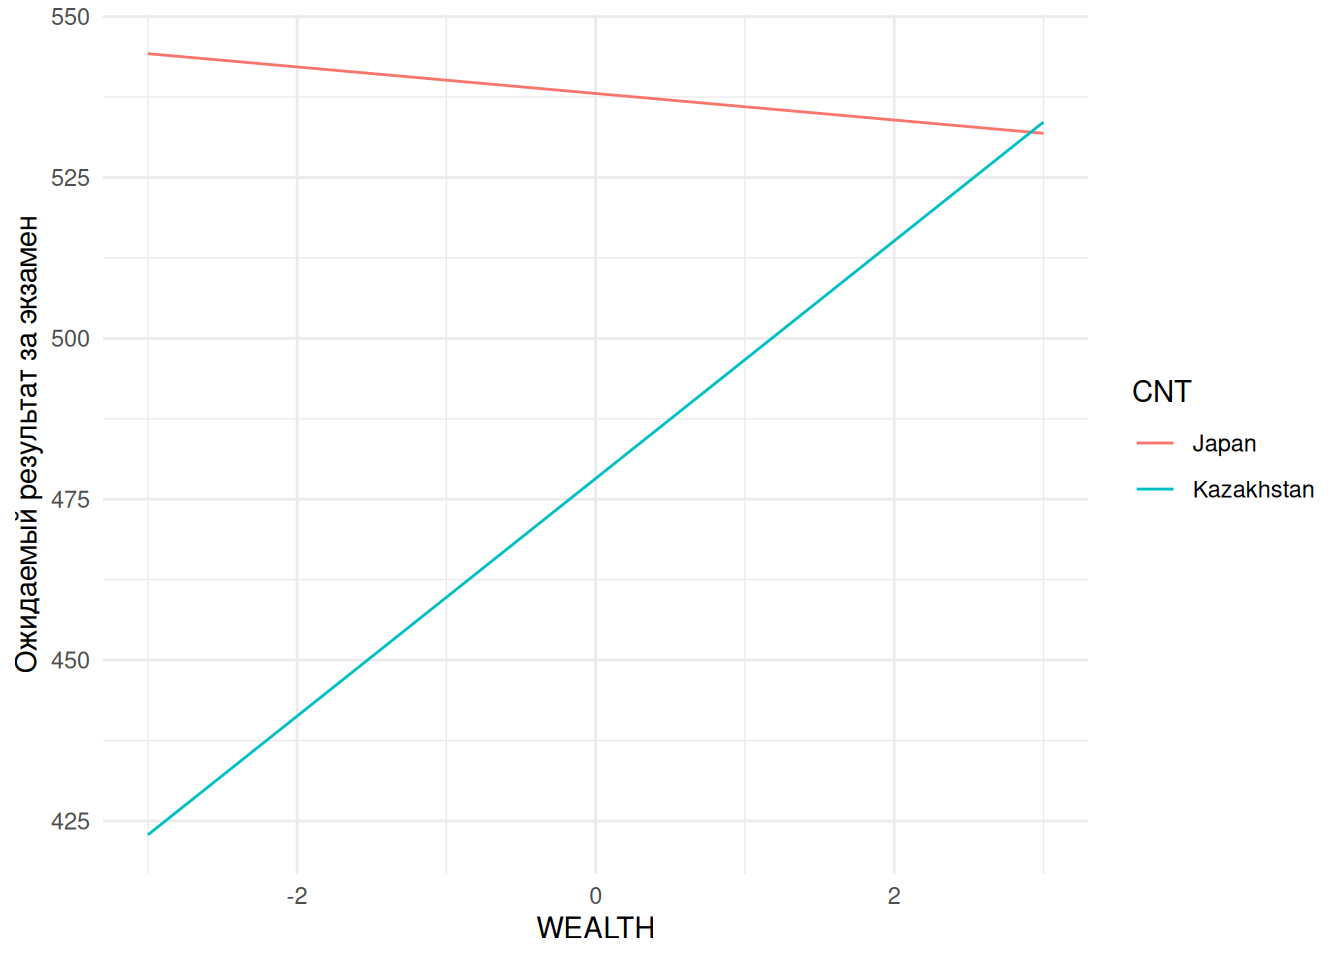
Красная линия показывает, как меняются ожидаемые результаты по мере роста богатства семьи в Японии, голубая — в Казахстане. В Японии коэффициент незначим, поэтому все, что мы можем сказать: богатство там не влияет на ожидаемые результаты. А в Казахстане ожидаемое значение очень сильно варьируется с уровнем богатства семьи.
Как выбрать лучшую модель?
- В примере выше у нас было несколько моделей. Как понять какая из них лучше?
Вопрос не праздный: в разных моделях оценки коэффициентов разные, и от выбора модели зависит интерпретация. В одной модели разница между Казахстаном и Японией была \(-88\) баллов, в другой \(-60\) — есть разница, какую выбрать, хотя бы для чувства гордости за собственную страну.
- Один из способов - это сравнить объемы объясненной дисперсии (
R-squared) моделей
| model1 | model2 | model3 | model4 | |
|---|---|---|---|---|
| (Intercept) | 528.210 (1.174)*** | 534.606 (1.198)*** | 490.772 (2.812)*** | 486.059 (2.834)*** |
| CNTKazakhstan | -88.299 (1.345)*** | -79.115 (1.397)*** | -71.391 (1.489)*** | -59.828 (1.810)*** |
| WEALTH | 14.850 (0.697)*** | 12.564 (0.837)*** | -2.063 (1.554) | |
| THOURS | 1.776 (0.089)*** | 1.733 (0.089)*** | ||
| CNTKazakhstan × WEALTH | 20.525 (1.839)*** | |||
| Num.Obs. | 25616 | 25487 | 17872 | 17872 |
| R2 | 0.144 | 0.159 | 0.174 | 0.180 |
| R2 Adj. | 0.144 | 0.159 | 0.174 | 0.180 |
| F | 4308.341 | |||
| RMSE | 91.75 | 90.71 | 87.50 | 87.19 |
Такая форма записи (модели по столбцам, коэффициенты по строкам — так обычно публикуют результаты в журналах) удобна еще и тем, что видно, как меняется коэффициент интересующей переменной по мере включения других переменных: Казахстан начинал с \(-88\), а после контроля важных характеристик разница снизилась. Мы также видим, что объясненная дисперсия выросла с 14% в базовой модели до ~18% в самой сложной. Заметим, что четвертая модель интересна не только цифрами: она тестирует содержательную гипотезу о том, что богатство — не универсальная характеристика, а контекстуальная: в одних контекстах (Казахстан) оно сильно связано с уровнем знаний, в других (Япония) — не имеет значения. Это само по себе достойно обсуждения.
Насколько эта разница велика? Можно ли, например, сказать, что 4-ая модель значительно лучше чем 3-я
Оказывается, объясненная дисперсия (т.е. R-squared) - это тоже случайная переменная: на другой выборке из той же популяции она приняла бы немного другое значение. И не просто случайная, а к тому же имеющая известное распределение. А это значит, что мы можем проверить гипотезу: значимо ли изменилась объясненная дисперсия? Нулевая гипотеза здесь — очень простое утверждение: между моделями нет никакой разницы, они объясняют одинаковый объем дисперсии. Сравнить две вложенные модели можно с помощью теста ANOVA:
| term | df.residual | rss | df | sumsq | statistic | p.value |
|---|---|---|---|---|---|---|
| PV1MATH ~ CNT * WEALTH + THOURS | 17867 | 135872904 | NA | NA | NA | NA |
| PV1MATH ~ CNT + WEALTH + THOURS | 17868 | 136819845 | -1 | -946940.8 | 124.5207 | 0 |
| Res.Df | RSS | Df | Sum of Sq | F | Pr(>F) |
|---|---|---|---|---|---|
| 17867 | 135872904 | NA | NA | NA | NA |
| 17868 | 136819845 | -1 | -946940.8 | 124.5207 | 0 |
Самое важное число здесь — p-значение: вероятность получить такой прирост объясненной дисперсии при условии, что более сложная модель ничем не лучше. Она практически равна нулю, значит, прирост значимый: модель 4 действительно добавляет к нашему пониманию процесса, который произвел данные, и мы можем со спокойной совестью выбрать ее.
Остатки регрессии - это разности между наблюдаемыми значениями и значениями, предсказанными изучаемой регрессионной моделью.↩︎
Также называется коэффициентом детерминации (
 — R-квадрат) — это доля дисперсии зависимой переменной, объясняемая рассматриваемой моделью зависимости, то есть объясняющими переменными.↩︎
Это условие также называется гомоскедастичностью↩︎