7 Общая вероятность и формула Байеса
Общая вероятность
Вернемся к задаче о тесте на беременность из предыдущей главы и задумаемся, сможем ли мы восстановить вероятность события \(B\), зная вероятность \(P(A \cap B)\). Событие \(B\) может произойти при условии \(А\) и при условии \(А^c\). Эти события взаимно исключающие и совместно исчерпывающие “пути” к событию \(B\). Поэтому,
\[\begin{align*} P(B) &= P(A \cap B) + P(A^c \cap B) \\ &= P(A)P(B|A) + P(A^c)P(B|A^c) \\ &= 0.01*0.98 + 0.99*0.05 \\ &= 0.0593 \end{align*}\]
Идея в том, что тест может быть положительным (\(B\)) при двух несовместимых возможностях: когда вы беременны (\(А\)) и когда вы не беременны (\(А^c\)). Соответственно, множество положительно тестированных женщин будет состоять из двух непересекающихся множеств: тех, кто был тестирован положительно и был беременным (\(A \cap B\)), и тех, кто был тестирован положительно, но беременным не был (\(A^c \cap B\)).
Теперь вернемся к вопросу о вероятности беременности \(A\) при условии, что тест положителен \(B\). Мы посчитали вероятность события «женщина беременна И тест положителен»:
\[P(A \cap B) = P(A)*P(B|A)\]
Мы также посчитали вероятность события, что тест положителен
\[P(B) = P(A \cap B) + P(A^c \cap B)\]
Подставляя выражения в формулу условной вероятности получаем,
\[P(A|B) = \frac{P(A \cap B)}{P(B)} = \frac{0.0098}{0.0593} = 0.165\]
\(16.5\%\) - вероятность того, что вы действительно беременны, если тест был положительным. Выглядит немного парадоксально: точность теста высока, \(98\%\), а вероятность быть беременной не то чтобы очень.
На самом деле, ничего парадоксального нет. Быть беременной изначально было редким событием (\(P(A) = 0.01\)). Даже если очень точный тест дает положительный результат, просто в силу редкости, вы все еще скорее не беременны, чем беременны.
Это, на самом деле, частая ситуация в мире вероятностей. Если немного подробнее расписать формулу выше, можно заметить, что, во-первых, общая вероятность состоит из двух слагаемых, а, во-вторых, что одно из них также находится в числителе.
\[P(A|B) = \frac{P(A \cap B)}{P(B)} = \frac{\color{red}{P(A \cap B)}}{\color{red}{P(A \cap B)} + P(A^c \cap B)}\]
Слагаемое \(P(A\cap B)\) - вносит небольшой вклад, потому что это произведение двух вероятностей, одна из которых очень мала:
\[P(A \cap B) = \underbrace{P(A)}_{0.01}\underbrace{P(B|A)}_{0.98}\]
Второе слагаемое в знаменателе, \(P(A^c\cap B)\) - вносит бОльший вклад в общую вероятность, потому что вероятность \(P(A^c)\) - велика
\[P(A^c \cap B) = \underbrace{P(A^c)}_{0.99}\underbrace{P(B|A^c)}_{0.05}\]
Формула Байеса
А теперь соберем все выражения в одну формулу и попытаемся осознать ее важность.
\[P(A|B) = \frac{\color{red}{P(A)}\color{blue}{P(B|A)}}{ \underbrace{P(B)}_{ \color{red}{P(A)}\color{blue}{P(B|A)} + \color{red}{P(A^c)}\color{blue}{P(B|A^c)}}}\]
Для контрастности, синим цветом мы выделили условные вероятности, а красным - безусловные. Это так называемая формула Байеса. Ее принципиальная значимость в том, что она позволяет рассчитать вероятность типа \(P(А|B)\) на основе вероятностей типа \(P(B|A)\) - то есть как бы “развернуть” задачу задом наперед. Мы изначально знали вероятности положительного теста при беременности. А благодаря формуле рассчитали вероятность быть беременной при положительном тесте.
А еще задумайтесь об этой задаче следующим образом. Мы изначально (априори) знали вероятность беременности \(P(A)\). Затем мы получили новую информацию — положительный тест — и смогли рассчитать обновленную вероятность \(P(A|B)\).
Формула Байеса может быть расширена до ситуаций, в которых больше двух альтернатив, и в целом служит основным механизмом, через который новая информация инкорпорируется в модель и “обновляет” априорные вероятности.
Давайте для закрепления рассмотрим пример с тремя изначальными альтернативами.
Пример с завтраками
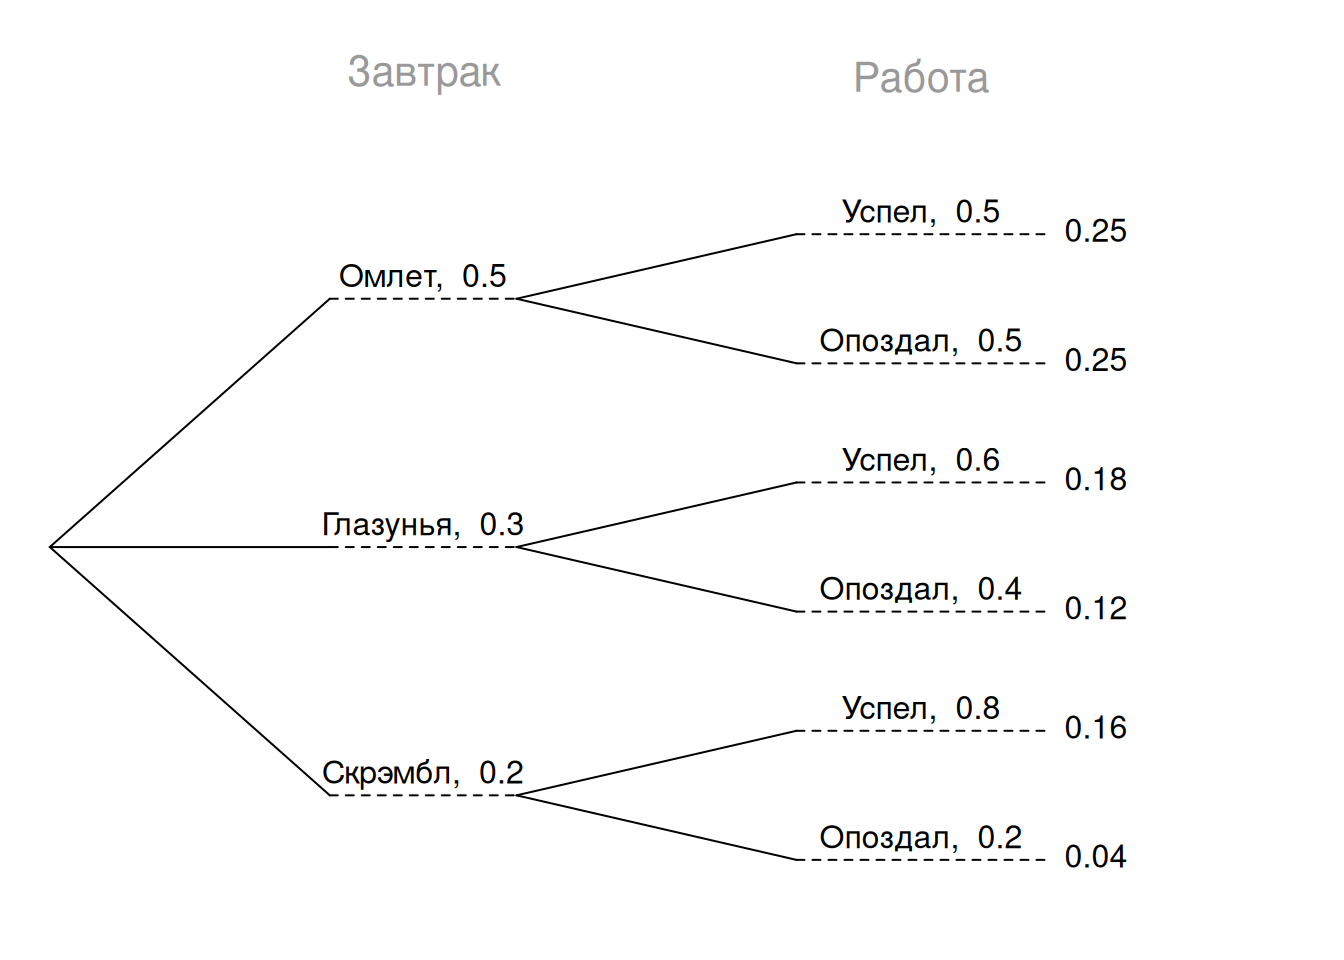
Допустим, у нас есть человек, который перед работой с заданными вероятностями готовит один из трех завтраков: омлет (\(А_1\)), глазунью (\(А_2\)), или скрэмбл (\(А_3\)).1 Приготовление занимает разное время, поэтому человек опаздывает на работу с вероятностью, которая зависит от завтрака.
Мы знаем все \(P(A_i)\) и \(P(B|A_i)\)
Представим, что в один день мы видим человека на работе вовремя и ставим грандиозный исследовательский вопрос — что он ел на завтрак? Сможем ли мы, зная априорные вероятности (\(P(A_i)\)) и вероятности опоздать при разных сценариях (\(P(B|A_i)\)), понять, взбивал ли он омлет, ждал ли глазунью, или довольствовался скрэмблом?
Оказывается можем и достаточно быстро. Во-первых, мы можем посчитать совместные вероятности типа \(P(A_i \cap B)\)
По определению, \(P(A_i|B) = \frac{P(A_i \cap B)}{P(B)}\), переставляя элементы получаем \(P(A_i \cap B) = P(A_i)P(B|A_i)\)
И в итоге имеем,
- \(P(A_1 \cap B) = P(A_1)P(B|A_1) = 0.25\)
- \(P(A_2 \cap B) = P(A_2)P(B|A_2) = 0.18\)
- \(P(A_3 \cap B) = P(A_3)P(B|A_3) = 0.16\)
Далее замечаем, что \(B = (A_1 \cap B) \cup (A_2 \cap B) \cup (A_3 \cap B)\), что на человеческий можно перевести как “прийти вовремя = поесть омлет И прийти вовремя + поесть глазунью И прийти вовремя + поесть скрэмбл И прийти вовремя”.
Поэтому:
\[\begin{align*} P(B) &= P(A_1 \cap B) + P(A_2 \cap B) + P(A_3 \cap B) \\ &= P(A_1)*P(B|A_1) + P(A_2)*P(B|A_2) + P(A_3)*P(B|A_3) \\ &= 0.25 + 0.18 + 0.16 \\ &= 0.59 \end{align*}\]
Событие \(B\) произошло, можем ли мы теперь пересмотреть вероятности \(P(A_i)\)? Да! Обозначим их \(P(A_i|B)\) и заметим, что \[P(A_i|B) = \frac{P(A_i)*P(B|A_i)}{P(B)} = \frac{P(A_i)*P(B|A_i)}{\sum_j{P(A_j)*P(B|A_j)}}\]
Подставляя \(P(A_i)P(B|A_i)\) для конкретных сценариев развития, обновляем вероятности.
\(P(A_1|B) = \frac{P(A_1)*P(B|A_1)}{\sum_{j=1}^{3}{P(A_j)*P(B|A_j)}} = 0.42\)
\(P(A_2|B) = \frac{P(A_2)*P(B|A_2)}{\sum_{j=1}^{3}{P(A_j)*P(B|A_j)}} = 0.31\)
\(P(A_3|B) = \frac{P(A_3)*P(B|A_3)}{\sum_{j=1}^{3}{P(A_j)*P(B|A_j)}} = 0.27\)
Мы видим, что формула Байеса позволила нам пересчитать изначальные, априорные вероятности с учетом новой информации.
Независимость
Понятие независимости между событиями является одним из самых важных в статистике. На допущении о независимости наблюдений строится подавляющее большинство статистических методов (та же линейная регрессия). Давайте попробуем понять, что это такое, начав с простого примера.
Допустим, я опять подбрасываю честную монетку. Вероятность орла равна \(1/2\). А теперь я ввожу дополнительную информацию: идет дождь! Изменится ли условная вероятность “орла” после этого? Интуитивно, не должна - бросок монетки и дождь вещи не связанные; независимые, могли бы мы сказать.
Давайте попробуем выразить эту интуицию с помощью математики. Пусть \(A\) - это бросок монетки (орел), а \(B\) - это событие “идет дождь”. Формально, мы сказали, что
\[P(A|B) = P(A)\]
То есть, условная вероятность “орла” равна его же безусловной вероятности. Простыми словами, идет ли дождь, не идет ли дождь, для монетки - это не играет никакой роли. И это один из способов сказать, что события независимы.
Все было бы хорошо, но есть раздражающая деталь. Формально, условная вероятность - это отношение, которое требует, чтобы условие имело ненулевую вероятность.
\(\frac{P(A \cap B)}{P(B)}\) требует, чтобы \(P(B)\neq0\), иначе чуда не произойдет. В принципе - это не такая уж и большая проблема, но математики педанты и хотят, чтобы их определения не имели дополнительных условий. Поэтому они немного переставили местами числители и знаменатели.
\(\frac{P(A \cap B)}{P(B)} = P(A) \rightarrow P(A \cap B) = P(A)P(B)\)
И заметили, что аналогичное выражение, не требует условий
\[P(A \cap B) = P(A)P(B)\]
Так что именно это выражение формально считается определением независимости. Простым языком,
Два события независимы, когда их совместная вероятность равна произведению их безусловных вероятностей.
Разберем на числах, как это определение отличает независимость от зависимости.
\(А\) - в городе снег; \(B\) - орел при броске монетки
\(P(A) = 0.1\), а \(P(B|A) = 0.5\) — снег никак не влияет на монетку, поэтому \(P(A \cap B) = P(A)*P(B|A) = 0.05\)
Но также и \(P(A) * P(B) = 0.1 * 0.5 = 0.05\) — произведение безусловных вероятностей дает то же число: события независимы
А теперь пусть \(С\) - пробки, и \(P(C) = 0.2\), но \(P(C|A) = 0.5\) — в снегопад пробки вероятнее
Тогда \(P(A\cap C) = P(A)*P(C|A) = 0.05\)
Но \(P(A)*P(C) = 0.1*0.2 = 0.02 \neq 0.05\) — произведение безусловных вероятностей НЕ совпадает с совместной: события зависимы
Упражнения
У1. Около \(9\%\) людей являются левшами. Предположим, что из населения Казахстана случайным образом выбраны \(2\) человека. Поскольку выборка намного меньше популяции (т.е. населения), можно считать эти два наблюдения независимыми. (a) Какова вероятность того, что оба человека являются левшами? (b) Какова вероятность того, что оба являются правшами?
Ответы:
a) \(P(Левша \cap Левша) = P(Левша)P(Левша) = 0.09 * 0.09 = 0.0081\)
b) \(P(Правша \cap Правша) = P(Правша)*P(Правша) = (1 - 0.09) * (1-0.09) = 0.8281\)
У2. Теперь мы выбрали \(5\) случайных людей
Какова вероятность что все окажутся правшами?
Какова вероятность что все окажутся левшами?
Какова вероятность, что не все окажутся правшами?
Ответы:
a)
\[\begin{align*} P(\textrm{все пятеро правши}) &= P(\textrm{первый = правша, второй = правша, ..., пятый = правша}) \\ &= P(Правша)\times P(Правша)\times \dots \times P(Правша) \\ &= 0.91\times 0.91 \times 0.91 \times 0.91 \times 0.91 \\ &= 0.624 \end{align*}\]
b) По аналогичной логике: \(0.09^5 = 0.0000059\)
c) Используя дополнение \(P(\textrm{Не все правши}) = 1 - P(\textrm{все правши}) = 1 - 0.624 = 0.376\)
Формально, мы могли бы записать это как \(\{A_1, A_2, A_3\}\): \(A_1 \cup A_2 \cup A_3 = \Omega\) и \(A_i \cap A_j = \emptyset, \forall i \neq j\). Это называется разбиением (partition) пространства исходов.↩︎