2 Обследование и Эксперимент. Выборка и Популяция.
Обследования и Эксперименты
Обследования и эксперименты — это два больших типа дизайна исследования. Под дизайном здесь понимается то, каким образом собираются данные. Сильно упрощая, обследования — это когда данные наблюдаются “как есть”. То есть данные производятся неким внешним процессом, над которым у исследователя нет контроля. Типичным примером обследований является опрос.
Может показаться, что опрос не самый удачный пример, так как опросные данные действительно собираются — интервьюер заносит ответы респондента в анкету. С теоретической точки зрения, однако, важно то, что мы даем респонденту возможность отвечать, не вмешиваясь в процесс.
В отличие от обследования, эксперимент — это дизайн, в котором обязательно присутствует случайное, экспериментальное воздействие. В самом простом случае выборка случайным образом делится на контрольную и экспериментальную группы.
Обследования и эксперименты принципиально отличаются тем, что в первых можно установить только статистическую ассоциацию или корреляцию, а во вторых — причинно-следственную связь. Например, если мы соберем данные о ВВП и средней продолжительности жизни, то есть проведем обследование, и обнаружим, что в странах с более высоким ВВП люди в среднем живут дольше, — мы все еще не можем утверждать, что повышение ВВП приводит к увеличению продолжительности жизни (каузальная связь).
Эксперименты, напротив, позволяют выявлять причинно-следственные связи. Например, если бы мы каким-то искусственным образом повысили ВВП случайно выбранных стран, а затем увидели бы, что продолжительность жизни там выросла, — это позволило бы нам утверждать, что ВВП помогает людям жить дольше.
Пример с ВВП не самый очевидный, поэтому давайте рассмотрим еще один пример с нашей любимой популяцией — студентами.
Сон и оценки
Нас интересует, как режим сна связан с успеваемостью студента. Типичное обследование могло бы выглядеть так. Мы опрашиваем некоторое число случайных студентов: фиксируем, как рано они просыпаются и каков их GPA. Если окажется, что “жаворонки” учатся лучше “сов”, значит, раннее пробуждение коррелирует с успеваемостью.
Типичный эксперимент, в свою очередь, мог бы выглядеть так. Мы берем выборку случайных студентов, а затем еще раз случайным образом делим их на две группы. Первую группу, экспериментальную, заставляем просыпаться рано — это наше воздействие. Второй группе позволяем вести себя как обычно. Если затем студенты из экспериментальной группы начинают учиться лучше, мы можем утверждать, что раннее пробуждение влияет на успеваемость.
Принципиальная разница между двумя дизайнами в том, что решение, когда просыпаться, в эксперименте навязывается извне, а в обследовании — нет. Но почему именно это случайное экспериментальное воздействие связано с каузальностью?
В обследованиях мы не контролируем другие факторы, которые могут одновременно влиять на зависимую и независимые переменные. Например, могло так статься, что студенты, которые регулярно тренируются, одновременно и просыпаются раньше, и учатся лучше. На их успеваемость влияет внешний фактор — занятие спортом, которое также определяет режим сна и создает видимость связи между сном и успеваемостью. Такие внешние переменные, которые влияют как на отклик, так и на предиктор, называются спутывающими переменными (confounding variables). Проблема обследований в том, что мы никогда не сможем учесть все потенциальные спутывающие переменные — соответственно, всегда остается шанс, что некое ненаблюдаемое внешнее воздействие на обе переменные создает видимость связи. Иначе говоря, мы не можем отделить эффект интересующей нас переменной от эффекта других факторов.
Но почему эксперименты позволяют обойти эту проблему? Решение в случайном воздействии. Наша выборка случайным образом делится на тех, на кого воздействуют, и тех, с кем ничего не происходит. Поскольку деление случайно, эти две группы в среднем идентичны во всем, включая все наблюдаемые и ненаблюдаемые характеристики. Единственное, что их различает, — это то, что одних заставляют просыпаться рано, а других нет. И если мы видим разницу в оценках между группами, мы вправе приписать ее раннему пробуждению — не будь его, между группами не было бы разницы.
Популяция и выборка
К другим важным элементам дизайна исследования относятся популяция и выборка. Мы уже упоминали оба термина неформально — это отчасти оправдано тем, что за ними стоят интуитивно понятные идеи. Сейчас же пришло время немного уточнить смысл этих понятий.
Допустим, мы хотим оценить процент жителей Астаны, которые регулярно добираются до работы на общественном транспорте. Вопросы подобного рода предполагают, что идеальным сценарием было бы опросить каждого из работающих жителей Астаны. Практически это невозможно, но идея в том, что, если бы у нас был «доступ ко всем», мы смогли бы ответить на поставленный вопрос однозначно. Так вот, множество потенциальных наблюдений, которое составляет всё, что нам в теории нужно, называют популяцией или генеральной совокупностью. Популяция — это все то, что может быть наблюдением.
Поскольку опросить ВООБЩЕ ВСЕХ невозможно, мы берем из популяции выборку — некое подмножество генеральной совокупности. На основе выборки мы делаем вывод о всей популяции. Например, если в выборке на автобусах ездят \(37\%\) людей, то и во всей популяции доля автобусников была бы где-то в этих пределах.
Возникает вопрос: а как понять, что выборка дает нам право обобщать до всей популяции? Очевидно, что собрать выборку можно многими способами — есть ли среди них лучший? Давайте разберемся на примерах. Подумайте о следующих вариантах выборок:
опросить своих друзей.
открыть онлайн-опрос и прорекламировать его в медиа.
встать у входа в торговый центр и опрашивать каждого десятого входящего.
выбрать 25 случайных адресов в каждом из районов Астаны и позвонить жильцам.
через базу данных физических лиц, проживающих в Астане, выбрать 100 случайных ИИН (подходящих по возрасту) и связаться с этими людьми.
Какие из этих стратегий вам кажутся лучше?
Репрезентативность
Хорошая выборка должна отражать структуру популяции. Если в популяции \(37\%\) людей ездят на работу на автобусе, то в хорошей выборке пропорция должна быть похожей. Когда структура выборки повторяет структуру популяции, мы называем ее репрезентативной. В таких случаях то, что мы видим в выборке, может быть обобщено на популяцию.
Как получить репрезентативную выборку? Каждый объект в популяции должен иметь равные шансы попасть в выборку или, другими словами, выборка должна быть полностью случайной. Такую выборку так и называют — простая случайная, и это, что называется, золотой стандарт. На практике, как обычно, добиться полной случайности непросто, поэтому существуют компромиссные стратегии. Например, стратифицированная или кластерная выборки. В первой вы разбиваете популяцию на однородные группы — страты — а затем случайно из них выбираете. Во втором случае вы разбиваете на разнородные группы — кластеры — и случайным образом выбираете либо кластеры как единое целое, либо случайным образом выбираете из кластеров.
Что еще зависит от выборки? Немного забегая вперед — от характера выборки зависит погрешность. Для простой случайной она будет минимально возможной и легко считаемой. Для более сложных выборочных дизайнов (со стратами или кластерами) погрешности будут считаться по более запутанным формулам. Для понимания базовых идей статистики они не нужны, поэтому мы везде в дальнейшем будем предполагать, что наша выборка простая и случайная.
Немного о том, как испортить выборку
Прежде чем идти дальше, немного обсудим плохие выборки. На самом деле выборку делает плохой всего лишь одна вещь — неслучайность. То, откуда она обычно берется, дало возможность выделить три типа плохих выборок:
Доступная выборка (convenience sampling). Например, когда вы опрашиваете только своих друзей.
Добровольная выборка (voluntary response sample). Добровольная выборка — это проблема всех онлайн-опросов, поскольку тут вероятность участия может зависеть от характеристик респондентов. Например, если разместить онлайн-опрос «Поддерживаете ли вы ужесточение наказания за жестокое обращение с животными», то с большей вероятностью вы получите ответы от людей, для которых это является важной темой.
Выборка без ответов (non-response sampling). Например, когда вы задаете чувствительные вопросы, и люди на них не отвечают.
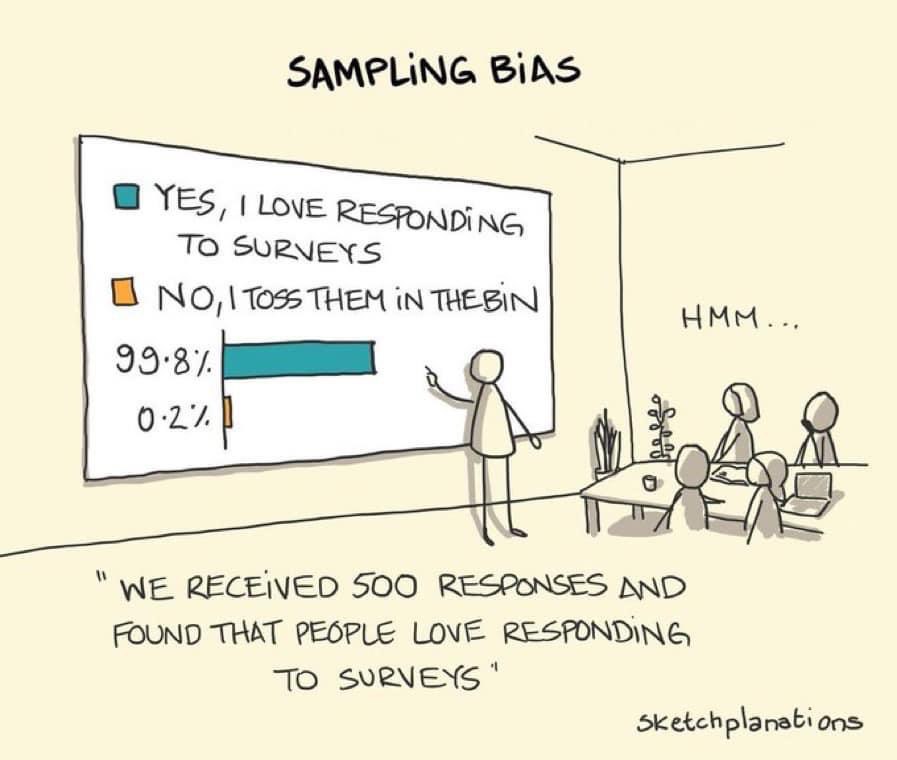
Исторически плохая выборка: Лэндон против Рузвельта
Плохих выборок довольно много, но редко случаются выборки настолько плохие, что стоят репутации целого журнала. Дело происходило в 1936 году — выборы президента США: республиканец Альфред Лэндон против инкумбента-демократа Франклина Делано Рузвельта.
Популярный журнал того времени, The Literary Digest, рассылает около 10 миллионов анкет по всей стране с просьбой указать, за кого получатель собирается голосовать. Получив около 2,4 миллиона ответов и каким-то образом обработав их, журнал заключает, что Лэндон, вероятно, победит с 57% голосов. На выборах Рузвельт выигрывает с огромным перевесом (62% голосов). Разница в 20% между прогнозом и реальностью очень сильно подорвала доверие читателей к журналу, и в 1938 году он был продан.1
Что делает этот случай интересным - это то, что выборка, на основе которой делался злополучный прогноз, была чудовищно большой даже по современным меркам. Казалось бы, \(2.4\) миллиона респондентов не могут ошибаться, даже если они не совсем репрезентативны популяции. Однако, как видно в ретроспективе, размер выборки не гарантирует надежных предсказаний.
В популярном воображении закрепилось мнение, что ошибка возникла потому что журнал рассылал анкеты своим подписчикам, зарегистрированным автовладельцам и домохозяйствам с установленным телефоном. В середине 30-х США переживали один из самых серьезных экономических кризисов в своей истории (Великая Депрессия) и критерии по которым формировалась выборка как будто бы указывали на людей высокого достатка, склонных поддерживать кандидата-республиканца.
Более детальные исследования указывают, что скорее всего смещение выборки возникло из-за систематического “не-ответа” большей части опрошенных.2 Как мы видим, плохие выборки - это продукт нескольких причин.
Выборочная статистика vs. Популяционный параметр
Давайте разберем пример с выборами с формальной точки зрения и заодно введем важные понятия, которыми активно будем пользоваться в дальнейших главах книги. Наш злополучный журнал хотел оценить, какая доля людей в генеральной совокупности будет голосовать за Рузвельта (или Лэндона). Обозначим эту долю как \(\mu\), а большой буквой \(N\) обозначим общее число людей в популяции, то есть общее число американцев с правом голоса. Формально журнал хотел знать
\[\mu = \frac{\sum_{i=1}^{N}x_i}{N} \\ \textrm{— истинный и неизвестный популяционный параметр}\]
Для оценки параметра журнал собрал выборку, обозначим ее размер как \(n\), и посчитал выборочную статистику (т.е. долю людей в выборке, которые планируют голосовать за Рузвельта). Обозначим ее как \(\overline{x}\)
\[\bar{x} = \frac{\sum_{i = 1}^{n}x_i}{n} \textrm{- выборочная статистика}\]
Теперь, что называется, прочувствуйте разницу. Выборочная статистика - известна, ее мы только что посчитали. А популяционный параметр - не известен, у нас нет доступа ко всей генеральной совокупности. При этом выборочная статистика оценивает популяционный параметр. Она есть наша лучшая догадка о неизвестном параметре. То что это оценка подразумевает, что есть и погрешность.
Большая часть математической статистики как раз про то, как количественно охарактеризовать эту погрешность — насколько далеко выборочная статистика может случайно уйти от настоящего параметра.
Случайность и погрешность появляются из-за процедуры выборки, в нее попадают разные наблюдения. Если выборка хорошая, то есть полностью случайная, наблюдения в нее попадают разные, со всех концов спектра, и результирующее среднее дает нам хорошее представление обо всей совокупности.
В плохих выборках, где не у всех наблюдений есть равный шанс попасть в выборку, выборочная статистика может уйти очень и очень далеко от истинных значений параметра.
Разграничение между (выборочной) статистикой и параметром принципиально важно. В дальнейших главах мы уточним и расширим это разграничение, а пока договоримся об обозначениях. Формально, статистики всегда будут обозначаться латинскими буквами, например выборочное среднее будет \(\overline{x}\), а выборочная пропорция \(\hat{p}\). Для популяционных параметров будем использовать греческие буквы, например, популяционное среднее \(\mu_{x}\).
А теперь очень важная идея! А также маленький тизер следующих глав! Представим мысленный эксперимент: мы берем новую выборку и считаем на ней среднее. Примет ли оно новое значение - да, скорее всего - выборка случайна, в нее попадут новые наблюдения и вероятно их среднее будет неким новым числом. А если мы соберем еще одну выборку, а затем еще, а затем повторим всю процедуру бесконечное число раз. Выйдет так, что выборочная статистика будет варьироваться в неких пределах. Величины, которые обладают этим свойством — изменяться при повторе выборки — называются случайными переменными (random variable). Например, выборочное среднее \(\overline{x}\) - это случайная переменная, она меняется от выборки к выборке, как и выборочная пропорция, как и многие, многие другие величины, которые можно рассчитать на основе выборки.
А вот, популяционный параметр - это константа: настоящее популяционное среднее фиксировано. Оно неизвестно, но будь у нас доступ ко всем наблюдениям - мы могли бы его посчитать, а так - увы. И, очень важная идея - выборочная статистика приближенно оценивает популяционный параметр.
Упражнение
В неком социальном опросе у казахстанцев спрашивали, как много времени в день они проводят в социальных сетях. Для выборки из 1000 взрослых казахстанцев среднее время составило 2.5 часа.
Определите, что является а) наблюдением, б) переменной, в) выборочной статистикой и г) популяционным параметром
Казахстанец_ка
Среднее время в социальных сетях для 1000 опрошенных
2.5 часа
Среднее время в социальных сетях для всех взрослых казахстанцев
В защиту the Literary Digest надо заметить, что подобные опросы журнал проводил начиная с 1916 года, и до того судьбоносного момента не ошибался.↩︎
PEVERILL SQUIRE, WHY THE 1936 LITERARY DIGEST POLL FAILED, Public Opinion Quarterly, Volume 52, Issue 1, SPRING 1988, Pages 125–133, https://doi.org/10.1086/269085↩︎