8 Дискретные случайные переменные
Случайные переменные
Спустимся немного с небес теории вероятности в более земные дела. Начнем с вопроса: является ли «дискретное» синонимом «целого»? Дискретные переменные очень часто выражены целыми числами, поэтому иногда возникает обманчивое впечатление, что это одно и то же. На самом деле дискретная переменная — это любая переменная, у которой есть «провалы» между возможными значениями. Вспомните пример с размером обуви из первой главы: размеры могут быть выражены дробными числами — 37,5, 38 — но у них есть определенный шаг, инкремент 0,5. Между этими значениями провал: переменная не может принять значение вроде 37,85. Если такое происходит, переменная называется дискретной. Непрерывные переменные потому и называются непрерывными, что у них, как говорят по-английски, infinite precision: между любыми двумя рядом стоящими вещественными числами всегда найдется еще одно (есть, кстати, такая теорема в матанализе).
Формальное определение нам пока не нужно, достаточно неформального. Представьте, что у вас есть случайный эксперимент, и он может завершиться каким-то числом. Если между возможными числами есть провалы — пусть даже самих чисел бесконечно много — перед нами дискретная случайная переменная.
Классический пример. У нас есть группа студентов, мы случайным образом кого-то выбираем и фиксируем его рост — это случайная переменная. Фиксируем его вес — это тоже случайная переменная. Заметьте: на основе одного и того же случайного события (мы вытащили случайного студента) можно построить несколько случайных переменных. Чисто формально, если вам нравится разбираться в математической нотации, случайная переменная — это функция, которая элементам пространства возможных исходов ставит в соответствие некое число. Вот и все, такое вот очень простое генеральное определение. Для себя, на уровне практических соображений, я определяю это так: мы берем и «оцифровываем» наш случайный эксперимент.
- У нас есть группа студентов, обозначим их для удобства буквами, \(\Omega = \{a, b, c, ..\}\)
- Случайное событие - выбираем случайного студента и фиксируем его рост
- Например, был выбран студент \(a\) с ростом \(h_a = 182\) (см)
- В другой раз мог бы быть выбран студент \(c\) с ростом \(h_c = 150\)
- Рост каждого студента это некое число \(h\). Но рост случайного студента - это случайная переменная, \(H\)
Формально это записывается так:
- \(H\) - это объект, чье значение определено как только мы знаем результат случайного события (т.е. студента, который был выбран)
- В этом смысле, \(H\) является функцией случайного события: \(H: \Omega \rightarrow H(\omega) = h\)
- Случайная переменная “дает” численное значение результату случайного события
Функция вероятности (PMF)
Хорошо, допустим, у нас есть случайная переменная, и она принимает дискретные значения (для простоты разговора можно считать, что целые). Мы бы хотели понять, какие значения более вероятны, а какие менее. Как только вы начинаете отвечать на этот вопрос, вы, по сути, задаете распределение вероятности: вам надо решить, куда поместить больше вероятности, а куда — меньше. В самом простом случае вероятности распределяются методом простого перечисления, перебора.
Когда мы работаем со случайными переменными, нам нужен механизм, по которому будет распределяться вероятность. Для дискретных переменных таким механизмом является PMF (Probability Mass Function). PMF — это способ сказать, с какой вероятностью случится каждое возможное значение дискретной случайной переменной. Как только мы начисляем значениям случайной переменной вероятности по какому-то правилу — неважно по какому, оно может быть максимально тупым, — мы фактически задаем PMF: функцию, которая значению дает вероятность.
У PMF есть очень простое свойство. Если вы просуммируете все вероятности, которые раздали значениям, вы должны снова получить единицу. Вы начали с одного «юнита» вероятности и распределили его между значениями — если собрать все назад, дебет с кредитом должен сойтись. И еще одна простая логика: чем выше вероятность определенного исхода, тем чаще он будет у вас появляться, если наблюдать за переменной достаточное количество раз.
Самый простой пример. Представьте, что мы подбрасываем игральную кость. Возможные результаты — 1, 2, 3, 4, 5 или 6. Когда мы бросали кубик, мы неявным образом решили, что все эти исходы имеют равные вероятности: PMF говорит нам, что вероятность каждого из этих чисел — 1/6, если кость честная.
Можно представить PMF как таблицу:
| Значение (x) | 1 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|---|
| P(X = x) | 1/6 | 1/6 | 1/6 | 1/6 | 1/6 | 1/6 |
Главное:
PMF используется для дискретных значений (то есть, тех, что можно перечислить).
Сумма всех вероятностей всегда равна 1.
Чем больше вероятность у какого-то значения, тем чаще оно встречается в большом количестве наблюдений.
Другой пример. Допустим, вы бросили монетку три раза. Типичный элемент пространства исходов — последовательность орлов и решек; я тут буду писать в английской традиции, поэтому это будут heads (H) и tails (T). Типичный исход мог бы быть HHT. Давайте попробуем конвертировать этот исход в некое число. Пусть переменная \(X\) считает, сколько раз в последовательности бросков выпал орел. И давайте условимся, что орел мы будем считать «успехом»: мы наблюдаем за неким случайным событием, иногда оно происходит, иногда не происходит; когда происходит — называем это успехом.
Какие значения может принимать наша \(X\)? От 0 до 3: в трех последовательных бросках может быть 0 успехов, 1 успех, 2 успеха или 3 успеха. Это и будет пространство возможных значений переменной \(X\). Для исхода HHT переменная \(X\) принимает значение 2. Видите, как это работает: случайная переменная на вход принимает случайный исход, а на выходе приписывает ему какое-то число.
Небольшой нюанс про обозначения. Саму случайную переменную — вот эту абстрактную машину, которая выбрасывает вам разные значения, — мы будем обозначать заглавной латинской буквой, например \(X\) или \(Y\). А ее конкретное значение — строчной. Иногда я буду писать, например, что \(X = x\). Это звучит немного нелепо, как будто я занимаюсь тавтологией, но на самом деле \(X\) большая и \(x\) маленькая — это две разные сущности: \(X\) — это функция, машина, которая выбрасывает значения, а \(x\) — конкретное число, которое нам довелось увидеть. Например, запись \(X = 3\) не значит, что \(X\) всегда равна 3 — это значит, что в этом конкретном случае, когда мы за ней наблюдали, переменная приняла значение 3. Я мог бы даже написать «вероятность того, что \(X\) примет значение 3», \(P(X = 3)\), — и это будет уже некое число. А вместо тройки можно подставить, например, двойку — и получить какую-то другую вероятность. Разграничение придумали именно для этого: отделять конкретное значение, которое мы наблюдаем в данном случае, от случайной переменной как абстрактной сущности, которая эти значения выбрасывает.
- Мы бросили монетку 3 раза
- Типичный элемент Пространства Исходов, \(\Omega\), выглядит как \(\omega = HHT\)
- Теперь введем переменную \(X\) - сколько раз выпал “орел”
- \(X\) может принимать значения от \(0\) до \(3\). Например, \(X(HHT) = 2\)
- Случайная переменная обозначается заглавной буквой, например \(X\), ее значения, строчной - \(x\)
- \(X = x\) значит, что переменная \(X\) приняла значение \(x\)
Функция случайной переменной
Теперь немного загадочное свойство случайных переменных, которое станет намного понятнее позже: любая функция случайной переменной тоже является случайной переменной. Допустим, вы бросаете кубик, и \(X\) — это число, которое вы получили. Если вы это число возведете в квадрат, новая переменная — обозначим ее \(Y\) — тоже будет случайной. Почему? Потому что \(Y\) будет принимать случайные значения, причем с теми же вероятностями, с какими \(X\) принимает свои.
Давайте быстро покажу. Вот PMF для \(X\): значения 1, 2, 3, 4, 5, 6, каждое с вероятностью 1/6. \(Y\) у нас — это \(X\) в квадрате: если \(X\) принимает значение 1, то \(Y\) принимает то же значение в квадрате. Соответственно, возможные значения \(Y\) — это 1, 4, 9, 16, 25, 36. И попадаться они будут с той же вероятностью 1/6: сами вероятности не изменились, изменились только числа, которые принимает переменная. Это работает для любых функций, которые мы можем себе придумать — логарифм, экспонента, синусоиды, косинусоиды, что угодно, — и для любой комбинации этих функций.
Любая функция случайной переменной, сама является случайной переменной
Например, \(X\) - бросок кубика, \(Y = X^2\) - результат этого же броска в квадрате, тоже случайная переменная
Другой пример функции от случайных переменных — индекс массы тела. Мы могли бы его сконструировать так: выбираем случайного человека, регистрируем его рост — одна случайная переменная, регистрируем его вес — другая случайная переменная. Если мы теперь поделим вес на квадрат роста, то получим еще одну случайную переменную, которая тоже будет варьироваться от человека к человеку.
- Другой пример: \(H\) - рост случайного человека, \(W\) - вес случайного человека. \(U = W/H^2\) - индекс массы тела случайного человека - тоже случайная переменная
Формальная запись PMF
PMF — это распределение вероятности по значениям. Формально мы будем записывать ее следующим образом: маленькая \(p\) означает распределение вероятности, нижним индексом я буду обозначать, к какой переменной она относится, а внутри скобок будет стоять значение — отражая тот факт, что это функция. Запись \(p_X(x)\) закрывается выражением «вероятность того, что переменная \(X\) приняла значение \(x\)».
- PMF of \(X\) - это просто распределение вероятности по значениям \(X\)
- Например, у нас три студента \(\{a, b, c\}\) и случайная переменная \(X\) , которая дает нам рост случайного студента. Допустим, \(x_a = 153, x_b = 175, x_c = 175\)
- Вероятность \(P(X = 153) = 1/3\), а вероятность \(P(X = 175) = 2/3\)
- PMF - это функция, которая для любого \(x\) дает вероятность \(P(X = x)\)
- Формально, \(p_X(*): X \rightarrow [0,1]\)
- PMF записывается как \(p_X(x) = P(X = x)\)
Пример: сумма двух кубиков
Давайте немного поупражняемся в том, как находить PMF и как они записываются. Случайное событие: мы бросаем два шестигранника. Пусть \(X\) обозначает первый бросок, \(Y\) — второй. Каждый исход равновероятен: например, вероятность того, что \(X\) принял значение 1 и \(Y\) принял значение 2, равна \(1/36\) — и так для всех возможных пар.
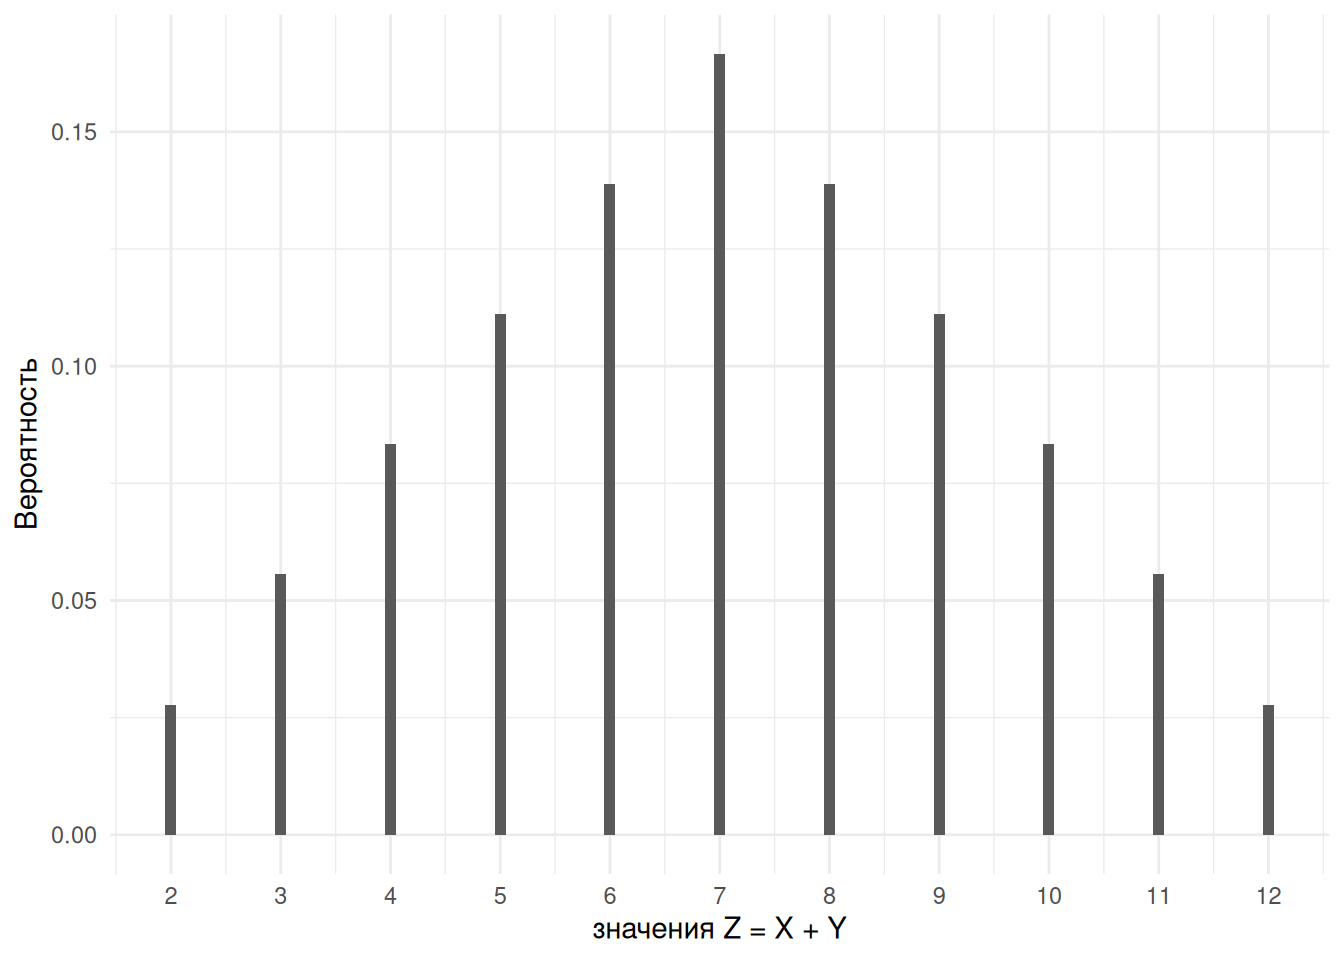
Введем новую переменную \(Z = X + Y\) — просто сумма двух бросков. У нее есть вполне практическое применение: во многих настольных играх именно столько очков вы можете пройти за ход. Давайте найдем PMF для этой новой переменной, то есть \(p_Z(z)\).
Сначала перечислим все возможные значения, которые может принимать \(Z\): от 2 (две единицы) до 12 (две шестерки) и все, что между ними. Как считаем PMF? Фиксируем значение \(z\) и выбираем все пары \(x, y\), для которых \(Z\) принимает это значение. Начнем с двойки: такая пара одна — \((1, 1)\), событие может произойти только в одной ситуации, соответственно, его вероятность \(1/36\). Теперь \(z = 3\): сколько пар в сумме дают 3? Две — \((2, 1)\) и \((1, 2)\), соответственно, вероятность будет \(2/36\).
Обратите внимание на запись: я пишу \(p_Z(2)\) — PMF, которая связана с переменной \(Z\); внутри скобок у меня значение переменной, а снаружи — вероятность, связанная с этим значением. Так работают функции: у них есть вход, и каждому входу они ставят в соответствие какой-то выход.
А теперь представьте, что вы играете в кости: бросаете две кости и должны сделать ставку на их сумму. На что стоит ставить, чтобы максимизировать свой выигрыш? На семерку — она будет выпадать чаще всего.
- Случайное событие: два броска шестигранного кубика (2d6) \(X\) - первый бросок, \(Y\) - второй бросок
- Каждый исход равновероятен
- например, \(P(X = 1, Y = 2) = 1/36\)
- Введем новую переменную \(Z = X + Y\), найдем \(p_Z(z)\) для всех \(z\)
- \(z \in \{2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12\}\)
- фиксируем \(z\):
- выбираем все пары \(x, y\) для которых \(z = x + y\)
- складываем соответствующие вероятности \(P(X = x, Y = y)\)
- Например, \(p_Z(2) = P(Z = 2) = 1/36\), \(p_Z(3) = P(Z = 3) = 2/36\), …
Теперь попробуем визуализировать PMF, то есть распределение этой случайной переменной. По оси X у нас возможные значения переменной, по оси Y — соответствующие вероятности. И мы видим что-то, что подозрительно напоминает нормальное распределение, только его дискретную вариацию. Это не случайно — чуть дальше мы узнаем, почему.
Задать распределение
Немного о терминологии. Когда я говорю «задать распределение», я имею в виду, что я задаю случайную переменную, и я имею в виду, что я задаю PMF. Это все синонимы. Знаете, как в советских школах учили: у Маяковского — «мы говорим Ленин, подразумеваем — партия, мы говорим партия, подразумеваем — Ленин». Вот тут у меня такая же формула, только трехчленная: говорю «распределение» — подразумеваю случайную переменную; говорю «случайная переменная» — подразумеваю PMF; говорю «PMF» — подразумеваю распределение.
Задать распределение = задать случайную переменную = задать PMF (!!!)
Это все синонимы
Зачем нужна PMF
Представьте себе, что есть какой-то случайный процесс, и вы смогли описать его с помощью какого-то закона. Что это значит? Это значит, что теперь вы можете найти ответы на любые интересующие вас вопросы — в частности, посчитать вероятность любых событий.
Лотерея и азартные игры (PMF)
Допустим, вы играете в лотерею, в которой можно выиграть 0, 1000 или 10 000 тенге. Обычно со стороны вы не знаете вероятности выигрышей: сколько билетов было выпущено с каким номиналом — собственно, на этом незнании лотереи и строятся. Теперь представьте, что вы знаете точное распределение, то есть PMF возможных выигрышей. Это дает вам козырь: вы можете рассчитать вероятность выиграть определенную сумму (например, каков шанс выиграть 1000 тенге или больше), посчитать свой потенциальный выигрыш и решить, стоит ли вообще вкладывать в эту затею деньги.
Оценки на экзамене (PMF)
Допустим, вы проводите экзамен в группе из 100 студентов, и оценки распределены дискретно между A, B, C, D, F. Если вы знаете — например, исходя из прошлого опыта — вероятности тех или иных оценок, вы можете посчитать, какой процент студентов получит пятерку, какой — четверку, и какой процент завалит курс. И заранее подготовиться к последствиям.
Распространенные дискретные распределения
Дискретных распределений вообще очень много, но, как правило, внимание заостряют на трех основных — прочие как будто бы композитно из них состоят.
Распределение Бернулли
Самое простое, самое приятное и то, которое постоянно используют для иллюстрации разных идей, — это распределение Бернулли, названное в честь Якоба Бернулли, швейцарского математика, между прочим. Оно очень простое. Опять-таки: когда я говорю «случайная переменная», первое, что должно всплывать у вас в голове — а где ее пространство исходов, из чего оно состоит? У Бернулли оно максимально простое: ноль и единица. Переменная может принимать только два значения: единицу она принимает с вероятностью \(p\), ноль — с вероятностью \(1-p\).
Поскольку число \(p\) задается извне, его называют параметром: это некое число, которое может варьироваться в определенных пределах, и исследователь сам решает, какое число ему нужно. Распределение Бернулли определяется всего лишь одним параметром, то есть задать распределение Бернулли означает задать \(p\). Что моделируется с помощью Бернулли? Классический пример — бросок монетки. Или «пойдет сегодня снег или не пойдет» — тоже Бернулли. Почему? Два варианта, и есть какая-то вероятность.
Кстати, про обозначение: если наша переменная распределена по закону Бернулли, мы обычно выражаем этот факт как \(X \sim Be(p)\). Тильда значит «распределена как», а в скобках указываем параметр — у Бернулли он один.
- Распределение Бернулли моделирует ситуацию, в которой у вас одно испытание и некое событие может произойти с вероятностью \(p\)
- Задается одним параметром: \(p \in [0,1]\)
- Чисто формально, на языке PMF записывается как:
\[\begin{align*} p_X(0) = 1-p \\ p_X(1) = p \end{align*}\]
Равномерное распределение
Другой пример — равномерное распределение: каждое из возможных значений происходит с равной вероятностью. Мы именно так бросали кубики. У равномерного распределения два параметра — начало интервала и конец интервала; соответственно, пространство возможных исходов — это все целые числа между этими двумя параметрами. Как посчитать PMF? Каждое значение имеет одну и ту же вероятность, поэтому в числителе будет единица, а делить надо на общее число значений. Сколько целых чисел между числами \(a\) и \(b\)? Несложно увидеть, что \(b - a + 1\): например, сколько целых чисел между единицей и шестеркой? \(6 - 1 = 5\), плюс 1 — шесть.
С помощью равномерного распределения часто моделируют ситуацию полного незнания: вы знаете возможные исходы, но ничего больше о них не знаете. Максимальная неопределенность достигается тогда, когда каждый из исходов равновероятен. Обозначается равномерное распределение так: \(X \sim U[a, b]\), где \(U\) — потому что uniform по-английски, и указаны два параметра, \(a\) и \(b\).
- Случайное событие: возьмем случайное целое число из интервала \([a, b]\)
- Параметры: \(a, b \in Z\)
- Пространство исходов: \(\{a, a+1, ..., b\}\), \(|\Omega| = b-a+1\)
- Случайная переменная \(X: X(\omega) = \omega\)
- \(p_X(x) = \frac{1}{b-a+1}, \forall x\)
- Модель максимальной неопределенности (незнания)
- e.g. мы знаем возможные исходы, но ничего об их вероятности
- Обозначается: \(X \sim U[a,b]\)
Биномиальное распределение
И, наконец, биномиальное распределение, с которым мы уже почти столкнулись. Допустим, у нас случайный эксперимент: мы бросаем монетку \(n\) раз. Пусть монетка немного нечестная, то есть орел выпадает с некоторой вероятностью \(p\), не обязательно 50%. Но это одна и та же монетка, поэтому в каждом испытании вероятность орла одна и та же. Случайная переменная, которая возвращает нам количество орлов — количество успехов — в такой последовательности независимых испытаний, называется биномиальной. Если бы у нас было три испытания, биномиальная переменная могла бы принимать значения от 0 до 3; если бы было 10 испытаний — от 0 до 10. Биномиальное распределение зависит от двух параметров: числа испытаний и вероятности успеха.
И, кстати, можете заметить, что между Бернулли и биномиальным есть некая связь. На самом деле все просто: Бернулли — это биномиальное распределение в ситуации, когда у вас всего лишь одно испытание. А биномиальное — расширение этой идеи: предположим, что у вас не одно испытание, а 10, 20, 100 испытаний. Сколько успехов вы можете ожидать, если успех в каждом новом испытании не зависит ни от чего, кроме вероятности успеха? Как говорится в учебниках, биномиальное — это модель числа успехов в последовательности идентичных и независимых испытаний.
- Событие: \(n\) бросков монетки, где \(P(Орел) = p\)
- Пространство исходов: последовательности “орлов” или “решек” длиной \(n\)
- n = 3: \(\omega = ООР\) или \(\omega = ОРО\)
- n = 10: \(\omega = РРООРООООР\)
- Случайная переменная \(X\): число “орлов” в последовательности
- если \(\omega = ООР\), то \(X(\omega) = 2\)
- если \(\omega = РРР\), то \(X(\omega) = 0\)
- Параметры:
- \(n \in Z^+; p \in [0,1]\)
- Модель числа “успехов” в последовательности идентичных и независимых испытаний
\[ p_X(2) = P(X = 2) = \\ P(ООР) + P(ОРО) + P(РОО) = \\ 3p^2(1-p) = \binom 3 2 p^2(1-p) \]
У биномиального распределения есть общая формула PMF. Знать ее наизусть не обязательно — просто покажу, что она есть и как выглядит. Она может показаться немного зловещей, но нужно уметь такие формулы «парсить», то есть видеть их составляющие. На самом деле она состоит из трех вещей.
\[ p_X(k) = \binom n k p^k(1-p)^{n-k}, \forall k = 0, 1, ..,n \]
Давайте прочитаем ее, немного поупражнявшись в переводе с математического на человеческий. Слева — вероятность того, что \(X\) примет значение некоего \(k\). Справа, в центре, стоит \(p^k\) — и мы уже видели что-то похожее: успехи не зависят друг от друга, каждый происходит отдельно, а всего у нас \(k\) успехов — соответственно, мы просто перемножаем вероятность успеха \(k\) раз. Дальше: если из \(n\) испытаний было \(k\) успехов, это автоматически означает, что было \(n-k\) неудач. Вероятность неудачи — \(1-p\), и она перемножается \(n-k\) раз: отсюда \((1-p)^{n-k}\). А вот штука впереди, \(\binom n k\), — это обозначение того, сколькими способами из \(n\) испытаний можно выбрать \(k\) успехов.
Давайте объясню на примере с тремя испытаниями. Вот у меня три испытания — первое, второе, третье, — я представляю их как три ячейки. Я знаю, что произошло два успеха, но у меня остается небольшая неопределенность: в каких позициях были успехи? Один вариант — успехи были первыми двумя, а третий бросок закончился неудачей. Вторая возможность: первый бросок был неудачей, а второй и третий — успехами. И третья возможность: первый — успех, второй — неудача, третий — успех. Итого три возможности. По сути, я спрашиваю: сколькими способами я могу из трех ячеек выбрать две, чтобы заполнить их моими успехами? Или — что то же самое — сколькими способами из трех ячеек выбрать одну, чтобы засунуть туда мою неудачу? Биномиальный коэффициент \(\binom n k\) — обобщение этой идеи. Его можно посчитать по очень простой формуле, но нам она, по большому счету, не нужна — просто умейте это правильно читать: сколькими способами \(k\) успехов можно распределить по \(n\) позициям.
- Что такое \(\binom n k\)?
- число способов выбрать \(k\) элементов из \(n\) элементов
\[ \binom n k = \frac{n!}{(n-k)!k!} \]
- Например, сколько есть способов выбрать 2 элемента из 3?
\[ \binom 3 2 = \frac{3!}{(3-2)!2!} = \frac{3*2*1}{1*2*1} = 3 \]
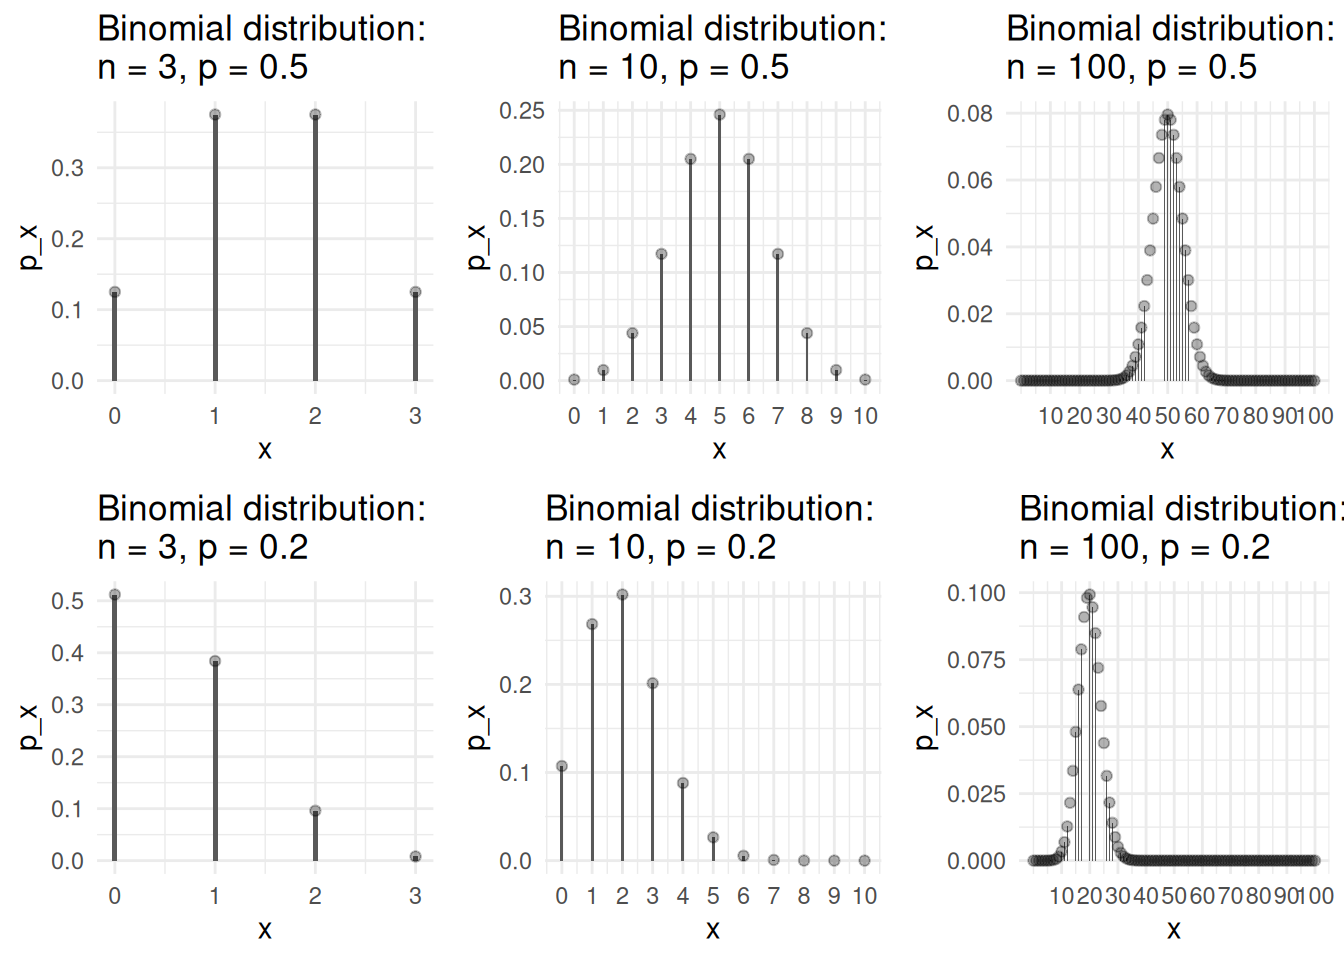
Ниже — иллюстрация биномиальных распределений для разных комбинаций параметров. Первый случай: три испытания, вероятность успеха 50%. Четыре возможных исхода, вероятности распределены симметрично: 1 и 2 успеха более вероятны, 0 и 3 — менее. Увеличиваем число испытаний до десяти: одиннадцать возможных исходов от 0 до 10, опять все симметрично, чаще всего мы будем видеть 5 успехов, а вероятность увидеть 0 или 10 очень мала. Если поднять до 100 испытаний, картина примерно та же: наиболее вероятные исходы сконцентрированы вокруг 50, увидеть меньше 40 или больше 60 успехов уже достаточно маловероятно. Во втором ряду — те же числа испытаний, но с вероятностью успеха 20%: распределения смещаются влево и становятся асимметричными.
Почему «биномиальное»?
Откуда название? Формула, рассчитывающая, сколькими способами можно выбрать \(k\) элементов из \(n\), исторически появилась в разложении, которое называется биномом Ньютона — вы его, может быть, проходили в школе. Это типичное выражение «число плюс число» в некоторой степени: мы обычно останавливаемся на второй или третьей степени, но у разложения есть общая формула, и выглядит она следующим образом. Само выражение \((x+y)^n\) называется биномом, а вот эти штуки \(\binom n k\) назвали биномиальными коэффициентами. А потом, когда люди начали работать с распределением числа успехов, они обнаружили в формуле те же самые коэффициенты — отсюда и название. Что делает биномиальное распределение особенным: у вас есть конкретная формула, по которой можно считать вероятности, и оно хорошо подходит под ситуации, соответствующие описанию «было \(n\) независимых испытаний с постоянной вероятностью успеха».
\[\begin{align*} (x + y)^n &= \binom n 0x^ny^0 + \binom n 1x^{n-1}y^1 + \dots \\ &\quad + \binom{n}{n-1}x^1y^{n-1} + \binom{n}{n}x^0y^{n} \\ (x + y)^n &= \sum_{k=0}^{n}\binom{n}{k}x^ky^{n-k} \\ \textrm{например, } (x+y)^3 &= \binom 3 0x^3y^0 + \binom 3 1x^2y^1 \\ &\quad + \binom 3 2x^1y^2 + \binom 3 3x^0y^3\\ (x+y)^3 &= x^3 + 3x^2y + 3xy^2 + y^3 \\ \textrm{частный случай, при }x=1&, y=1 : \\ 2^n &= \sum_{k=0}^{n}\binom{n}{k} \end{align*}\]
Ожидание (Expectation)
Теперь поговорим про характеристики распределения. Помните, когда мы работали с данными, мы считали для переменных всякие меры центральной тенденции и меры разброса: среднее, медиану, дисперсию, стандартное отклонение, интерквартильный размах. Почему бы что-то подобное не посчитать и для абстрактных случайных переменных? Они как будто существуют в параллельных вселенных, но между ними есть аналогия: с одной стороны у нас есть числа, с другой — некий абстрактный концепт, который может производить числа. В идеале мы бы хотели понять, какой из этих абстрактных концептов — какая случайная переменная — произвел наблюдения, которые мы реально видим. Поэтому давайте посчитаем похожие характеристики для случайных переменных.
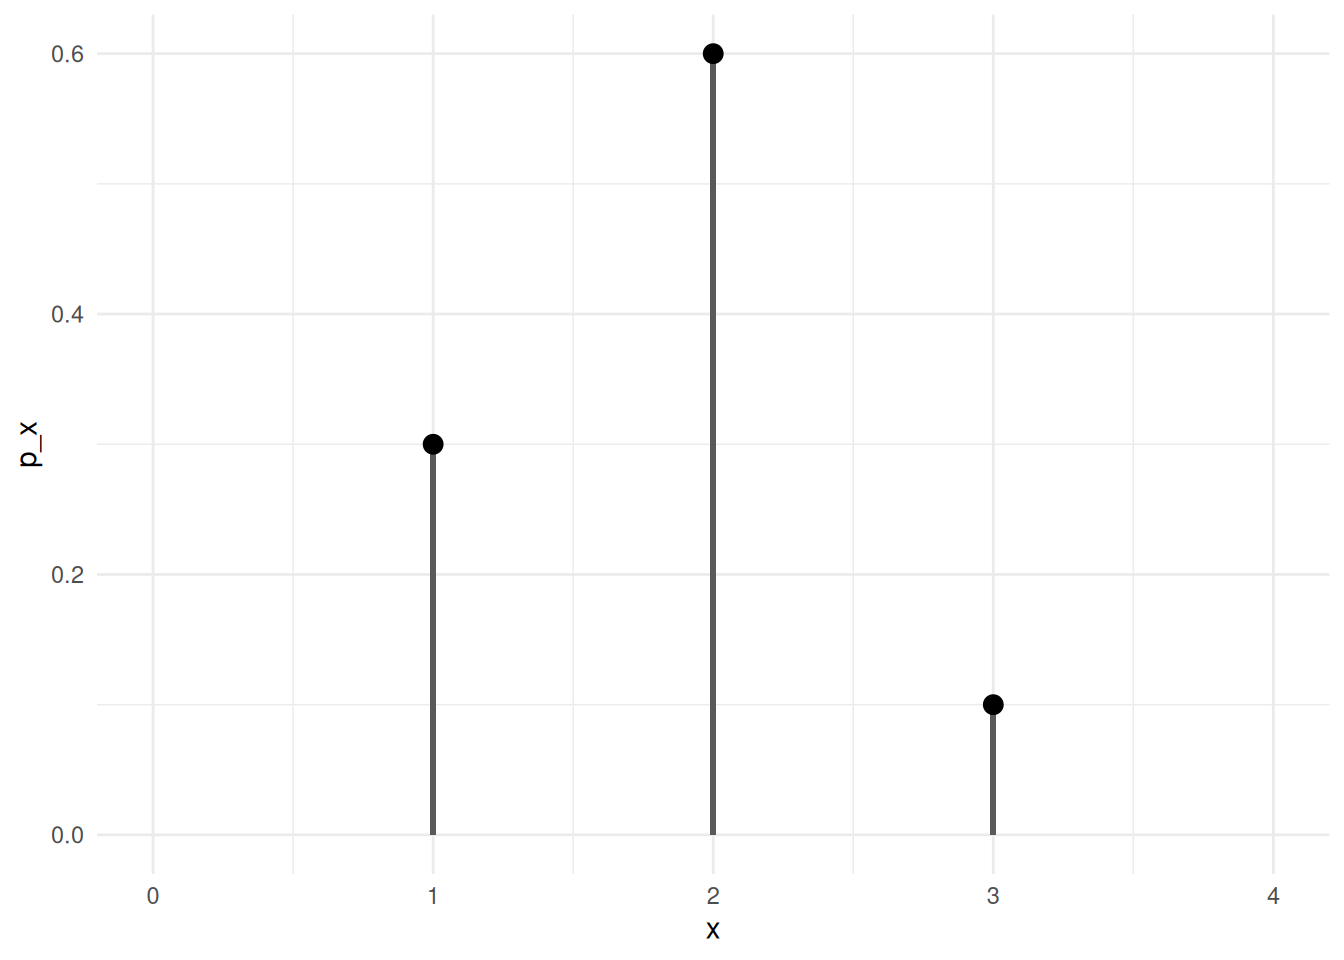
Первая из них называется ожиданием, иногда — математическим ожиданием, по-английски expectation. Простой пример: пусть \(X\) — переменная, которая моделирует, сколько чашек кофе я выпью за случайно взятый день. Я могу выпить одну, две или три чашки — с вероятностями 3/10, 6/10 и 1/10 соответственно.
Пример: пусть \(X\) обозначает число чашек кофе, которое я выпиваю в случайный день. Зададим распределение.
Количество чашек кофе (X) 1 2 3 Вероятность \(p_X(*)\) 3/10 6/10 1/10 Ну или в другой записи,
- \(p_X(1) = P(X = 1) = 3/10\)
- \(p_X(2) = P(X = 2) = 6/10\)
- \(p_X(3) = P(X = 3) = 1/10\)
Теперь вопрос: сколько примерно кружек кофе я выпью за 100 дней? Можно рассуждать так. Если вероятность того, что я пью одну кружку, равна 0,3, то за 100 дней будет примерно 30 дней, когда я выпил одну кружку. По той же логике будет примерно 60 дней, когда я выпил две кружки, и примерно 10 дней, когда я выпил три. Если каждое из этих количеств дней умножить на число выпитых кружек и все сложить, мы получим общее количество кружек за 100 дней. А если разделить его на 100 — число дней — получим среднее: 1,8.
Теперь немного алгебраически переставим слагаемые. В числителе у нас сумма, значит, можно разбить ее на слагаемые и каждое разделить на 100. Получится: единица, умноженная на 3/10, плюс двойка, умноженная на 6/10, плюс тройка, умноженная на 1/10. И тут видна определенная закономерность: первое число в каждом слагаемом — это возможное значение переменной (одна кружка, две, три), а второе — соответствующая ему вероятность. Мы взяли возможные значения переменной, помножили на соответствующие им вероятности, все сложили — и получили число, которое помогает понять, какое значение наша случайная переменная будет принимать «в среднем» при большом числе испытаний.
- Сколько чашек кофе я выпью в среднем за 100 дней?
\[ \textrm{Среднее число чашек } = \frac{1*30 + 2*60 + 3*10}{100} = 1.8 \\ \textrm{или} \\ \textrm{Среднее число чашек } = 1*\frac{3}{10} + 2*\frac{6}{10} + 3*\frac{1}{10} = 1.8 \]
- Определение:
Собственно, это и есть определение математического ожидания случайной переменной. Обозначается оно как \(E\) — потому что expectation — и переменная в квадратных скобках (в квадратных — потому что так сложилось). Формально это сумма по всем возможным значениям \(x\), а под знаком суммы — слагаемые «значение, умноженное на соответствующую ему вероятность». Знак \(\sum\) (сигма) читается просто как «сумма всего того, что стоит под знаком»: обозначение придумали, чтобы не писать длинные поезда из слагаемых \(x_1 + x_2 + \dots + x_n\).
\[ E[X] = \sum_{x}xp_X(x) \]
Это формальное определение. А концептуальное определение — среднее в большом числе испытаний. Можно воспринимать матожидание как центр вашего распределения: то, вокруг чего концентрируются наиболее часто встречающиеся значения.
- Интерпретация: Среднее значение переменной в большом числе испытаний
Ожидание как популяционное среднее
- Допустим у нас \(n\) студентов
- Рост \(i\)-го студента: \(h_i\)
- Событие: выбираем случайного студента, все исходы равновероятны
- Случайная Переменная \(H\): рост случайного студента
- для простоты условимся, что все \(h_i\) уникальны
\[\begin{align*} p_H(h_i) &= \frac{1}{n} \\ E[H] &= \sum_hh_ip_H(h_i) = \sum_hh_i\frac{1}{n} \\ &=\frac{\sum_{h}h_i}{n} \end{align*}\]
- Ожидание, \(E[H]\), случайно взятого студента равно среднему по популяции
- Именно поэтому важна случайная, равновероятная выборка!!
Свойства ожидания
У матожидания есть очень простые свойства; доказывать их я не буду, просто перечислю. Матожидание константы равно самой константе: если ваша переменная не случайна и всегда принимает одно и то же значение, ее матожидание тоже будет равно этому значению. Если у вас есть две случайные переменные и вы их складываете, то матожидание суммы можно найти как сумму отдельных матожиданий.
- Если \(c\) константа, \(E[c] = c\)
- \(E[X + Y] = E[X] + E[Y]\)
- если \(Y = g(X)\), то \(E[Y] = E[g(X)]\)
Давайте сразу пример. Помните, мы строили PMF для переменной \(Z = X + Y\), где \(X\) — первый бросок кубика, а \(Y\) — второй? Попробуем интуитивно понять, чему равно матожидание одного броска кубика. Три с половиной. Как это увидеть формально? Первое возможное значение — единица, ее вероятность — одна шестая. Второе значение — двойка, вероятность — тоже одна шестая. И так далее до шести. Одна шестая — общий множитель, выносим его и складываем целые числа от одного до шести: получается 21, а 21 на 6 — три с половиной. Чисто интуитивно: кубик у нас равномерно распределен, соответственно, центр этого распределения должен быть ровно посередине между единицей и шестеркой — просто 7 делим пополам.
А теперь, зная свойство матожидания суммы, посчитайте матожидание суммы двух кубиков. Семь. Помните, мы говорили, что 7 — это то число, на которое надо ставить? Если вы будете бросать два кубика, складывать числа и повторять это много-много раз, самым частым числом будет семерка — и оно же среднее.
Еще один пример — ожидание биномиальной переменной:
\[\begin{align*} X \sim Bi(n, p) \\ \textrm{(X — биномиальная С.П. с параметрами n и p)} \\ \textrm{способ «в лоб»: } E[X] = \sum_{k=0}^{n}k\binom{n}{k}p^n(1-p)^{n-k} \\ \textrm{умный способ}: X = Y_1 + Y_2 + \dots + Y_n, \textrm{где } Y_i \sim Be(p) \\ E[X] = E[Y_1 + \dots +Y_n]=E[Y_1] + \dots + E[Y_n] \\ = p + \dots + p = np \\ E[X] = np \end{align*}\]
Пример с кошкой
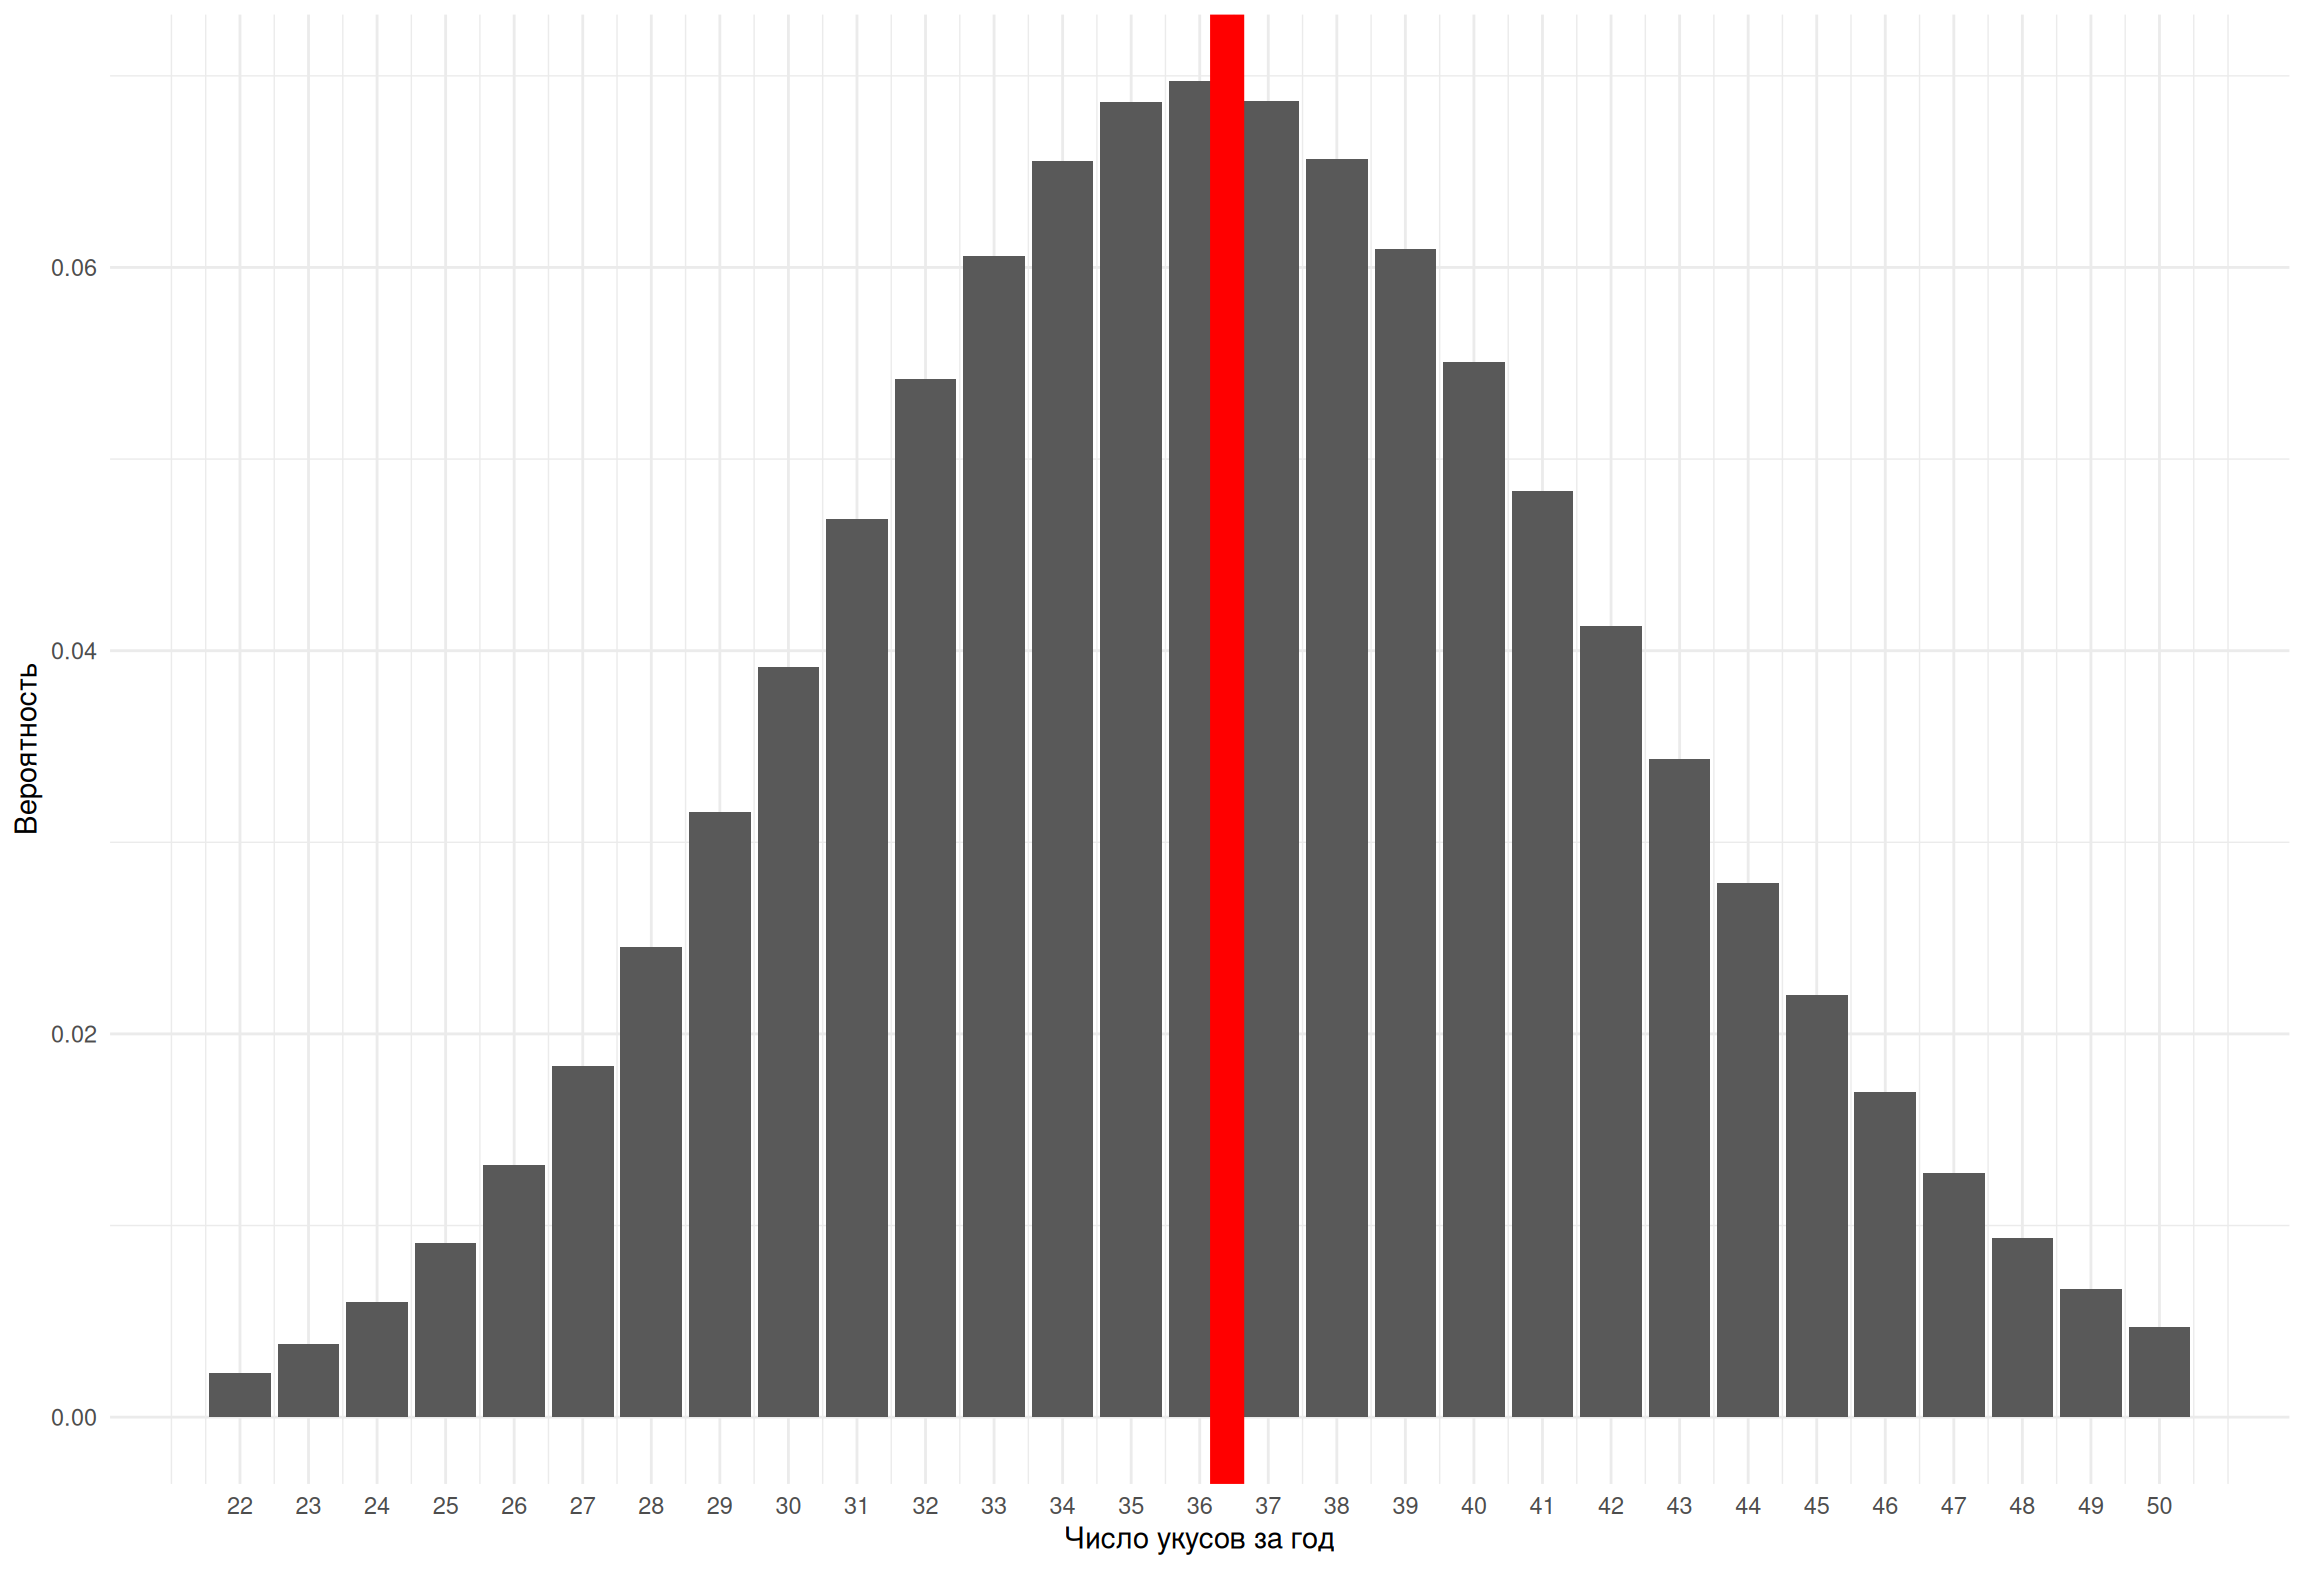
- Есть кошка, которая кусает хозяина по утрам. Шанс 10% для каждого утра.
- Как много раз кошка укусит за год?
- \(E[X] = 364(n)*0.1(p) = 36.4\)
Дисперсия случайной переменной
Ожидание дает нам представление о центре распределения. А что может дать информацию о «разбросе»? Посмотрите на пример с кошкой: иногда она может укусить 29 раз за год, а иногда и 44. Насколько далеко мы, в принципе, можем уйти от среднего — при том, что событие сохраняет какую-то заметную вероятность? Каковы типичные отклонения от центра распределения?
Идея такая: у нас есть случайная переменная \(X\), для которой мы уже посчитали матожидание \(E[X] = \mu\) — центр распределения. Давайте посмотрим, насколько конкретные значения этой переменной уходят от матожидания, то есть на отклонения \(X - \mu\). А чтобы избавиться от отрицательных чисел, все возведем в квадрат.
По сути, мы взяли случайную переменную \(X\) и произвели над ней функциональную трансформацию. Но функция случайной переменной — тоже случайная переменная, поэтому для нее можно посчитать все, что считается для случайных переменных, в том числе матожидание. Матожидание вот этой хитрым образом сконструированной переменной — квадрата отклонения переменной от своего же центра — мы назовем дисперсией (variance). Она будет характеризовать разброс значений нашей случайной переменной.
- Дисперсия (Variance) \(X\), определение
\[ var(X) = E[(X - \mu)^2] \geq 0 \\ \]
У дисперсии есть свойства, которые позволяют вывести более простую формулу для расчета: матожидание квадрата случайной переменной минус квадрат ее матожидания.
- Свойства
\[\begin{align*} var(X) &= E[X^2 - 2X\mu + \mu^2] = E[X^2] - E[2X\mu] + E[\mu^2] \\ &= E[X^2] - 2\mu E[X] + \mu^2 = E[X^2] - 2\mu^2 + \mu^2 \\ &= E[X^2] - \mu^2 \textrm{ (или) } \\ &= E[X^2] - (E[X])^2 \end{align*}\]
Если извлечь из дисперсии квадратный корень, мы получим стандартное отклонение:
\[ \sigma_X = \sqrt{var(X)} \]
Дисперсия Бернулли
Пример дисперсии для распределения Бернулли примечателен, давайте немного на нем остановимся. Дисперсию можно было бы посчитать и напрямую, но тут хорошо работает формула выше — и заодно она показывает одно забавное свойство Бернулли. Что мы помним про Бернулли? Переменная принимает значения 0 и 1: единицу с вероятностью \(p\), ноль с вероятностью \(1-p\). Если мы возведем эту переменную в квадрат, ее значения… не изменятся: 0 и 1 в квадрате остаются 0 и 1, и принимаются они с теми же вероятностями. Поэтому можно сказать, что \(X^2\) — это то же самое, что \(X\). Подставляем в формулу: матожидание \(X\) минус квадрат этого матожидания. Само матожидание Бернулли легко посчитать — оно равно \(p\). Получаем \(p - p^2 = p(1-p)\).
- Бернулли: \(X \sim Be(p)\)
- заметим, что \(X^2 = X\): обе переменные принимают одни и те же значения \(0, 1\) с одними и теми же вероятностями
\[ var(X) = E[X^2] - (E[X])^2 = E[X] - (E[X])^2 = p - p^2 = p(1-p) \]
Теперь поупражняемся концептуально. Дисперсия — это мера разброса значений, другими словами — мера неопределенности: насколько далеко можно уйти от центра. Посмотрите на выражение \(p(1-p)\), где \(p\) — вероятность успеха. Когда оно принимает минимальное значение? Когда \(p = 1\): если вероятность успеха 100%, у нас нет никакой неопределенности, мы абсолютно уверены, что событие произойдет, — дисперсия равна нулю. Если вероятность успеха равна нулю — опять никакой неопределенности: мы абсолютно уверены, что событие не произойдет, никакой вариативности. А когда дисперсия максимальна? Когда неопределенность максимальна: событие может произойти, а может и не произойти — 50 на 50. Если подставить \(p = 0.5\), так и получится: дисперсия максимальна, когда оба исхода равновероятны.
Если хотите увидеть это аналитически: \(p(1-p) = p - p^2\) — квадратичная функция с отрицательным старшим коэффициентом, то есть парабола ветвями вниз, с нулями в 0 и 1. Она симметрична, соответственно, максимальное значение будет ровно посередине — там, где вероятность равна 50%.
Дисперсия равномерной переменной
И, просто для общего ознакомления, дисперсия равномерной переменной. Вывод я привожу не полностью — как видите, в какой-то момент просто происходит немного черной алгебры, и все сокращается.
- Равномерная С.П.: \(Y \sim U[0, n]\), (частный случай)
- \(E[Y] = \frac{n}{2}, p_Y(y) = \frac{1}{n+1}\)
\[\begin{align*} var(Y) &= E[Y^2] - (E[Y])^2 \\ &= \frac{1}{n+1}(0^2+1^2+\dots+n^2) - \frac{n^2}{4} = \\ &= \textrm{ ...происходит немного черной алгебры, и.. } \\ &= \frac{1}{12}n(n+2) \end{align*}\]
- Равномерная С.П.: \(Z \sim U[a, b]\), (общий случай)
- Заметим, что \(Z = Y + a, n = b - a\)
- \(Var(Y + a) = Var(Y)\)
\[var(Z) = \frac{1}{12}(b-a)(b-a+2)\]