| mpg | cyl | disp | hp | drat | wt | qsec | vs | am | gear | carb | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| Mazda RX4 | 21.0 | 6 | 160.0 | 110 | 3.90 | 2.620 | 16.46 | 0 | 1 | 4 | 4 |
| Mazda RX4 Wag | 21.0 | 6 | 160.0 | 110 | 3.90 | 2.875 | 17.02 | 0 | 1 | 4 | 4 |
| Datsun 710 | 22.8 | 4 | 108.0 | 93 | 3.85 | 2.320 | 18.61 | 1 | 1 | 4 | 1 |
| Hornet 4 Drive | 21.4 | 6 | 258.0 | 110 | 3.08 | 3.215 | 19.44 | 1 | 0 | 3 | 1 |
| Hornet Sportabout | 18.7 | 8 | 360.0 | 175 | 3.15 | 3.440 | 17.02 | 0 | 0 | 3 | 2 |
| Valiant | 18.1 | 6 | 225.0 | 105 | 2.76 | 3.460 | 20.22 | 1 | 0 | 3 | 1 |
| Duster 360 | 14.3 | 8 | 360.0 | 245 | 3.21 | 3.570 | 15.84 | 0 | 0 | 3 | 4 |
| Merc 240D | 24.4 | 4 | 146.7 | 62 | 3.69 | 3.190 | 20.00 | 1 | 0 | 4 | 2 |
| Merc 230 | 22.8 | 4 | 140.8 | 95 | 3.92 | 3.150 | 22.90 | 1 | 0 | 4 | 2 |
| Merc 280 | 19.2 | 6 | 167.6 | 123 | 3.92 | 3.440 | 18.30 | 1 | 0 | 4 | 4 |
1 Данные.
Данные
Статистика анализирует данные. Но что такое данные? Это одно из тех расхожих понятий, которые принимают множество значений в зависимости от контекста. В статистике, можно начать с буквального значения слова data (т.е. данные) — множество точек (от латинского datum - точка). Под “точками” понимаются интересующие нас однородные объекты; в зависимости от ситуации, это могли бы быть люди, аудиозаписи, или образцы крови. Данные - это общее понятие, под их формальное определение подпадает любое множество объектов одной природы.
В практическом смысле, данные - это все что может быть представлено в виде таблицы с определенной структурой. Подобные таблицы называют матрицей или таблицей данных; подавляющее большинство статистических методов предполагают работу именно с таким форматом.
Таблица выше содержит данные о моделях машин, выпущенных в 70-х. Обратите внимание, что каждая строка в ней соответствует наблюдению (т.е. машине), а каждый столбец - переменной (т.е. характеристике машины). Мы еще не дали определения этим понятиям, но за названиями можно услышать вложенное значение.
Заметка
наблюдения - в таблице данных им соответствуют строки
Наблюдение (observation) — это единица анализа, одна точка в множестве данных. Типичным наблюдением в социальных исследованиях мог бы быть человек, покупка в магазине, да и в принципе все что угодно, что в совокупности представляет интерес.
Заметка
переменные - характеристики, которые меняются от наблюдения к наблюдению
Переменная — это характеристика, которая может меняться от наблюдения к наблюдению. Например,
- специальность студента
- оценка за тест
- время покупки
Поговорим немного о переменных. Они бывают двух общих типов: те, что численно измеряемы (например, рост) и те, что выражены категориями (например, цвет глаз). Будет удобно разграничивать эти два типа, назовем их числовые и категориальные переменные.
Числовые переменные
Заметка
числовые переменные отличает то, что над ними можно совершать арифметические операции (складывать, умножать, делить и т.п.)
Если немного задуматься над числами, можно заметить, что они тоже бывают разной природы. Некоторые числа как будто полностью, непрерывно заполняют собой произвольный интервал. Например, между нулем и единицей существует бесконечно много прочих чисел, таких как \(0.5\) или \(1/\sqrt{2}\). Переменные которые могут принимать любые значения на заданном интервале, принято называть непрерывными (continuous). Можно сказать, что непрерывные переменные имеют бесконечную точность, в том смысле, что в теории мы всегда могли бы подобрать более точную оценку. Скажем, обычно мы округляем рост до целого числа сантиметров, но в принципе могли бы измерить его с точностью и до миллиметров, и до микрометров, и до нанометров - при условии что у нас есть подходящий измерительный прибор.
Заметка
Непрерывные (continuous) переменные могут принимать любые значения в рамках заданного интервала. Примеры: рост, вес, артериальное давление.
Одна из задач учебника научить вас читать язык математики, поскольку это экономичный способ записи идей. За многими часто используемыми математическими концептами закрепились специальные символы. Например, символом \(R\) принято обозначать множество вещественных или действительных чисел. “Вещественные” означает всего лишь “обычные” (а не какие-то трансцендентные и потусторонние) числа, с которыми мы сталкиваемся в нашей повседневности. Даже сам символ \(R\) - взялся как заглавная буква прилагательного Real, которым в англоязычной математической традиции как раз и маркируют “обычные” числа (Real numbers).
Мы часто будем записывать \(X \in R\) что можно перевести как “переменная \(X\) может принимать любые значения”.
С другой стороны, некоторые переменные могут принимать строго определенные значения. Например, число сиблингов у человека может быть только положительным целым числом, а размер обуви обычно измеряют с фиксированным приростом \(0.5\) — т.е. размер ноги может быть \(37.5\), но не \(37.78\). Подобные переменные принято называть дискретными1.
Категориальные переменные
Категориальные переменные принимают значения из ограниченного множества категорий, или уровней. Цвет глаз человека, степень прожарки стейка, группа крови - примеры категориальных переменных. В этом небольшом списке, однако, уже можно заметить подтипы. Цвета глаз - карий, голубой, зеленый - нельзя упорядочить каким-то одним способом. Цвета как бы равны между собой; мы могли бы поставить карий перед голубым, но это принципиально не отличалось бы от любого другого порядка. А вот степени прожарки стейка упорядочить можно: rare предшествует medium который предшествует well-done.
Категориальные переменные принято делить на номинальные (т.е. просто имена без внутренней иерархии) и порядковые (категории у которых есть внутренняя иерархия). Это разграничение важно, потому что порядок категорий позволяет извлекать больше информации из данных.
Схема ниже представляет общую классификацию переменных. Этот способ не единственно возможный, но это тот который часто встречается на практике и в вводных курсах статистики. Более нюансированное понимание переменных требует математического формализма и мы оставим его на более поздние части курса.

Не все числа - это числа
Будьте бдительны, переменная может быть выражена числом, но это не обязательно делает ее числовой. Например, оценка за тест IELTS - это число в интервале от 1 до 9, однако реальной числовой переменной она не является. Это категориальная (порядковая) переменная “притворившаяся” числовой.
Существует быстрый тест на “число”. Попробуйте сложить или вычесть испытываемую переменную. Если результат будет иметь смысл - перед вами скорее всего настоящая числовая. Если нет - категориальная самозванка. Например, если кто-то сдал IELTS на \(1\), а кто-то другой на \(9\), будут ли они совместно знать английский на \(10\)? Очевидно нет! Соответственно IELTS не является числом.
Упражнения
Соотнесите описание переменной и ее тип
Число браков в Астане за январь.
Ответ
Числовая дискретная
Рост случайно выбранного Казахстанца.
Ответ
Числовая непрерывная
Группа крови случайного выбранного Казахстанца.
Ответ
Категориальная номинальная
Оценка за школьный диктант по шкале от 1 до 5.
Ответ
Категориальная порядковая
Задача
Исследователи провели эксперимент на 160 детях в возрасте от 5 до 15 лет; контролировался также возраст и пол детей. Каждый ребенок бросал монетку и записывал результат (белый или черный). Тем у кого выпадал “белый” давали небольшой подарок. Половине учеников дали прямые указания “быть честными”, другой половине ничего не говорили. В контрольной группе мальчики и девочки врали с одинаковой частотой. В экспериментальной группе девочки врали реже, и если у мальчиков частота вранья не зависела от возраста, то у девочек она с возрастом уменьшалась. (OpenIntro Statistics 2018:19)
- Сформулируйте главный исследовательский вопрос.
- Что является наблюдением? Как много наблюдений зафиксировано?
- Перечислите переменные и их типы.
Ответы:
- Например, как прямые инструкции не врать, влияют на вероятность вранья среди детей от 5 до 15 лет
- Ребенок от 5 до 15 лет; 160 наблюдений
- Пол: номинальная (мальчик, девочка); Возраст: числовая дискретная; Получил ли инструкцию не врать: номинальная (да или нет); Врал или не врал: номинальная; Единственный ребенок в семье: номинальная
Индикаторы
Некоторые категориальные переменные принимают только два значения, причем одно из них указывает на некое состояние или выполнение некоего условия. В задаче выше таковой, например, была переменная “единственный ребенок”. Подобные переменные называют индикаторами, поскольку они индицируют некое условие: посещал ли студент занятие (да или нет), есть ли у вас собака (есть или нет). Для удобства мы будем обозначать индикаторы следующим образом: I(условие), где переменная принимает значение \(1\) если условие выполняется и \(0\) если нет. Например, когда мы пишем I(курильщик): \(1\) будет кодировать курильщика, а 0 - некурящего.
Статистическая связь
Одна из целей статистики — находить связи между переменными. Статистическую связь можно определять множеством способов, мы пока остановимся на общем определении, которое уточним позже.
Две переменные будут называться статистически связанными или статистически ассоциированными, если зная значение одной, вы можете приблизительно предположить значение другой. Звучит туманно. Не совсем понятно, что значит “приблизительно предположить”. Давайте разберем это на примере.
Каков рост случайно взятого человека? То есть в каких пределах мы могли бы его ожидать? Рост человека варьируется и если, мы не вводим дополнительных условий, варьируется он в довольно широких пределах.
Теперь представьте, что вам уточняют — это не просто случайный человек, а игрок НБА (т.е. баскетболист). Мы все еще не знаем его точного роста, но дополнительная информация уменьшила неопределенность. Баскетболисты обычно довольно высокие люди. Формально, значение одной переменной (человек является баскетболистом) помогло нам точнее определить возможное значение другой переменной (роста). Другими словами, значение одной переменной уменьшило неопределенность связанную с другой переменной. Запомните эту идею с уменьшением неопределенности, мы еще вернемся к ней в последующих главах.
Какие еще термины могут нам понадобится? С практической точки зрения переменные не всегда равноправны. Часто нас интересует одна переменная, например успеваемость студента, и для объяснения ее вариации мы используем какую-то другую переменную (занимается ли студент спортом).
Для переменных которые мы хотим объяснить в литературе закрепилось обозначение - зависимая переменная (dependent variable) или переменная-отклик (немного неуклюжий перевод response variable). По аналогии, те переменные которые мы используем для объяснения принято называть независимыми переменными (independent variables) или объясняющими переменными (explanatory variables). В ходу оба варианта, можно использовать или первую, или вторую пару, при условии, что вы последовательны.
Стоит также заметить, что объясняющих переменных может быть больше одной. Например, рост человека зависит от множества факторов, увлечение баскетболом - лишь один из них. Чтобы кратко выражать мысль, что одна переменная может зависеть от набора других переменных мы будем использовать следующую запись:
- Зависимая переменная ~ Переменная 1 + Переменная 2 + …
Например,
Рост ~ I(Игрок НБА) + Вес
Следует читать как “Рост человека зависит (объясняется) от того играет ли он в НБА и сколько он весит”
Вас, возможно, покоробило то, что рост как будто бы зависит от игры в НБА. Можно ли вообще считать, что рост зависит от профессии; скорее наоборот, высокий рост приводит к возможной карьере в баскетболе?
Здесь важно осознавать, что статистические модели не всегда соотносятся с реальностью (агностичны). Статистические программы посчитают любую модель, но качество модели определяется пониманием процесса, который произвел данные, то есть самим исследователем и его знанием предмета.
Это к тому, что расхожие фразы в духе “данные говорят сами за себя” — признак дилетанта. Данные, если пытать их достаточно долго, признаются во всем, что вам нужно.
Пример: Gapminder
Давайте потренируемся оценивать связь между переменными на примере. Мы будем работать с данными по странам мира, в котором собраны различные экономические и социальные характеристики стран мира2. Выглядит он приблизительно так
| country | continent | year | lifeExp | pop | gdpPercap |
|---|---|---|---|---|---|
| Afghanistan | Asia | 1952 | 28.801 | 8425333 | 779.4453 |
| Afghanistan | Asia | 1957 | 30.332 | 9240934 | 820.8530 |
| Afghanistan | Asia | 1962 | 31.997 | 10267083 | 853.1007 |
| Afghanistan | Asia | 1967 | 34.020 | 11537966 | 836.1971 |
| Afghanistan | Asia | 1972 | 36.088 | 13079460 | 739.9811 |
Всего у нас 1704 наблюдения по 6 переменным:
- country: номинальная, 142 уровня (страны)
- continent: номинальная, 5 уровней (континенты)
- year: числовая дискретная, от 1952 до 2007 с 4-х летним шагом
- lifeExp: числовая непрерывная, средняя продолжительность жизни в годах
- pop: числовая дискретная, население
- gdpPercap: непрерывная, ВВП на душу населения
Давайте выберем две числовые переменные и построим их совместное распределение как обычный XY-график, вроде тех, что мы чертили в средней школе. Такие графики называют диаграммами рассеяния (scatterplot). На графике ниже представлены средняя продолжительность жизни и ВВП на душу для стран мира в 2007 году.
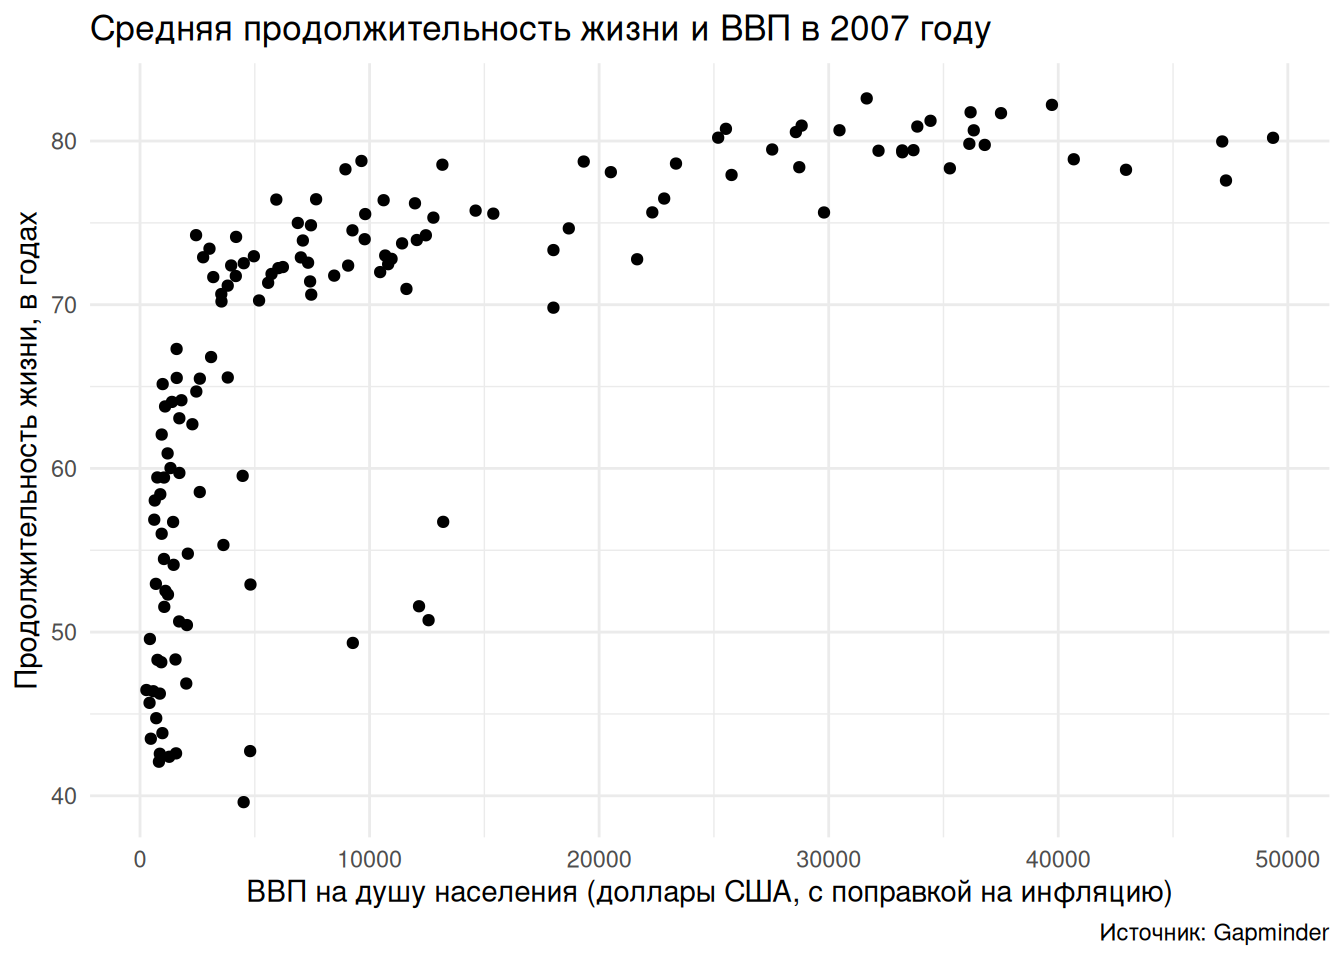
Что мы можем сказать о связи между этими переменными? Чисто технически, мы могли бы назвать этот график так
Продолжительность жизни(зависимая) ~ВВП на душу населения(независимая)
Далее мы могли бы сказать, что связь положительна, чем выше ВВП тем выше продолжительность жизни. Затем, могли бы уточнить, что связь нелинейна: для бедных стран относительно небольшой прирост ВВП связан с резким повышением продолжительности жизни, но после определенного уровня продолжительность жизни перестает расти (у возраста есть верхняя граница). И самое последнее, в выборке присутствуют выбросы (outliers) - наблюдения, которые как-будто бы не вписываются в общую массу.
прилагательное discrete с английского можно перевести как обособленный. Дискретные переменные иногда, путая, отождествляют с целыми числами. Пример с размером обуви показывает, что дискретность - это более общая характеристика.↩︎
Это достаточно известный датасет Gapminder, собраный шведским статистиком Хансом Росслингом. Gapminder, по всей видимости, это слово-портмане, составленное слиянием двух корней gap - разрыв и reminder - напоминатель. Таким образом Росслинг привлекает внимание к глобальному экономическому неравенству.↩︎