10 Доверительный интервал и проверка гипотез
Центральная предельная теорема
Для начала нам придется познакомиться с центральной предельной теоремой (ЦПТ) — основанием практически всего практического в статистике; именно благодаря ей статистика используется в таком количестве приложений.
Представим, что у нас есть какая-то случайная переменная \(X\). Мы будем к ней предельно щедры: она может иметь какое угодно уродливое распределение — двугорбое, трехгорбое, странной формы, как хребет Алатау. Мы просим всего две вещи: чтобы у распределения был определенный центр (матожидание) и конечная дисперсия — то есть чтобы оно не было размазано по числовой прямой каким-то совсем уж патологическим образом. Это реально очень скромные требования.
Теперь представьте, что вы начинаете за этой переменной наблюдать: первое наблюдение, второе, третье — в итоге \(n\) независимых наблюдений (то, что произошло раньше, никак не влияет на то, что вы увидите позже). Вы берете эту выборку и считаете на ней среднее арифметическое — то есть, технически, вводите новую случайную переменную.
Пусть \(X\) - это случайная переменная с ожиданием \(\mu\) и стандартным отклонением \(\sigma\), и у нас есть \(n\) независимых наблюдений этой переменной. Введем новую случайную переменную \(\overline{X} := \frac{1}{n}\sum_{i=1}^{n}X_i\). Центральная предельная теорема утверждает, что эта новая переменная будет иметь нормальное распределение со следующими параметрами:
\[\bar{X} \sim N(\textrm{ mean } = \mu, \textrm{ sd } = \frac{\sigma}{\sqrt{n}})\]
Попробуйте оценить масштабы этого заявления. Мы можем не знать распределение \(X\) — оно может быть каким угодно. Но распределение средних (его называют распределением выборочных средних, потому что среднее считается на выборке) будет известным. И не просто известным — нормальным. И не просто нормальным — с заранее известными параметрами: его центр находится там же, где центр изначального распределения, а стандартное отклонение меньше изначального в \(\sqrt{n}\) раз.
В чем практическая польза уменьшающегося стандартного отклонения? Нам ведь, как правило, и нужно оценить центр распределения, которого мы не видим: средний возраст курильщика, средний возраст первого инфаркта, средний доход. ЦПТ говорит: берите случайные выборки и считайте среднее — с ростом выборки вы будете все ближе и ближе к истинному центру.
- Причем нормально распределены не только выборочные средние. Многие выборочные статистики распределены нормально:
- выборочные средние, \(\bar{X}\)
- выборочные пропорции, \(\hat{P}\)
- разница выборочных средних, \(\bar{X_1} - \bar{X_2}\)
- разница выборочных пропорций, \(\hat{P_1} - \hat{P_2}\)
Напомню: статистика — это любое число, которое вы можете рассчитать на основе выборки. Сложили все значения — статистика; посчитали пропорцию — статистика. Так вот, для очень широкого класса статистик доказано, что они распределены нормально — при условии, что выборка случайна и наблюдения независимы.
ЗаметкаРаспределение на выборке и выборочное распределение
Язык здесь, к сожалению, использует похожие слова для объектов разной природы (в английском та же беда: sample distribution против sampling distribution). Разложим по полочкам.
Допустим, вы взяли выборку из 100 студентов и посчитали их GPA. Распределение на выборке (sample distribution) — это распределение значений, которое вы видите в этой конкретной выборке; оно, с оговорками, похоже на распределение в популяции — и может быть каким угодно двугорбым и некрасивым.
А теперь мысленный эксперимент: вы берете первую выборку и считаете ее среднее \(\bar{x}_1\), потом вторую — \(\bar{x}_2\), и так много-много раз. Сложите все эти средние в один ящик — получится выборка из средних, и у нее есть свое распределение. Вот оно и называется выборочным распределением (sampling distribution). ЦПТ — это утверждение именно о нем: каким бы уродливым ни было распределение на выборке, выборочное распределение будет нормальным и красивым, с центром там же, где центр популяции.
Отсюда же еще один термин. Стандартное отклонение выборочного распределения называется стандартной ошибкой (standard error, SE). То есть стандартная ошибка — это все еще стандартное отклонение, просто выборочное распределение настолько важно, что его стандартному отклонению дали отдельное имя.
Точечная и интервальная оценка
Теперь переведем все это в практическое русло. Предположим, вы решили оценить средний вес мужчины в Астане: взяли 100 случайных мужчин, взвесили, и среднее оказалось 75 килограмм.
- Точечная оценка - это просто одно число
- 75 килограмм - это точечная оценка среднего веса всех мужчин Астаны.
- Интервальная оценка - это, как несложно догадаться, интервал значений
- Например, вместо 75 килограмм мы могли бы взять 75 ± 5 килограмм: [70, 80]
Почему мы называем 75 оценкой? Потому что мы хотели бы знать средний вес всех мужчин Астаны, но у нас есть доступ только к выборке. Наши выборочные 75 кг не будут точно равны истинному значению — но, если мы ничего не испортили в выборке, должны быть где-то в его районе. Как повысить вероятность того, что мы «накрыли» истинное значение? Добавить к точечной оценке погрешность — плюс-минус. Вопрос только в том, как выбрать размер погрешности не с потолка, а так, чтобы у него были теоретические гарантии: например, чтобы интервал содержал истинное среднее с заданной вероятностью.
И вот тут вас должно озарить: если мы знаем форму распределения нашей оценки, мы знаем, как далеко она может уходить от истинного центра — а значит, можем посчитать нужную длину интервала. В этом и есть вся сила ЦПТ: она гарантирует, что форма известна — нормальная.
Расстояние от среднего
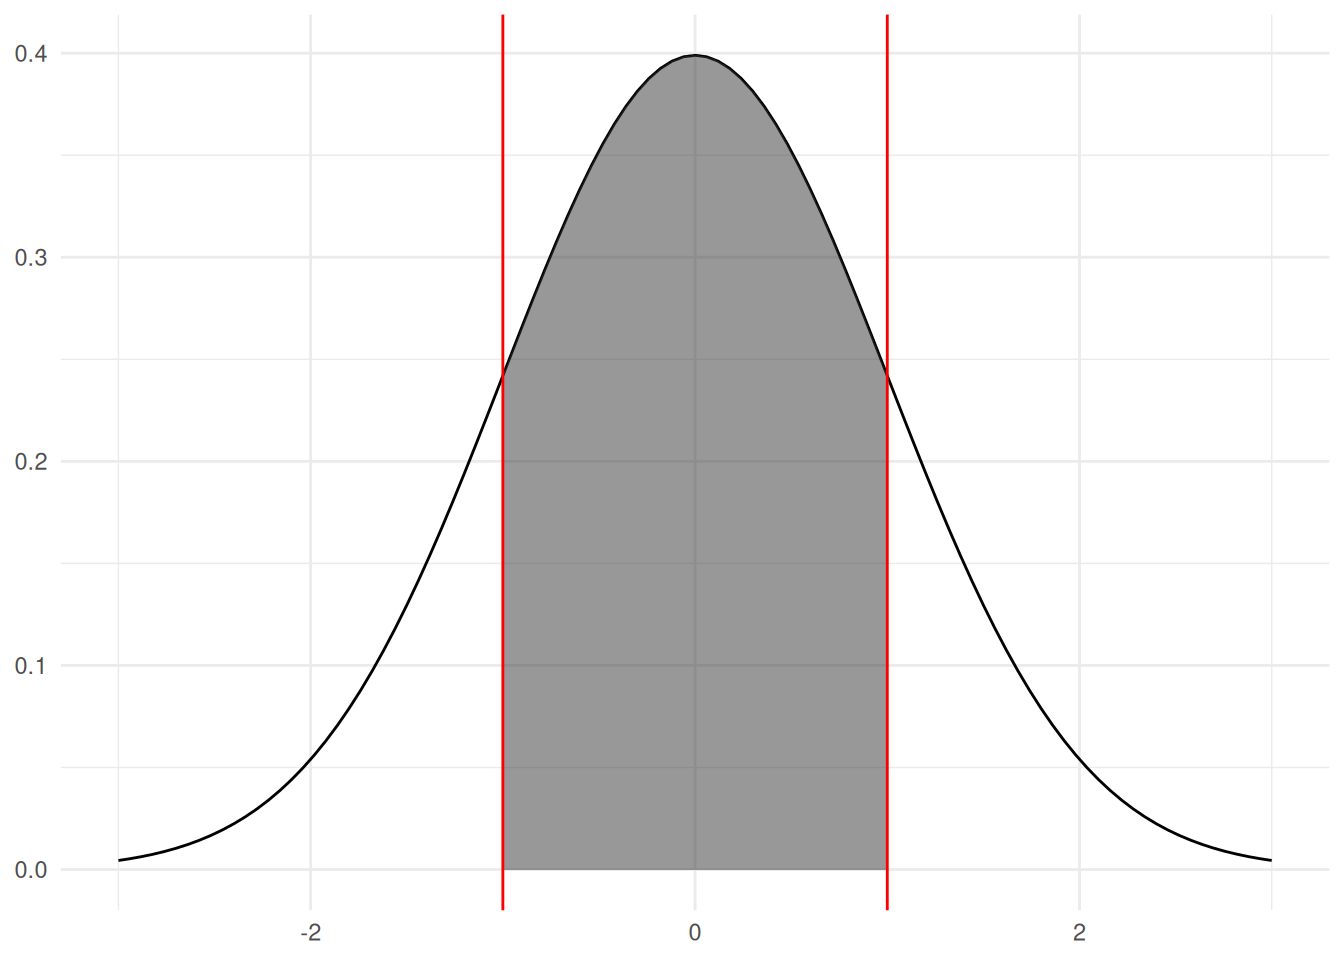
Как это работает? У нас есть стандартная нормальная переменная (так исторически сложилось, что за ней закреплена буква \(Z\)): \(Z\sim N(0, 1)\). Как много наблюдений лежит в пределах 1-го стандартного отклонения от среднего?
\[ P(-1<Z<1) \approx 68.3\% \]
Теперь посмотрите на это с другой стороны. Наше выборочное среднее распределено нормально, с центром в истинном среднем. Конкретная оценка может выпасть левее центра, правее, совсем рядом. К каждой оценке мы пристраиваем интервал — плюс-минус погрешность. Если погрешность равна одному стандартному отклонению, интервал накроет истинный центр ровно в тех случаях, когда сама оценка упала в пределах одного стандартного отклонения от центра, — то есть с вероятностью 68.3%. Хотим большую вероятность — берем погрешность пошире:
\[ P(-2 < Z < 2) \approx 95.4\% \]
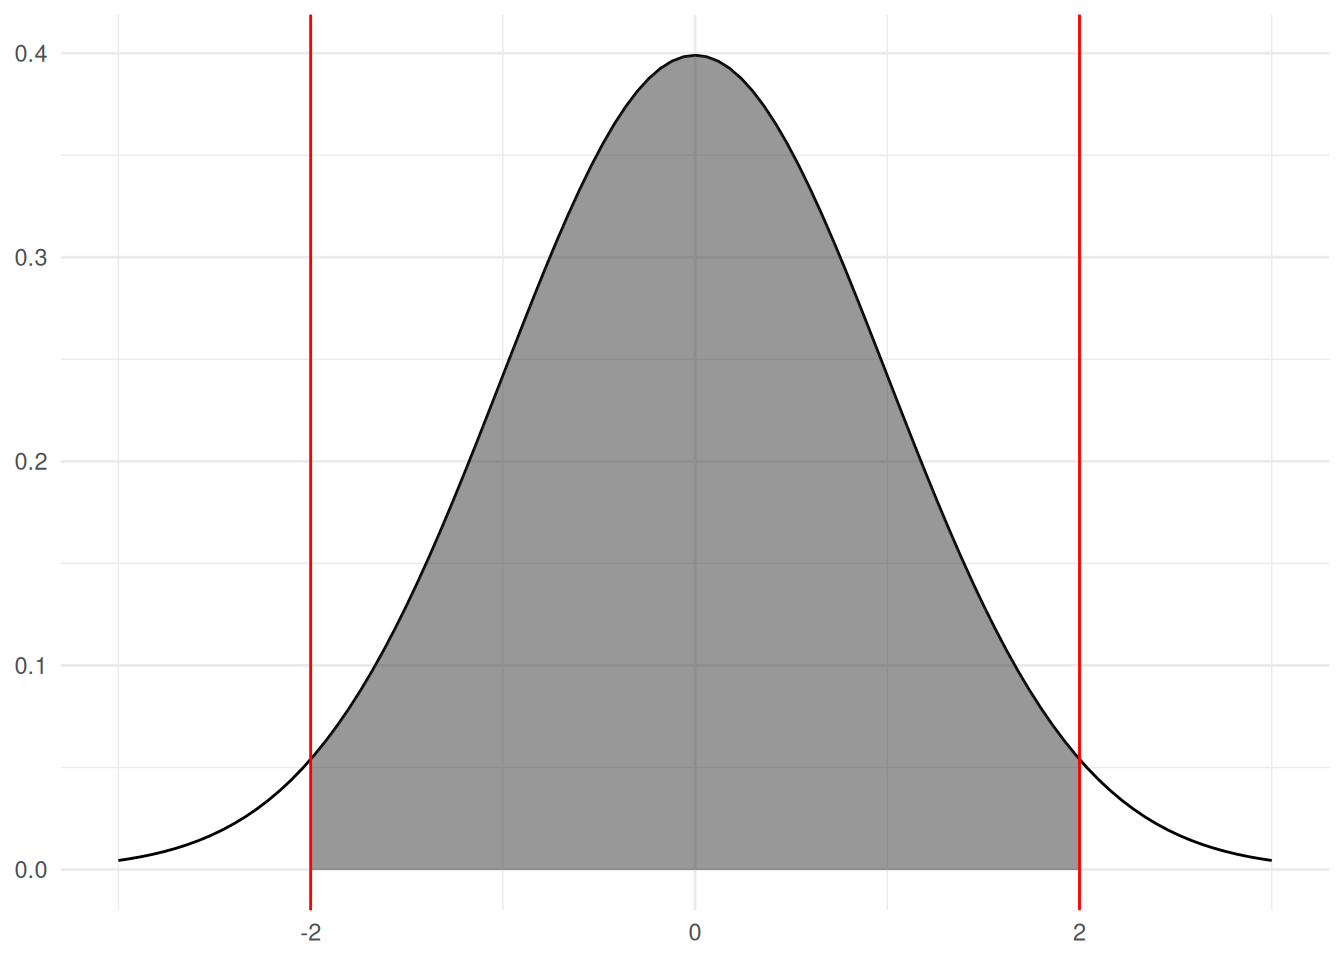
Расстояние от центра, измеренное в стандартных отклонениях, однозначно задает вероятность — и наоборот. Например: на сколько стандартных отклонений нужно отойти от центра, чтобы накрыть ровно \(95\%\) распределения?
\[\begin{align*} P(-z < Z < z) = 95\% \\ 1 - P(Z > z \cup Z < -z ) = 95\% \\ 1 - P(Z > z) - P(Z < - z) = 95\% \\ 2*P(Z < - z) = 5\% \\ P(Z < - z) = 2.5\% \\ \end{align*}\]
Обратите внимание: мы отрезаем 2.5%, а не 5%, потому что хвостов два — если отрезать 2.5% слева и 2.5% справа, вместе получится ровно 5%. Само значение считается кодом:
qnorm(0.025, mean = 0, sd = 1) %>% abs()[1] 1.959964Пример: резюме и дискриминация
Исследователь разослал \(200\) вымышленных резюме по вакансиям.
Резюме идентичны, однако половина “мужские”, половина - “женские”
Мужчинам позвонили 23 раза; женщинам 8
Для справки: такой тип исследований называется аудит-исследованиями (audit studies), и они достаточно распространены в социологии и экономике. Вы варьируете в документах только одну характеристику — здесь пол заявителя — и смотрите, как на нее реагируют работодатели.
Значат ли наши данные, что вероятность “звонка” для мужчин больше чем для женщин?
Что значит “вероятность” звонка? Одна интерпретация - популяционная пропорция: если бы у нас были данные обо всех трудоспособных мужчинах и женщинах
У нас две выборочные пропорции: 23% и 8%. Их разница — 15% — тоже случайная переменная: повтори мы эксперимент, она приняла бы какое-то другое значение (14%, 16%, 10%…). Благодаря ЦПТ мы знаем, что эта разница распределена нормально.
Примем пока на веру, что стандартная ошибка равна \(3.5\%\) (в конце главы покажу, откуда она берется)
То есть в “среднем” мы ошибаемся на \(3.5\%\)
Точечная оценка вряд ли будет равна реальной разнице между двумя популяциями. Но что если мы возьмем интервал?
Теперь формализуем задачу
- Точечная оценка: \(\Delta p= \hat{p}_{male} - \hat{p}_{female} = 15\%\)
- Связанная с ней переменная нормально распределена: \(\Delta P \sim N(\textrm{ истинная разница }, 3.5\%)\)
- Что мы знаем?
- \(95\%\) всех точечных оценок будет лежать в пределах \(1.96\) стандартных отклонений от истинного центра (истинной разницы)
- То есть, если мы построим интервал \(15\% \pm 1.96*3.5\%\), он будет содержать истинную разницу с вероятностью \(95\%\)
- \(\hat{p} = 15\%, SE_{\hat{P}} = 3.5\%\) - точечная оценка и стандартная ошибка
- \(z^*_{95\%} = 1.96\) - расстояние (это
qnorm(0.025, 0, 1) %>% abs()) - 95% CI: \(\hat{p} \pm z^{*}\times SE = 15\% \pm 1.96*3.5\% = (8.14, 21.86)\) - интервал
- Мы на \(95\%\) уверены, что интервал \((8.14, 21.86)\) содержит реальную разницу
Как правильно коммуницировать этот результат — так, чтобы к вам не придрались зануды вроде меня? Что-то в духе: «Мы оценили реальную разницу в вероятности звонка мужчине и женщине от \(8.14\%\) до \(21.86\%\) на \(95\%\) доверительном уровне». Доверительный уровень нужно указывать всегда: он напоминает, что у вас осталось 5% на ошибку — с вероятностью 5% реальная разница находится за пределами интервала.
Общая формула доверительного интервала
Общий рецепт для любой статистики, которая подпадает под действие ЦПТ:
Доверительный интервал: точечная оценка плюс-минус погрешность \[CI_{\alpha}: \bar{x} \pm z^*\times SE = \bar{x} \pm z^{*}\times \frac{\sigma}{\sqrt{n}}\]
\(\bar{x}, \sigma, n\) считаются на выборке; это данность, на которую мы не влияем
- единственное, что мы выбираем, — это \(z^{*}\), то есть желаемый доверительный уровень. Обычно работают с уровнями \(90\%\), \(95\%\) или \(99\%\)
| Доверительный уровень | z-значение |
|---|---|
| 90% | 1.645 |
| 95% | 1.96 |
| 99% | 2.576 |
Обратите внимание на множитель \(\frac{1}{\sqrt{n}}\) внутри стандартной ошибки: чем больше выборка, тем точнее оценка и тем уже интервал.
Проверка гипотез
Начнем с примера. Предположим, ваш друг утверждает, что студенты, регулярно занимающиеся спортом, учатся лучше, чем студенты в среднем. Вы решаете это проверить:
- Вы опрашиваете 100 случайных студентов, занимающихся спортом, и выясняете, что их средний GPA \(3.4\) балла.
- Из предыдущих исследований вам известно, что средний GPA в Казахстане \(3.3\) балла, а стандартное отклонение - \(0.3\) балла
- Доказывают ли ваши данные, что студенты, занимающиеся спортом, в среднем учатся лучше?
Заметьте: речь о разнице средних, а не о конкретных людях. Видим ли мы разницу 0.1 балла потому, что «спортсмены» действительно другие, — или ее можно списать на случайность выборки?
Формализуем вводные
- Есть случайная переменная \(X\), которая дает GPA случайного студента. Ее распределение неизвестно: \(X \sim Any(\mu, \sigma)\) (мы просим только конечные среднее и стандартное отклонение — это условие отсекает разве что экзотику из квантовой физики)
- Берем 100 случайных студентов-спортсменов и считаем их среднее GPA. Это другая случайная переменная, которую мы обозначаем \(\bar{X}\). Из центральной предельной теоремы мы знаем: \(\bar{X} \sim N(\mu_{sport}, \frac{\sigma}{\sqrt{n}})\)
- \(\mu_{sport}\) - неизвестна, но мы можем предположить. Сама постановка задачи подталкивает к двум сценариям:
- Если наш друг прав и “спортсмены” учатся лучше, их среднее должно быть выше общеказахстанского
- \(\mu_{sport} > 3.3\)
- Если же друг ошибается, и “спортсмены” не лучше общереспубликанского уровня, то их среднее должно быть таким же, как у всех
- \(\mu_{sport} = 3.3\)
- Как мы можем проверить, какое утверждение более правдоподобно?
Гипотезы
Эти два сценария — две конкурирующие гипотезы, и у них есть устоявшиеся имена.
- Нулевая гипотеза - \(H_{0}\) - между переменными нет связи (занятия спортом не влияют на GPA)
- Например, подсудимый НЕ виновен; студенты-спортсмены учатся НЕ лучше чем студенты в целом
- Альтернативная гипотеза - \(H_{A}\) - между переменными есть связь (занятия спортом влияют на GPA)
- Подсудимый виновен; студенты-спортсмены учатся лучше чем студенты в целом
Почему «нулевая»? Потому что она отражает скепсис, на котором строится научное познание: когда нам приводят утверждение, мы говорим — пока не покажешь доказательств, я не поверю. Статус-кво в статистике — утверждение об отсутствии связи. Это согласуется с общим подходом к работе с доказательствами: судебные системы по всему миру руководствуются презумпцией невиновности — пока не доказано обратное, всякий пришедший в суд считается невиновным, и доказать вину — задача обвинения. Между гипотезами есть асимметрия: бремя доказательства лежит на альтернативной.
- Гипотезы должны быть взаимно исключающими и коллективно исчерпывающими
- Подсудимый либо НЕ виновен (\(H_{0}\)), либо виновен (\(H_{A}\)) - третьего не дано
- Студенты-спортсмены учатся НЕ лучше, чем студенты в целом (\(H_{0}\)), ИЛИ они учатся лучше (\(H_{A}\))
- Главная идея: \(H_{0}\) всегда считается верной, пока не доказано обратное (\(H_{A}\)).
И маленький нюанс формулировок: когда доказательств не хватает, мы говорим, что не отвергаем нулевую гипотезу. Это не значит, что мы поверили в ее истинность — мы всего лишь говорим, что недостаточно оснований сдвинуться со статус-кво.
Как тестировать гипотезу?
- Представляем, что нулевая гипотеза верна
- Спрашиваем, насколько вероятны данные, при условии, что нулевая гипотеза верна
- Если данные маловероятны, мы отвергаем нулевую гипотезу в пользу альтернативной
- Если данные вероятны, мы не отвергаем нулевую гипотезу (т.е. остаемся в статусе кво)
Помните, я мучил вас условными вероятностями? Посмотрите на формулировку шага 2: «вероятность данных при условии, что нулевая гипотеза верна» — мы будем рассчитывать не что иное, как условную вероятность. Логика такая: предположим, нулевая гипотеза верна; если при этом вероятность наблюдать наши данные — 1%, то, скорее всего, дело не в редчайшем совпадении, а в том, что предположение неверно. А если вероятность, скажем, 20% — ну, такую разницу вполне можно увидеть и при верной нулевой гипотезе, оснований отказываться от нее нет.
Пример
Вернемся к нашим “спортсменам”. Мы имеем:
Выборочное среднее: \(\bar{x} = 3.4\)
Стандартное отклонение: \(\sigma = 0.3\)
И размер выборки: \(n = 100\)
Положим, что нулевая гипотеза (\(H_0\)) верна. Что из этого следует?
\(X_{sport}\) имеет распределение \(N(\mu_{sport} = 3.3, \sigma_{sport} = 0.3)\) — центр там же, где у всех студентов
А следовательно, среднее ста наблюдений: \(\overline{X}_{sport} \sim N(3.3, SE = \frac{0.3}{10})\). Теперь у нас есть полностью специфицированное распределение — значит, мы можем считать вероятности!
Спросим: какова вероятность, при этом условии, наблюдать выборочное среднее равное \(3.4\) или больше: \(P(\overline{X}_{sport} \geq 3.4)\)?
P-значение (p-value)
P-значение - это вероятность наблюдать данные “как наши” (или даже более экстремальные), при условии, что нулевая гипотеза верна
\[ P(\bar{X} > 3.4|H_{0} \textrm{ верна}) \\ P(\bar{X} > 3.4)| H_{0}: \bar{X} \sim N(\mu = 3.3, SE = 0.03) \\ \]
Как это считали в докомпьютерную эпоху (и как это до сих пор помогает развить интуицию): берем разницу между выборочным и гипотетическим средним и делим на стандартную ошибку — это дает расстояние от гипотетического центра в стандартных ошибках:
\[ z = \frac{\bar{x} - \mu}{SE} = \frac{3.4 - 3.3}{0.03} \approx 3.33 \\ P(Z > 3.33) \approx 0.0004 \]
Наша выборочная средняя находится в 3.33 стандартных ошибках от гипотетического центра. Вероятность уйти так далеко — около 0.04%. Графически это площадь под кривой правее отметки 3.33 — она такая маленькая, что ее почти не видно:
Warning: Removed 60 rows containing missing values or values outside the scale range
(`geom_area()`).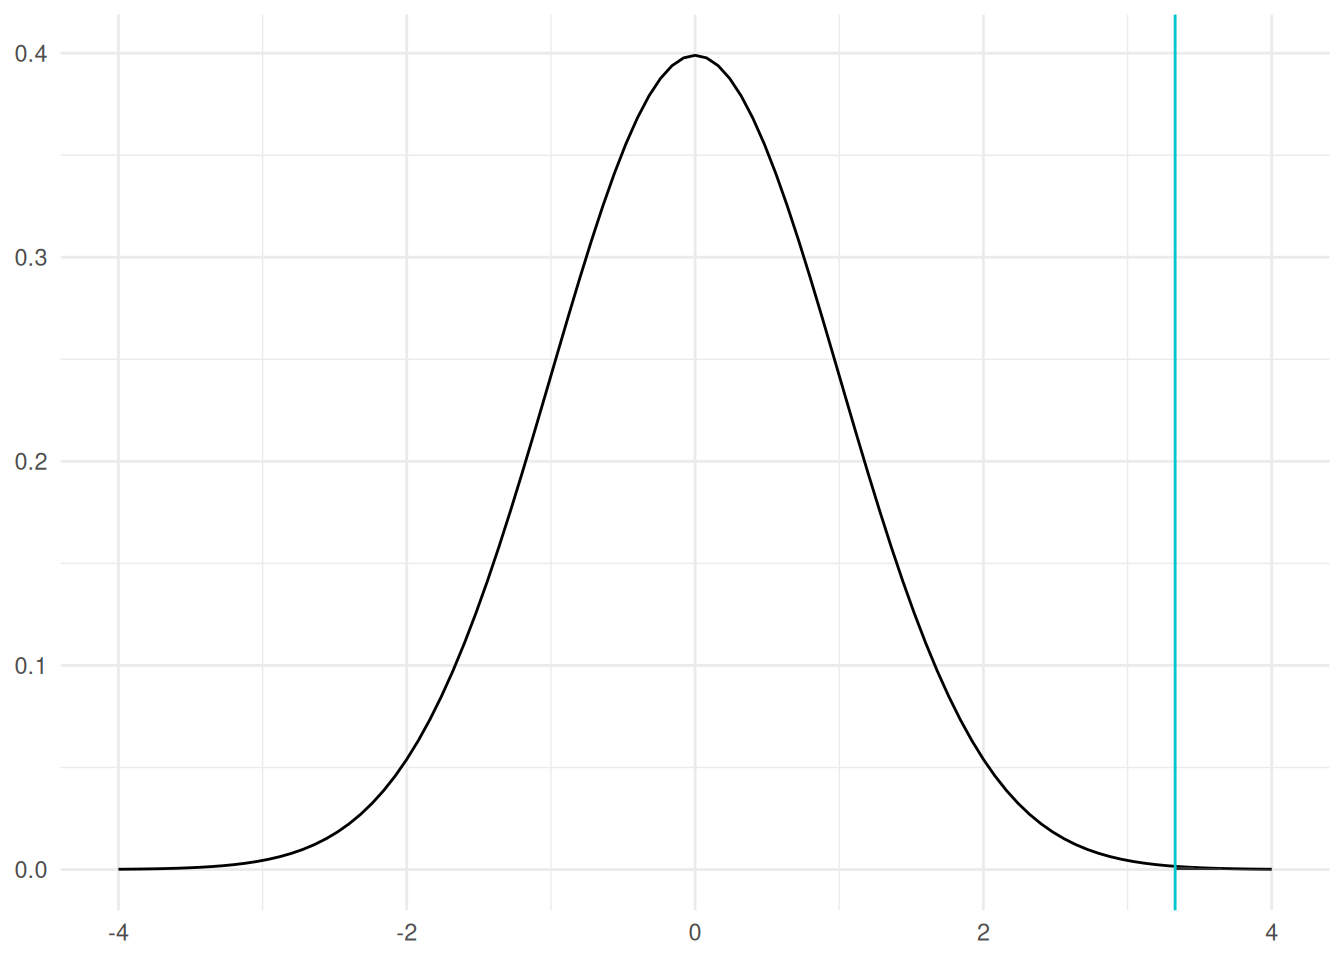
Интерпретация:
- p-значение - это вероятность “данных” при условии, что нулевая гипотеза (\(H_{0}\)) верна.
- Если p-значение меньше некоего уровня значимости (\(\alpha\)), мы говорим, что наблюдать “данные” подобные нашим крайне маловероятно, потому мы отвергаем \(H_{0}\)
- Если p-значение выше \(\alpha\), мы говорим, что наблюдать значения подобные нашим достаточно вероятно, потому НЕ отвергаем \(H_{0}\)
В нашем случае:
- Наше p-значение очень мало: наблюдаемое выборочное среднее крайне маловероятно, если принять, что “спортсмены” учатся так же, как и все
- Мы отвергаем \(H_{0}\). Если бы “спортсмены” ничем не отличались, то вероятность того, что среднее для \(100\) студентов будет \(3.4\) или больше, составляет \(0.04\%\)
- Разница между гипотетическим средним \(3.3\) и выборочным средним \(3.4\) не может быть списана на случайность
Весь сыр-бор вокруг проверки гипотез затевается ради одного: посчитать p-значение. Дальше решение принимается механически — маленькое p-значение: отвергаем; большое: не отвергаем.
p-значение и доверительный интервал
К той же задаче можно подойти и со стороны доверительного интервала — у нас есть все вводные, чтобы его построить:
\[ \bar{x} \pm z^{*}_{95\%}\times\frac{\sigma}{\sqrt{n}} = 3.4 \pm 1.96\times\frac{0.3}{10} = \\ 3.4 \pm 1.96\times0.03 \approx (3.34, 3.45) \]
Окей, у нас есть интервал \((3.34, 3.45)\). Что он может нам сказать?
\(H_{0}: \mu = 3.3\); \(H_{A}: \mu > 3.3\)
\(\mu = 3.3 \notin (3.34, 3.45) \implies H_{0} \textrm{ отвергнута }\)
Наш доверительный интервал не содержит гипотетическое среднее. А ошибается он только в \(5\%\) случаев
Проверка гипотез и доверительный интервал — две стороны одной монеты: если тест на уровне значимости 5% велит отвергнуть \(H_0\), то 95%-й доверительный интервал не будет содержать гипотетическое значение, и наоборот.
1- и 2-сторонние тесты
- В примере выше мы интересовались гипотезой “спортсмены лучше обычных студентов”: \(\mu_{sport} > \mu_{all}\) — мы своей решительной волей сразу отвергли сценарий «спортсмены учатся хуже».
- Но мы могли бы задать более общий вопрос: “спортсмены не такие, как обычные студенты”: \(\mu_{sport} \neq \mu_{all}\)
- Что можно представить в виде двух сценариев: либо лучше, либо хуже: \(\mu_{sport} > \mu_{all}\) или \(\mu_{sport} < \mu_{all}\)
- Проверка гипотез первого типа называется односторонним тестом, второго — двусторонним
- p-значение при двусторонней гипотезе будет, как правило, в два раза больше, чем при односторонней, потому что мы складываем вероятности двух событий (“лучше” и “хуже”)
Формально это выглядит так:
Нулевая гипотеза: \(\mu_{sport} = 3.3\)
1-сторонняя альтернативная гипотеза: \(\mu_{sport} > 3.3 \implies \textrm{p-значение} = P(\overline{X} > 3.4|H_{0})\)
2-сторонняя альтернативная гипотеза: \(\mu_{sport} \neq 3.3 \implies \textrm{p-значение} = P(\overline{X} > 3.4 \textrm{ ИЛИ } \overline{X} < 3.2 | H_{0})\)
Откуда взялось 3.2? Это симметричная точка по другую сторону от гипотетического центра: 3.4 ушло от 3.3 на одну десятую вверх, 3.2 — на столько же вниз.
Какой из тестов более консервативен — то есть с меньшей готовностью отвергает нулевую гипотезу? Двусторонний: его p-значение всегда больше, ведь мы складываем вероятности двух сценариев. Поэтому, если даже двусторонний тест велит отвергнуть \(H_0\), вы можете быть увереннее в силе доказательств. При прочих равных — если нет серьезных оснований рассматривать только одно направление — предпочитайте двусторонний тест.
Общий алгоритм
- Озвучиваем гипотезы
- \(H_{0}: \mu = \textrm{ null value }\)
- \(H_{A}: \mu < \textrm{ или } > \textrm{ или } \neq \textrm{ null value }\)
- Считаем выборочное среднее: \(\overline{x}\)
- Определяем распределение при условии, что \(H_{0}\) верна. Считаем \(z\)-значение для выборочного среднего и вероятность наблюдать среднее экстремальнее нашего
- \(z = \frac{\overline{x} - \mu_{0}}{SE_{0}}, \quad SE_{0} = \frac{sd}{\sqrt{n}}, \quad P(Z > |z| \ |H_{0}) = \textrm{p-значение}\)
- Сравниваем p-значение с уровнем значимости \(\alpha\)
- Если \(\textrm{p-значение} < \alpha\): отвергаем \(H_{0}\), данные убедительно говорят в пользу \(H_{A}\)
- Если \(\textrm{p-значение} > \alpha\): НЕ отвергаем \(H_{0}\), данные не вполне убедительно говорят в пользу \(H_{A}\)
Уровень значимости \(\alpha\) вы выбираете сами, до анализа. Никакой теории, которая делала бы один уровень лучше другого, нет — это конвенции, и они варьируются от дисциплины к дисциплине; на практике чаще всего встречаются 5% и 1%. Коммуницируя результаты, всегда указывайте уровень явно: «данные на 5%-м уровне значимости говорят в пользу альтернативной гипотезы».
Пример
Исследователь решил проверить, как много учатся его сокурсники. Он опросил \(100\) случайных студентов своего университета, и среднее время учебы оказалось \(10.3\) часа в неделю. Из предыдущих исследований студент знает: в среднем студент в Казахстане учится \(9.8\) часов в неделю со стандартным отклонением \(2\) часа. Проверьте гипотезу о том, что сокурсники студента в среднем учатся больше, чем студенты в Казахстане. Используйте уровень значимости \(\alpha = 0.01\).
Давайте выпишем наши гипотезы.
\[ H_{0}: \mu_{uni} = 9.8 = \mu_{kz}\\ H_{A}: \mu_{uni} > 9.8 = \mu_{kz} \]
Допустим, \(H_{0}\) верна — тогда случайный сокурсник ничем не отличается от обычного студента: \(X_{uni} \sim N(\mu_{kz} = 9.8, \sigma_{kz} = 2)\). Если так, то среднее ста таких студентов будет распределено \(\overline{X}_{uni} \sim N(\mu = 9.8, SE = \frac{sd}{\sqrt{n}} = \frac{2}{\sqrt{100}} = 0.2)\)
Мы наблюдаем \(\overline{x} = 10.3\) и можем посчитать, как далеко это наблюдение от своего ожидания: \(z = \frac{10.3 - 9.8}{0.2} = 2.5\). Теперь считаем вероятность: \(P(\overline{X} > 10.3|H_{0}) = P(Z > 2.5) \approx 0.006 < \alpha = 0.01\). P-значение меньше уровня значимости, поэтому мы отвергаем \(H_{0}\) в пользу \(H_{A}\).
Теперь посмотрите, что произойдет, если вместо односторонней гипотезы проверить двустороннюю: \(\mu_{uni} \neq \mu_{KZ}\) (студенты универа учатся НЕ так, как студенты по Казахстану).
\[ P(Z < -2.5 \textrm{ ИЛИ } Z > 2.5| H_{0}) = \\ P(\overline{X} < 9.3 \textrm{ ИЛИ } \overline{X} > 10.3| H_{0}) \\ \approx 2 \times 0.006 = 0.012 > 0.01 = \alpha \]
В этом случае мы НЕ отвергаем \(H_{0}\): данные НЕ вполне убедительно доказывают, что студенты универа в среднем учатся больше ИЛИ меньше, чем студенты по Казахстану, на \(99\%\) доверительном уровне.
Если бы \(H_{0}\) была верна, \(1.2\%\) выборочных средних оказывались бы в \(2.5\) стандартных ошибках от своего ожидания — это редко, но не настолько, чтобы отбросить нулевую гипотезу при пороге в 1%.
Статистический вывод для прочих оценок
Как это работает для прочих статистик? Если статистика имеет нормальное распределение, все проходит по одному и тому же сценарию. Мы рассмотрим четыре случая, но список статистик, подпадающих под ЦПТ, гораздо длиннее:
- Выборочные средние \(\overline{X} \sim N\)
- Разница между выборочными средними \(\overline{X_1} - \overline{X_2} \sim N\)
- Выборочная пропорция \(\hat{P} \sim N\)
- Разница между выборочными пропорциями \(\hat{P_1} - \hat{P_2} \sim N\)
Общий подход
Доверительный интервал для околонормальных оценок \[\textrm{точечная оценка} \pm z^{*} \times SE\]
Проверка гипотез \[z = \frac{\textrm{точечная оценка - нулевое значение}}{SE} \\ \textrm{p-значение} = P(Z > z) \textrm{, если 1-сторонняя гипотеза} \\ \textrm{p-значение} = P(Z > z) + P(Z < -z) \textrm{, если 2-сторонняя гипотеза} \]
Стандартная ошибка
Самое сложное — найти стандартную ошибку, \(SE\), поскольку она зависит от типа оценки:
- например, стандартная ошибка выборочного среднего: \(SE(\overline{X}) = \frac{\sigma}{\sqrt{n}}\)
- а вот для выборочной пропорции: \(SE(\hat{P}) = \sqrt{\frac{p_0(1-p_0)}{n}}\)
Выглядит так, будто нужно запоминать кучу несвязанных формул. Так ли это? Присмотритесь: в знаменателе везде \(\sqrt{n}\) — фактор, который уменьшает ошибку с ростом выборки. А в числителе… вспомните главу про дискретные переменные: \(p_0(1-p_0)\) — это дисперсия переменной Бернулли! Перепишем первую формулу как \(\sqrt{\sigma^2/n}\), и общая структура станет видна: стандартная ошибка — это всегда корень из дисперсии исходной переменной, деленной на размер выборки. Просто для среднего под корнем стоит дисперсия нормальной переменной, а для пропорции — дисперсия бернуллиевской.
Также напомним: стандартная ошибка — это стандартное отклонение выборочной статистики. У вас есть переменная \(X \sim Any(\mu, \sigma)\), вы берете \(n\) наблюдений — это выборка — и считаете на ней статистику, например среднее \(\overline{X}\). Стандартное отклонение этой выборочной статистики и есть стандартная ошибка, и она уменьшается с ростом выборки.
Пример: выборочная пропорция
Я как-то читал исследование 2017 года: у жителей Германии спрашивали, какой, по их мнению, процент населения составляют мигранты. Исследование, кстати, было о том, что люди систематически преувеличивают число мигрантов — то, к чему мы не привыкли, мы регистрируем лучше и потому считаем более частым, чем оно есть. Проверьте себя:
Как вы думаете, какой процент от населения Германии в 2017 составляли мигранты?
- 15%
- 20%
- 25%
Правильный ответ: a, 15%.
Теперь превратим это исследование в пример. Допустим, мы задали этот вопрос с тремя вариантами ответа 400 случайным студентам, и 150 из них (или \(37.5\%\)) ответили верно. Если бы студенты просто гадали, шанс угадать был бы \(1/3 \approx 33.3\%\). Наши \(37.5\%\) выше — но достаточно ли, чтобы утверждать, что студенты отвечали лучше, чем наугад? Уровень значимости возьмем \(\alpha = 0.01\). Стандартная ошибка выборочной пропорции — \(2.4\%\).
Кстати, вопрос из аудитории: разве \(37.5\% - 2.4\% \neq 33.3\%\) уже не решает дело? Нет: уйти от центра на одну стандартную ошибку — совершенно рядовое событие; редким считается расстояние в две (бывает в ~5% случаев) и тем более три стандартные ошибки.
Прежде чем тестировать, посмотрим, откуда взялась стандартная ошибка. Введем переменную:
\(\hat{P}_n = \frac{Y}{n}\) - пропорция “успехов” (правильных ответов) в \(n\) испытаниях
- оценка истинной, но неизвестной, популяционной пропорции \(p_{true}\)
Когда мы тестируем гипотезы, мы принимаем, что истинная популяционная пропорция равна некоему гипотетическому значению \(p_{true} = p_{0}\), и хотим узнать, насколько это правдоподобно
Можно заметить, что число успехов - это биномиальная переменная: \(Y \sim Bi(p_0, n)\), что значит \(E[Y] = p_{0}n\), а также \(var(Y) = p_{0}(1-p_{0})n\)
Дальше — немного математики (необязательной, но поучительной), использующей свойства ожидания и дисперсии из главы про дискретные переменные:
- Каково ожидание выборочной пропорции \(\hat{P}_n\)? \[ E[\hat{P}_n] = E\big[\frac{Y}{n}\big] = \frac{1}{n}E[Y]=\frac{p_0n}{n} = p_0 \] Ожидание выборочной пропорции равно гипотетической популяционной пропорции — все сходится с ЦПТ.
- А дисперсия? \[ var(\hat{P}_n) = var\big( \frac{Y}{n} \big) = \frac{1}{n^2}var(Y) = \frac{p_0(1-p_0)n}{n^2} = \frac{p_0(1-p_0)}{n} \]
- Соответственно, стандартная ошибка \(\hat{P}_n\): \[ sd(\hat{P}_n) = \sqrt{\frac{p_{0}(1-p_{0})}{n}} \]
- Я сказал вам, что стандартная ошибка в примере \(2.4\%\) — все сходится: \[ sd(\hat{P}_n) = \sqrt{\frac{0.33(1-0.33)}{400}} \approx 0.024 \]
Теперь решение по общему алгоритму.
- Гипотезы
\[ H_{0}: p_{uni} = 0.33 = p_{0} \\ H_{A}: p_{uni} > 0.33 = p_{0} \]
Точечная оценка: \(\hat{p} = 0.375\)
Считаем z-статистику и p-значение
\[ z = \frac{\hat{p} - p_0}{SE} = \frac{0.375 - 0.333}{0.024} = \frac{0.042}{0.024} = 1.75 \\ \textrm{p-значение} = P(Z > 1.75|H_0) \approx 0.04 > 0.01 = \alpha \implies \textrm{НЕ отвергаем } H_0 \]
pnorm(1.75, mean = 0, sd = 1, lower.tail = FALSE)[1] 0.04005916- Вывод: данные НЕ дают вполне убедительного доказательства, что средний студент разбирается в вопросе лучше, чем случайное угадывание.
То же самое в R
- Функция
prop.test()тестирует гипотезу о том, что истинная пропорция равна некоему значению (которое вы предлагаете). Указываем число успехов, число наблюдений, гипотетическое значение, формат альтернативной гипотезы (greater,lessилиtwo.sided) и доверительный уровень:
test <- prop.test(150, n = 400, p = 0.33,
          alternative = "greater",
          conf.level = 0.99)
test
    1-sample proportions test with continuity correction

data:  150 out of 400, null probability 0.33
X-squared = 3.4628, df = 1, p-value = 0.03138
alternative hypothesis: true p is greater than 0.33
99 percent confidence interval:
 0.3195126 1.0000000
sample estimates:
    p
0.375
Главное, на что нужно смотреть в выводе, — p-значение. Заметьте, оно немного отличается от нашего ручного расчета: мы использовали нормальную аппроксимацию по ЦПТ, а prop.test() работает с точным биномиальным распределением. Один фиг оно больше уровня значимости:
test$p.value < 0.01[1] FALSEЧто делаем? Не отвергаем! Обратите внимание: R даже посчитал для вас 99%-й доверительный интервал, и гипотетические 33% в него попадают — тот же вывод с другой стороны монеты.
Мы могли бы поиграть с параметрами: проверим двустороннюю альтернативу на уровне значимости 5%
another_test <- prop.test(150, n = 400, p = 0.33,
          alternative = "two.sided",
          conf.level = 0.95)
another_test
    1-sample proportions test with continuity correction

data:  150 out of 400, null probability 0.33
X-squared = 3.4628, df = 1, p-value = 0.06276
alternative hypothesis: true p is not equal to 0.33
95 percent confidence interval:
 0.3277503 0.4246901
sample estimates:
    p
0.375
P-значение выросло (двусторонний тест консервативнее) и все равно больше 5% — опять не отвергаем.
Две пропорции
Вернемся, как и обещал, к примеру с резюме — теперь мы готовы сами посчитать ту стандартную ошибку в 3.5%.
- \(\hat{P}_1\) и \(\hat{P}_2\) - две пропорции для двух выборок, \(n_1, n_2\)
- \(\hat{P}_1 = 0.23\) и \(\hat{P}_2 = 0.08\)
- \(n_1 = 100\) и \(n_2 = 100\)
- Введем новую переменную \(\Delta \hat{P} = \hat{P}_1 - \hat{P}_2\)
- Ее ожидание — просто разница истинных пропорций:
\[ E[\Delta \hat{P}] = E[\hat{P}_1 - \hat{P}_2] = E[\hat{P}_1] - E[\hat{P}_2] = p_1 - p_2 \]
- А дисперсия? Используем свойство дисперсии: для независимых переменных дисперсия суммы (и разности — это то же сложение со знаком минус) равна сумме дисперсий:
\[\begin{align*} var(\Delta \hat{P}) = var(\hat{P}_1 - \hat{P}_2) = \\ var(\hat{P}_1) + var(\hat{P}_2) = \frac{p_1(1 - p_1)}{n_1} + \frac{p_2(1 - p_2)}{n_2} \\ sd(\Delta \hat{P}) = \sqrt{\frac{p_1(1 - p_1)}{n_1} + \frac{p_2(1 - p_2)}{n_2}} \end{align*}\]
Комбинированная пропорция (pooled proportion)
- Истинных \(p_1\) и \(p_2\) мы не знаем, но нулевая гипотеза подсказывает, чем их заменить. Допустим, \(H_0: p_1 = p_2\)
- Что то же самое, что и \(H_0: \Delta P = 0\)
Если пропорции равны, обозначим их общее значение \(p_0\) и оценим его, объединив успехи обеих выборок. Тогда дисперсия \(\Delta \hat{P}\):
\[\begin{align*} var(\Delta \hat{P}) = \frac{p_0(1-p_0)}{n_1} + \frac{p_0(1-p_0)}{n_2}\\ sd(\Delta \hat{P}) = SE = \sqrt{\frac{p_0(1-p_0)}{n_1} + \frac{p_0(1-p_0)}{n_2}} \\ \textrm{где } p_0 = \frac{n_1p_1 + n_2p_2}{n_1 + n_2} \end{align*}\]
Теперь все вместе
\[ H_0: \Delta P = 0, \quad H_A: \Delta P \neq 0 \]
\[ \Delta\hat{P} \sim N\left(0, \ \sqrt{\frac{p_0(1-p_0)}{n_1} + \frac{p_0(1-p_0)}{n_2}}\right) \]
Считаем (выборки одинакового размера, поэтому комбинированная пропорция — просто среднее двух):
\[\begin{align*} p_0 = \frac{p_1+p_2}{2} = \frac{0.23 + 0.08}{2} = 0.155 \\ sd(\Delta \hat{P}) = \sqrt{\frac{2(0.155)(1 - 0.155)}{100}} \approx 0.05 \\ z = \frac{0.15 - 0}{0.05} = 3 \\ \textrm{p-значение} = 2 \times P(Z > 3) \approx 0.003 \end{align*}\]
Наша разница ушла на три стандартных ошибки от гипотетического нуля — вероятность такого события около 0.3%. У нас есть убедительные доказательства (по крайней мере, для этого стилизованного примера), что мужчинам перезванивают чаще.
- А теперь в R.
prop.test()работает и для двух выборок: первым вектором указываем число успехов в каждой группе, вторым — размеры групп
two_prop_test <-
  prop.test(c(23, 8), c(100, 100))
two_prop_test
    2-sample test for equality of proportions with continuity correction

data:  c(23, 8) out of c(100, 100)
X-squared = 7.4823, df = 1, p-value = 0.006231
alternative hypothesis: two.sided
95 percent confidence interval:
 0.0418647 0.2581353
sample estimates:
prop 1 prop 2
  0.23   0.08
P-значение меньше 1% — отвергаем нулевую гипотезу о равенстве пропорций.
Пример: ЕНТ
У нас есть выборка из 5000 случайно выбранных старшеклассников и их результаты ЕНТ. Среднее значение для 2465 мальчиков по выборке \(70.5\%\), а среднее значение для девочек \(72.3\%\). Стандартная ошибка для разницы между средними — \(0.9\). Дают ли эти данные убедительное доказательство того, что девушки сдают ЕНТ лучше парней, на уровне значимости \(\alpha = 0.05\)?
- Гипотезы
\[ H_{0}: \mu_{girls} = \mu_{boys}, \quad H_{A}: \mu_{girls} > \mu_{boys} \\ \textrm{нулевое значение} = \mu_{girls} - \mu_{boys} = 0 \]
Точечная оценка \[ \overline{x}_{girls} - \overline{x}_{boys} = 72.3 - 70.5 = 1.8 \]
z-статистика и p-значение \[ z = \frac{1.8}{0.9} = 2 \\ \textrm{p-значение} = P(Z > 2|H_0) \approx 0.02 < \alpha = 0.05 \implies \textrm{отвергаем } H_0 \]
Данные убедительно доказывают, что средний балл ЕНТ у девушек выше, чем у парней.
Обратите внимание на концептуальную вещь: разница-то принципиально небольшая — 1.8 балла. Но это разница между средними двух очень больших групп, и статистический тест говорит: даже такая маленькая разница крайне маловероятна, будь нулевая гипотеза верна. Статистическая значимость не означает, что разница велика практически, — это два разных вопроса.
Ошибки 1-го и 2-го рода
Когда вы проводите тест, реальность вам недоступна — нулевая гипотеза может быть на самом деле верна или неверна, и в каждом случае ваше решение может оказаться правильным или ошибочным. Итого четыре сценария:
| Реальность\Решение | НЕ отвергаем \(H_{0}\) | отвергаем \(H_{0}\) |
|---|---|---|
| \(H_{0}\) верна | OK | Ошибка 1-го рода |
| \(H_{A}\) верна | Ошибка 2-го рода | OK |
- Ошибка 1-го рода: отвергаем \(H_{0}\), когда в действительности \(H_{0}\) верна. Ложноположительная.
- Ошибка 2-го рода: НЕ отвергаем \(H_{0}\), когда \(H_{A}\) верна. Ложноотрицательная.
Как запомнить всю эту терминологию? Мне помогают медицинские аналогии. У вас может быть ковид, а может не быть; нулевая гипотеза — что ковида нет (это статус-кво). Вам делают тест. Если ковида не было, а тест сказал «есть» — это ошибка 1-го рода, ложноположительный диагноз. Если ковид был, а тест его не заметил — ошибка 2-го рода, ложноотрицательный.
Еще одна классика — судебный процесс:
- В суде вы либо НЕ совершали преступление (\(H_0\)), либо совершали (\(H_A\)).
- Ошибка 1-го рода: “наказание невиновных” — \(H_{0}\) верна, но мы ошибочно отвергаем ее: вы ничего не делали, но вас признали виновным
- Ошибка 2-го рода: “сошло с рук” — \(H_{A}\) верна, но \(H_{0}\) не отвергнута: вы совершили преступление, но вас признали НЕ виновным и отпустили
- Как можно снизить вероятность ошибки 2-го рода? И как это повлияет на вероятность ошибки 1-го рода?
- Чтобы снизить вероятность ошибки 2-го рода, нужно наказывать больше людей: быть сверхстрогими и любой намек на преступление принимать за достаточное доказательство
- Однако, повышая строгость, мы рискуем наказывать все больше невиновных — вероятность ошибки 1-го рода растет
Между двумя ошибками всегда есть трейд-офф. Полностью устранить одну из них легко: отпускайте всех — никогда не накажете невиновного; наказывайте всех — никто не уйдет безнаказанным. Проблема в том, что цена — взрывной рост другой ошибки. Единственный честный способ уменьшить обе ошибки сразу — увеличить размер выборки. А дальше вы сами решаете, какая ошибка для вашей задачи критичнее.
Напоследок свяжем ошибки с уже знакомыми величинами:
| Реальность\Решение | НЕ отвергаем \(H_{0}\) | отвергаем \(H_{0}\) |
|---|---|---|
| \(H_{0}\) верна | \(1 - \alpha\) | Ошибка 1-го рода, \(\alpha\) |
| \(H_{A}\) верна | Ошибка 2-го рода, \(\beta\) | \(1 - \beta\) |
\(\alpha\) - уровень значимости (significance level) - это в точности вероятность ошибки 1-го рода: вероятность ошибочно отвергнуть верную нулевую гипотезу
Доверительный уровень = \(1 - \alpha\)
Вероятность ошибки 2-го рода обозначают \(\beta\); работа с ней (через так называемую мощность теста, \(1-\beta\)) обычно выходит за рамки вводного курса