11 Распределение хи-квадрат, t-распределение и ANOVA
Распределение хи-квадрат
Мы выяснили, что ценность Центральной Предельной Теоремы заключается в том, что она показывает: выборочное среднее имеет нормальное распределение. Этот факт затем используется для построения доверительных интервалов и проверки гипотез. То есть, зная форму распределения, мы можем легко рассчитать интересующие нас величины: погрешности для доверительных интервалов и p-значения.
Этот подход может быть расширен и на случай других распределений. Нормальное распределение — выдающееся во многих отношениях, но по большому счету нам просто важно знать, что некая величина имеет известное распределение. Зная распределение, всегда можно посчитать квантили (т.е. расстояния от центра) и вероятности, а это, собственно, все что нам нужно для доверительных интервалов или проверки гипотез.
В этой главе мы познакомимся с тремя распределениями, которые активно используются в статистическом выводе: хи-квадрат, t-распределением Стьюдента и — в разделе про ANOVA — F-распределением. Все три являются «родственниками» нормального распределения: они конструируются из стандартных нормальных переменных. Начнем с хи-квадрат.
Хи-квадрат
Начнем с формального определения. Положим, что у нас есть набор стандартных нормальных переменных \(Z_i \sim N(0, 1)\). Если мы возьмем квадраты этих стандартных нормальных
\[\chi_{n}^2 := \sum_{i=1}^{n}Z_{i}^2\]
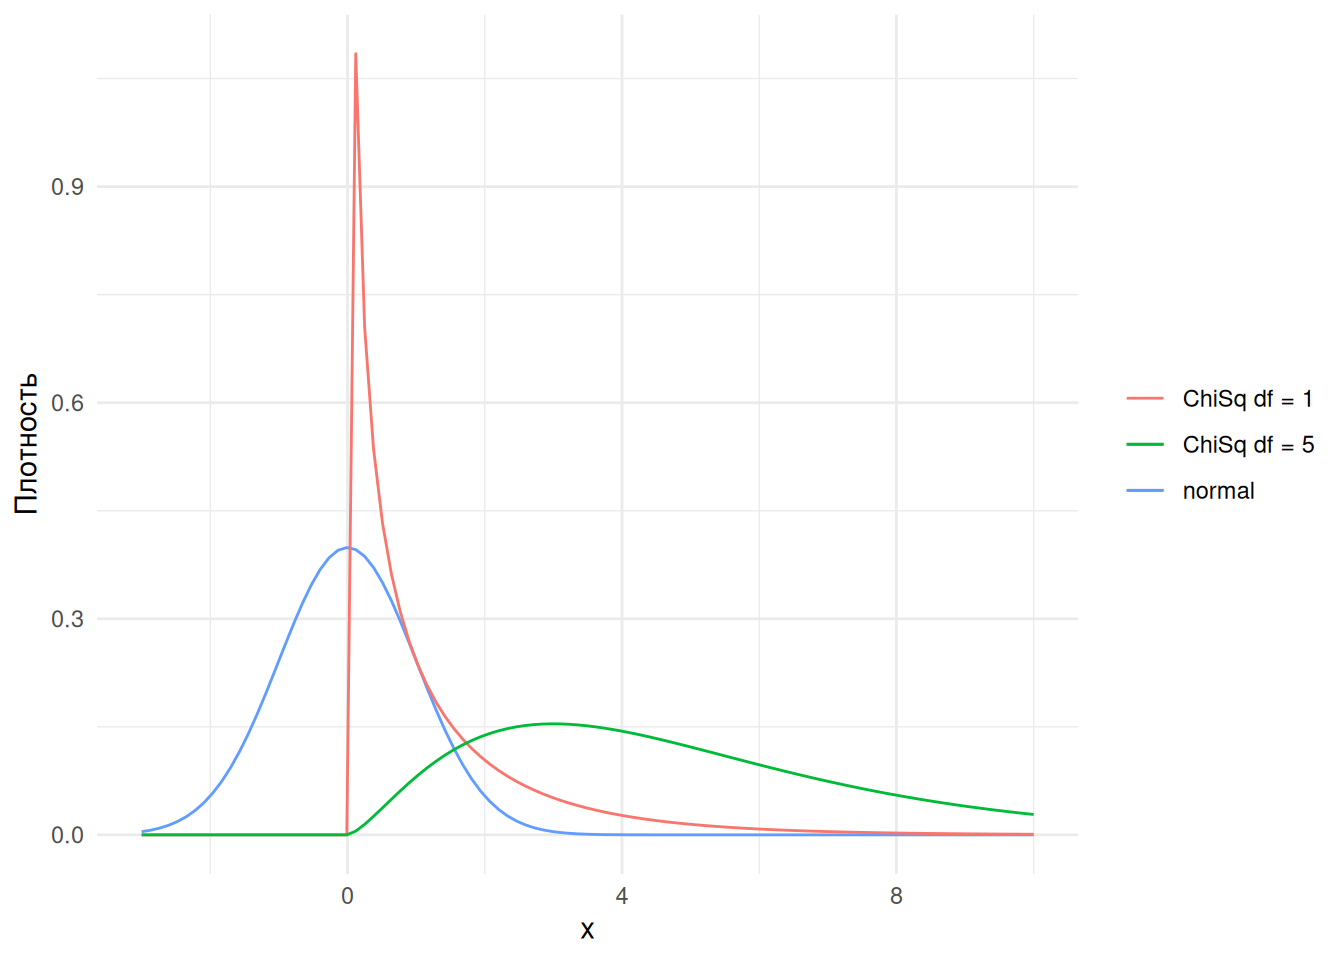
То сконструированная таким образом переменная будет иметь распределение хи-квадрат. Поскольку любая функция от случайной переменной тоже является случайной переменной, мы получили новую случайную переменную. Хи-квадрат - это сумма квадратов, поэтому это строго положительная случайная переменная: стандартное нормальное может быть отрицательным, но после возведения в квадрат отрицательные числа исчезают. Далее, единственный параметр, от которого она зависит - это число стандартных нормальных, которые складываются. Этому параметру дали специальное имя - степень свободы (degrees of freedom, df). Ниже показаны стандартное нормальное, хи-квадрат с одной степенью свободы (т.е. просто квадрат нормального), хи-квадрат с пятью степенями свободы (т.е. сумма пяти квадратов нормального).
Мы видим, что хи-квадрат — несимметричное распределение с длинным правым хвостом. Нам принципиально не нужно знать формулу, по которой вычисляется его плотность: формула сложная и не самая приятная, но она есть, и за нас уже все посчитали. Нам достаточно знать, что распределение реализовано внутри R и что многие тестовые статистики, оказывается, имеют распределение хи-квадрат — как правило, при допущении, что нулевая гипотеза верна. Хи-квадрат будет естественным образом возникать там, где появляются квадраты случайных величин. После этого мы можем легко считать связанные вероятности. Например, \(P(X > 10)\) или \(P(X > 15)\)?
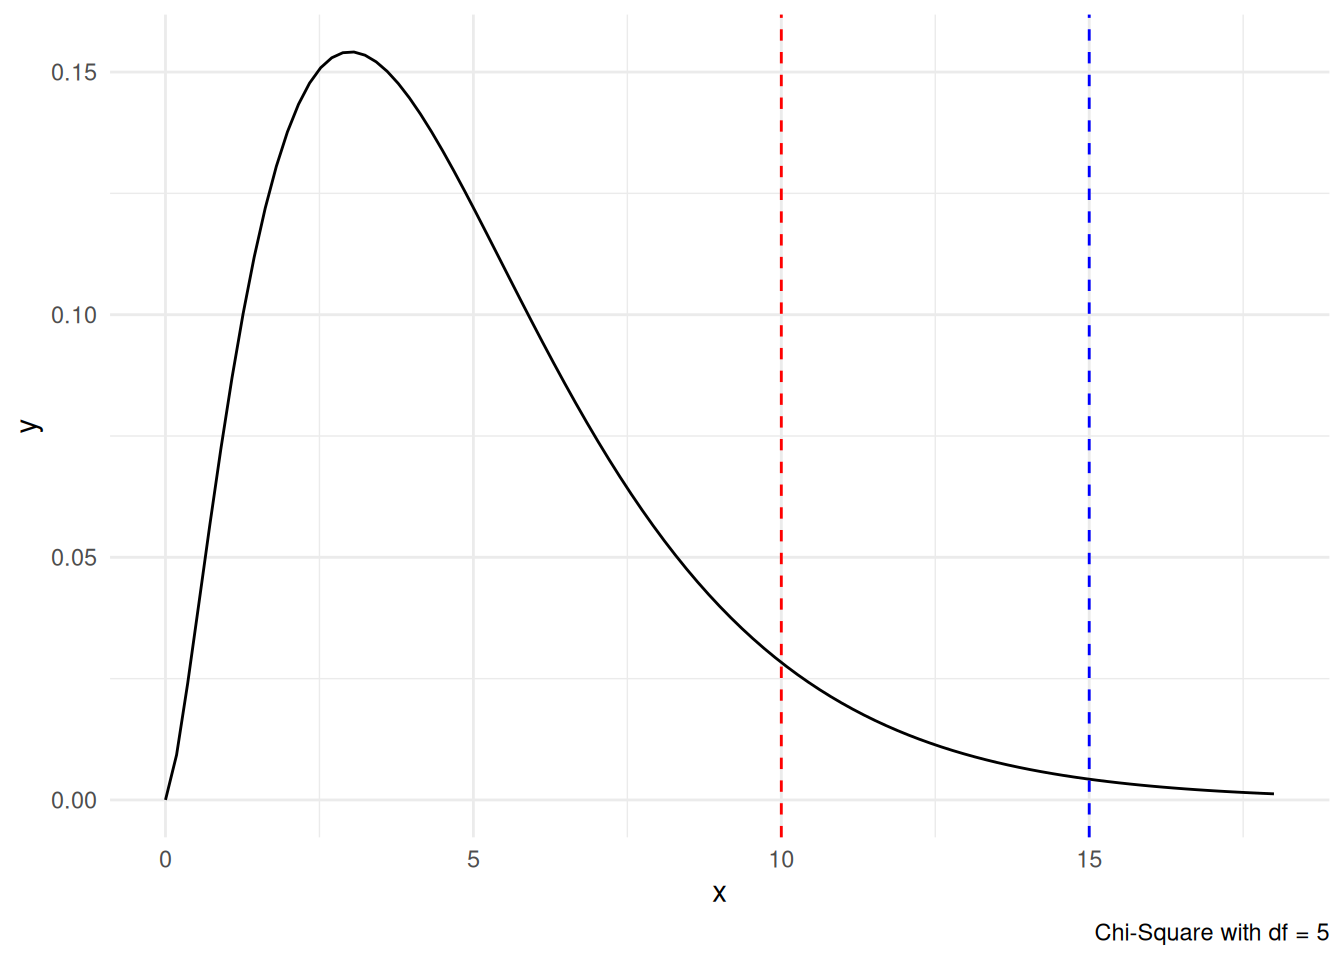
Кстати, глядя на эти два числа: какое событие — первое или второе — имеет большую вероятность? Первое: визуально площадь под кривой правее 10 больше, чем правее 15. Чем ближе значение к центру распределения, тем больше вероятность уйти за него. И обратите внимание на мысль, которую я постоянно повторяю: если мы знаем аналитическую форму распределения, мы всегда можем посчитать такие вероятности. А эти вероятности — как раз то, что нужно, чтобы считать p-значения. Общий принцип практически всех статистических тестов: притвориться, что нулевая гипотеза верна. Очень часто при этом допущении у вашей тестовой статистики сразу появляется известная форма распределения, и вы можете посчитать вероятность того, что статистика приняла значение как у вас (или экстремальнее), при условии, что нулевая гипотеза верна. Если эта вероятность маленькая — вы отвергаете нулевую гипотезу; если большая — не отвергаете. 99% всех статистических тестов работают по этому принципу.
ЗаметкаПринцип
Когда мы знаем по какому закону распределена тестовая статистика, мы можем посчитать вероятность данных при условии, что нулевая гипотеза верна
Пример: присяжные и репрезентативность
Разберем пример (взят из учебника OpenIntro; он написан американцами, поэтому и реалии американские, но для нас в нем тоже есть польза). Административное деление в США двухуровневое: на первом уровне штаты, внутри штатов — округа (counties), примерно соответствующие нашим районам. В США действует суд присяжных, и присяжных набирают лотереей из числа зарегистрированных избирателей округа.
Пусть у нас есть выборка из 275 присяжных в небольшом округе США. Таблица ниже дает разбивку выборки по демографическим категориям (в переписях США людей принято делить на белых, черных, испаноговорящих и прочих), а также доли этих категорий в масштабах всего округа. Является ли выборка присяжных репрезентативной округу? Если присяжных набирали действительно случайно, структура выборки должна повторять структуру округа (т.е. пропорции должны быть примерно похожи).
| Race | White | Black | Hispanic | Other | Total |
|---|---|---|---|---|---|
| Выборка | 205 | 26 | 25 | 19 | 275 |
| Всего в округе (%) | 0.72 | 0.07 | 0.12 | 0.09 | 1.00 |
Уже на глаз видны небольшие несоответствия: например, испаноговорящих в округе живет существенно больше (12%), чем черных американцев (7%), а в структуре присяжных их примерно поровну. Вопрос: эта разница между долями в округе и структурой присяжных — просто случайность, или есть какой-то систематический фактор, который приводит к недобору, скажем, испаноговорящих присяжных?
У нас есть две гипотезы: Нулевая - выборка случайна (и соответственно репрезентативна). Альтернативная - выборка НЕ случайна. Допустим, нулевая гипотеза верна. Если присяжных выбирали случайно, то сколько из 275 человек будут white? Сколько из них будут black?
Около \(72\%\) населения - white, поэтому около 72 % присяжных будут белыми: \(0.72\times275 = 198\). Аналогично, около \(7\%\) присяжных будут black, или \(0.07\times275 = 19.25\). Следуя этой логике, мы могли рассчитать ожидаемые значения для нулевой гипотезы
| Race | White | Black | Hispanic | Other | Total |
|---|---|---|---|---|---|
| Наблюдаемые значения | 205 | 26 | 25 | 19 | 275 |
| Пропорции населения | 0.72 | 0.07 | 0.12 | 0.09 | 1.00 |
| Ожидаемые значения (при нулевой гипотезе) | 198 | 19.25 | 33 | 24.75 | 275 |
Между наблюдаемыми и ожидаемыми значениями есть разница. Вопрос в том, насколько она велика: убеждает ли она вас в существовании систематического фактора? На глаз сказать тяжело — хорошо, что у нас есть более строгий способ проверить.
Итак, у нас кросс-таблица, с наблюдаемыми (\(O_i\)) и ожидаемыми (\(E_i\)) значениями. Много лет назад математики показали, что следующая тестовая статистика имеет распределение Хи-квадрат
\[\sum_{i = 1}^{n}\frac{(O_i - E_i)^2}{E_i} \sim \chi^2_{n-1}\]
Присмотритесь к конструкции: в числителе — квадраты отклонений наблюдаемого от ожидаемого (вот откуда берется хи-квадрат: мы снова складываем квадраты), а деление на \(E_i\) приводит все ячейки к одному масштабу, чтобы большие категории не перевешивали маленькие.
Почему степеней свободы \(n-1\), а не \(n\)? У нас четыре ячейки, но сумма наблюдений зафиксирована: всего присяжных 275. Если мы знаем три ячейки из четырех, четвертая определяется автоматически — свободно «гулять» могут только \(n-1\) ячеек. Отсюда и название «степени свободы».
Доказывать саму теорему мы не будем: верим математикам на слово. Единственная оговорка — приближение хи-квадратом работает хорошо, когда ожидаемые значения не слишком малы (стандартное правило: каждое \(E_i \geq 5\); у нас минимальное — 19.25, так что все в порядке). Зная этот факт, мы можем проверить гипотезу, что выбор присяжных был случаен. Считаем статистику:
\[\begin{align*} \chi^2_{df = 3} &= \frac{(205 - 198)^2}{198} + \frac{(26 - 19.25)^2}{19.25} \\ &\quad + \frac{(25 - 33)^2}{33} + \frac{(19-24.75)^2}{24.75} \\ &\approx 0.247 + 2.367 + 1.939 + 1.336 \approx 5.889 \end{align*}\]
Значение статистики \(\chi^2 = 5.889\) показывает, насколько сильно наблюдаемые значения расходятся с ожидаемыми. Теперь зададим главный вопрос: какова вероятность \(P(\chi^2 > 5.889)\), что данные разойдутся с ожиданием так же, как у нас, или даже сильнее? Обратите внимание, что рассчитать вероятность \(P(\chi^2 > 5.889)\) мы можем только потому, что знаем распределение (хи-квадрат)
Визуально, мы спрашиваем, какова площадь под кривой.
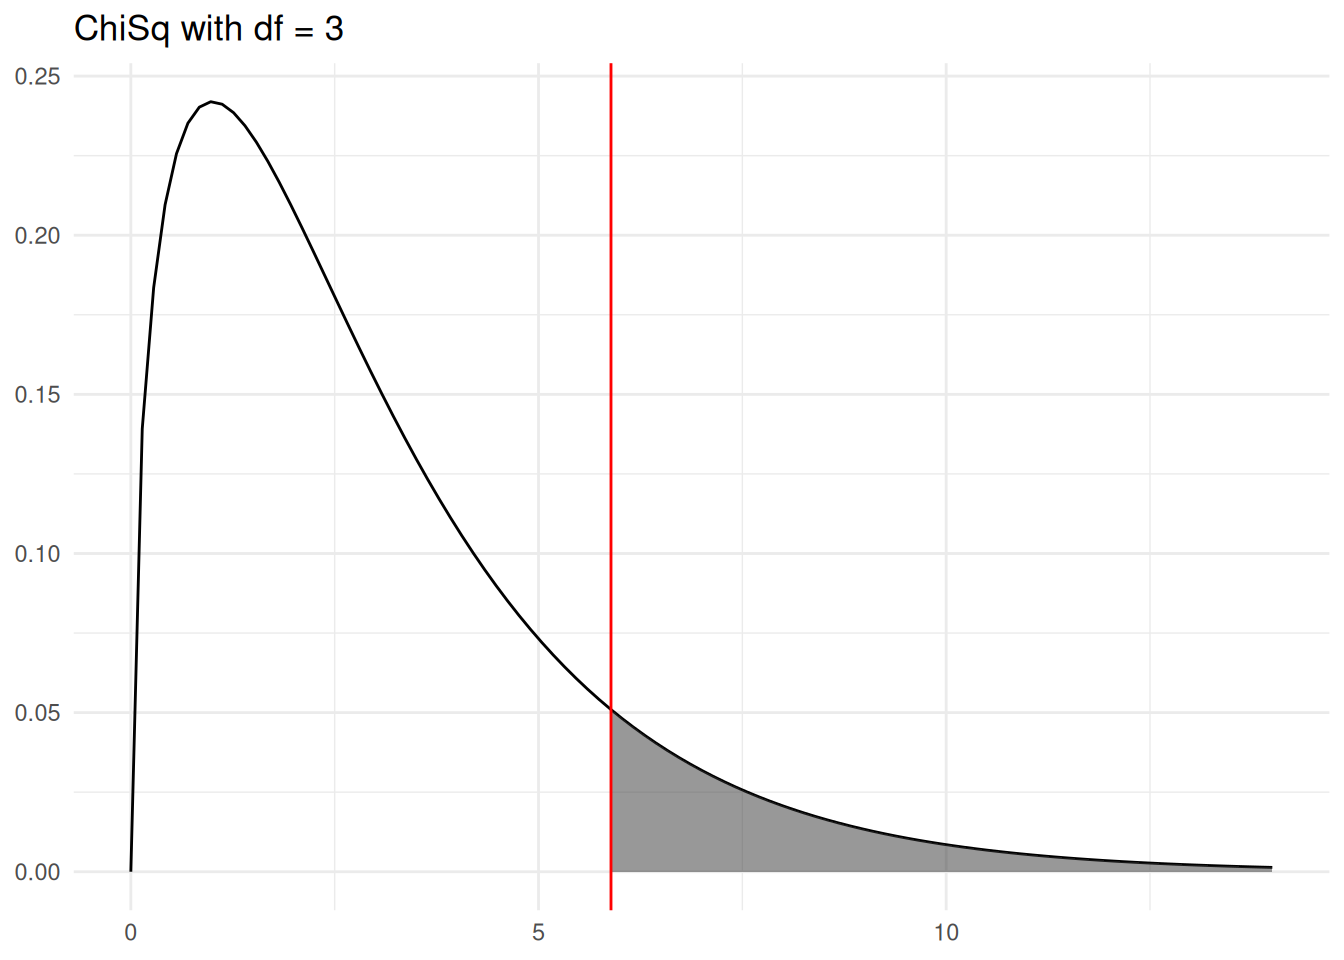
Но в R есть готовые функции
pchisq(5.889, df = 3, lower.tail = FALSE)[1] 0.1171373Аргумент lower.tail = FALSE говорит R, какую вероятность считать: по умолчанию (TRUE) функция вернула бы вероятность того, что переменная меньше заданного значения, а нам нужна верхняя часть распределения — вероятность быть больше.
Как видно, решать задачу вручную не обязательно, тест реализован внутри R. Но, чтобы уметь правильно интерпретировать результаты, нужно понимать, что происходит “под капотом”. В коде ниже я использую готовую функцию chisq.test(), которая принимает на вход два аргумента, наблюдаемые значения и предполагаемые пропорции. По сути, я спрашиваю, какова вероятность что “наблюдаемые значения” пришли из популяции с заданной структурой (пропорциями).
obs <- c(205, 26, 25, 19)
probs <- c(0.72, 0.07, 0.12, 0.09)
chisq.test(x = obs, p = probs)
    Chi-squared test for given probabilities

data:  obs
X-squared = 5.8896, df = 3, p-value = 0.1171
Мы видим, что \(P(Data|Null Hypothesis) = 0.1171\) — слишком высока, чтобы отвергать нулевую гипотезу, и делаем вывод, что имеющиеся данные НЕ дают убедительного свидетельства против нулевой гипотезы.
Заметкаp-значение и уровень значимости
Не путайте две вещи. Уровень значимости (significance level) — это пороговое, критическое значение вероятности, после которого мы начинаем отвергать нулевую гипотезу; мы фиксируем его для себя заранее (конвенционально 0.05 или 0.01). А p-значение — это вероятность наблюдать данные как у нас при условии, что нулевая гипотеза верна; оно зависит от выборки и само по себе является случайной величиной. Мы сравниваем p-значение с уровнем значимости. Доверительный уровень и уровень значимости — две стороны одной монеты: доверительный уровень равен единице минус уровень значимости.
И еще одна техническая тонкость в формулировках: мы никогда не “принимаем” нулевую гипотезу. Поскольку она является статус-кво, мы говорим, что не смогли ее отвергнуть — остаемся на ней, потому что нет лучшей альтернативы. Пока не доказано обратное, мы считаем, что выборка случайна.
t-распределение
Теперь поговорим про t-распределение (оно же — распределение Стьюдента1) — еще одну вещь, которая часто будет всплывать в практических приложениях. Выводить его я не буду, это требует достаточно изощренной математики, но объясню идею.
Благодаря ЦПТ мы знаем, что выборочное среднее \(\bar{X}\) имеет нормальное распределение с центром в популяционном среднем \(\mu\):
\[\bar{X} \sim N\left(\mu,\ SE = \frac{\sigma}{\sqrt{n}}\right)\]
Здесь \(\sigma\) — стандартное отклонение «родительской» переменной в популяции. Проблема в том, что \(\sigma\) мы не знаем — все, что у нас есть, это выборка и посчитанное на ней выборочное стандартное отклонение \(s\). Поэтому во всех формулах предыдущей главы мы молча подменяли одно другим:
\[ \textrm{CI: } \bar{x} \pm z^{*}\times \frac{\sigma}{\sqrt{n}} \approx \overline{x} \pm z^{*}\times \frac{s}{\sqrt{n}} \]
\[ \textrm{Проверка гипотез: } z = \frac{\bar{x} - x_0}{SE}, \quad SE = \frac{\sigma}{\sqrt{n}} \approx \frac{s}{\sqrt{n}} \]
Насколько эта подмена «законна»? Задумайтесь о статусе этих двух величин:
- \(\sigma\) - это просто неизвестное число, ключевое слово число: оно фиксировано, просто нам недоступно
- С другой стороны, наша оценка \(s\) - это случайная переменная: возьмем новую выборку — получим новое значение \(s\)
Например: у нас популяция в 100 человек, выбираем 10 случайных и считаем стандартное отклонение роста. Оно не совпадет с популяционным. Возьмем другую десятку — получим третье число, и так далее: \(s\) «болтается» вокруг \(\sigma\) так же, как выборочное среднее болтается вокруг популяционного.
Другими словами, подменяя \(\sigma\) на \(s\), мы шли на уловку, которую формально не обосновали. В нашей тестовой статистике на самом деле два источника неопределенности: один связан с оценкой популяционного среднего (числитель), второй — с оценкой популяционного стандартного отклонения (знаменатель). Математики показали, что взаимодействие этих двух источников можно аккуратно посчитать. Если ввести поправку, окажется, что стандартизованное выборочное среднее распределено не совсем нормально: форма похожа на нормальную, распределение тоже симметрично, но хвосты у него толще — оно более «размазано». А толстые хвосты означают, что у переменной больше вероятность уйти подальше от своего центра: экстремальные значения более вероятны.
Для любопытных — откуда это берется формально. Стартуем с привычной статистики, где в знаменателе стоит \(s\):
\[ t = \frac{\bar{x} - x_0}{s / \sqrt{n}} \]
Ее можно алгебраически переписать как отношение двух знакомых нам объектов:
\[ t = \frac{\bar{x}-x_0}{\sigma/\sqrt{n}}\bigg/\sqrt{\frac{s^2(n-1)}{\sigma^2(n-1)}} = \frac{Z}{\sqrt{\chi^2_{n-1}/(n-1)}} \]
В числителе — стандартная нормальная переменная \(Z\) (это ЦПТ). А в знаменателе прячется хи-квадрат из начала главы: можно показать, что величина \((n-1)s^2/\sigma^2\) имеет распределение \(\chi^2_{n-1}\) — выборочная дисперсия это ведь тоже сумма квадратов. Отношение этих двух конструкций и называется t-распределением:
\[ t \sim T(n-1) \]
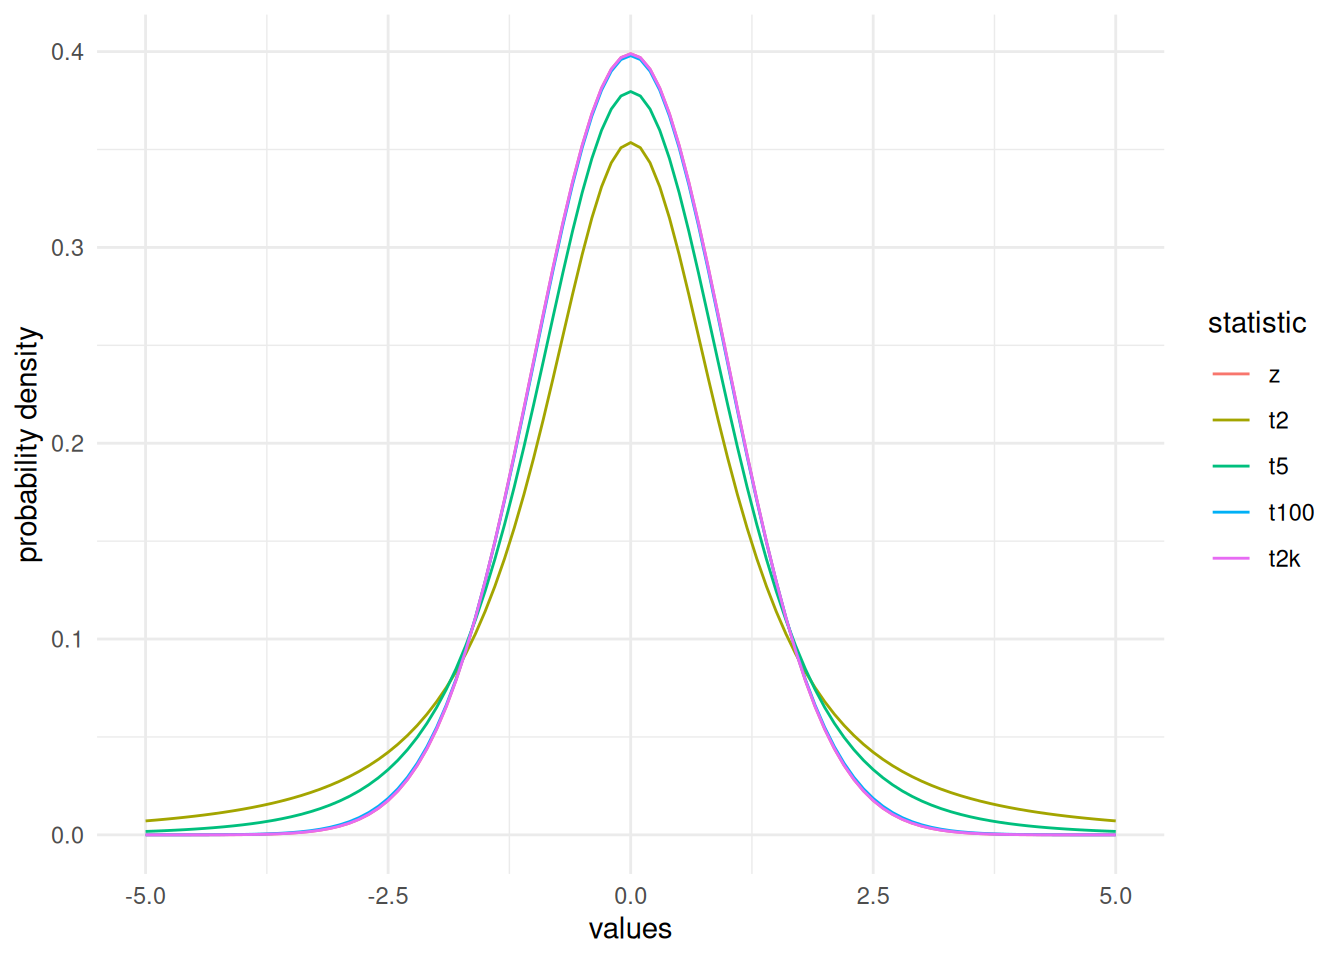
- t-распределение учитывает неопределенность, связанную с оценкой дисперсии
- t-распределение очень похоже на нормальное с центром в 0, однако его дисперсия немного больше
- t-распределение имеет всего 1 параметр: число степеней свободы (df)
- \(df = n - 1\), число наблюдений в выборке минус один
- По мере роста выборки t-распределение становится неотличимым от нормального: \(n \rightarrow \infty, \ T \rightarrow N(0, 1)\)
На графике выше t-распределение с 2000 степенями свободы настолько неотличимо от нормального, что нормального практически не видно. Концептуально степень свободы t-распределения — это, грубо говоря, размер вашей выборки: если у вас маленькая выборка, у вас больше неопределенности, и среднее этой выборки может достаточно далеко уйти от настоящего популяционного среднего. Представьте, что вы оцениваете средний вес мужчины в Казахстане по выборке из трех человек: и среднее, и стандартное отклонение, посчитанные на такой выборке, могут очень далеко уйти от популяционных значений — толстые хвосты t-распределения с двумя степенями свободы именно это и отражают. Чем больше выборка, тем меньше у выборочного среднего возможности уйти далеко от истинного, тем тоньше хвосты. И уже для выборок больше 1000 наблюдений практически никакой разницы нет, используете вы нормальное распределение или t-распределение: t-распределение на практике важно для малых выборок.
Как использовать
Все абсолютно аналогично z-значениям: считаем тестовую статистику, а потом вероятности. Просто в тех местах, где раньше вы брали квантили нормального распределения, вы берете квантили t-распределения с заданным числом степеней свободы. И, как обычно, все это давно реализовано внутри статистического софта — не нужно лезть в справочники.
Тестовая статистика: \(T = \frac{obs - null}{SE}\)
p-значение: \(P(T > t), P(T < t)\)
Единственная разница, t-распределение имеет более толстые хвосты чем стандартное нормальное
Это значит, что вероятность “экстремальных” событий в нем выше
Например, \(P(T > 2.5) > P(Z > 2.5)\)
Таблица ниже приводит вероятность быть на 2.5 стандартных отклонения больше среднего для разных распределений.
tibble(normal = pnorm(2.5, lower.tail = FALSE),
       t_2 = pt(2.5, df = 2, lower.tail = FALSE),
       t_5 = pt(2.5, df = 5, lower.tail = FALSE),
       t_100 = pt(2.5, df = 100, lower.tail = FALSE),
t_2k = pt(2.5, df = 2000, lower.tail = FALSE))| normal | t_2 | t_5 | t_100 | t_2k |
|---|---|---|---|---|
| 0.0062097 | 0.0648059 | 0.027245 | 0.0070229 | 0.0062494 |
Подумайте об этих числах. Для нормальной переменной уйти на 2.5 стандартных отклонения от центра — что-то из ряда вон выходящее (вероятность 0.6%). А для t-распределения с двумя степенями свободы это вполне вероятный исход — 6%, в десять раз больше. И это опять про размер выборки: у выборки из двух человек среднее может уйти очень далеко от истинного центра.
- Иными словами, p-значения для t-распределения будут всегда больше чем для нормального.
- Поскольку, нулевая гипотеза отвергается, когда p-значение МЕНЬШЕ определенного уровня достоверности, t-распределение более консервативно!
- Т.е. оно будет чаще оставаться при нулевой гипотезе
- Концептуально, t-распределение учитывает больше неопределенности
ЗаметкаОткуда мы знаем, по какому закону распределена статистика?
Частый вопрос: как вообще понять, какое распределение использовать? Ответ: математики вам сказали. Про очень широкий класс статистик, которые считаются на случайных выборках, доказано, по какому закону они распределены: выборочное среднее — асимптотически нормально, на малых выборках — t с \(n-1\) степенями свободы, статистики из сумм квадратов — хи-квадрат. Важно понимать: математика ничего не говорит про объекты в мире (какое распределение имеет индекс массы тела мужчин в Казахстане — этого никто не «доказывал»). Она говорит про процедуры: если вы возьмете случайную выборку и посчитаете на ней такую-то статистику, то про эту статистику точно известно, какую форму она будет иметь. Благодаря этому вы можете делать вывод об истинной популяции. Ключевая вещь во всей этой магии — понимать, по какому закону распределена ваша тестовая статистика; все остальное — прямолинейное приложение общего принципа: считаем статистику, считаем p-значение, сравниваем с уровнем значимости.
Статистический вывод для выборочного среднего
Разберем на примере, как это работает. Возьмем данные PISA для Казахстана и пойдем на педагогическую хитрость: притворимся, что все ~15 тысяч наблюдений за 2017 год — это наша популяция. Тогда мы можем посчитать «истинное» популяционное среднее и популяционное стандартное отклонение балла по математике. А затем возьмем из этой популяции случайную выборку из 50 школьников и посчитаем на ней выборочные среднее и стандартное отклонение.
| pop_mean | pop_sd | sample_mean | samp_sd |
|---|---|---|---|
| 439.9113 | 93.34192 | 427.9351 | 95.86034 |
Мы видим, что выборочное среднее и выборочное стандартное отклонение не равны истинным значениям — но они имеют распределения, центрированные на этих значениях. Если бы я повторил случайный эксперимент, выборочное среднее могло бы оказаться чуть больше, а стандартное отклонение чуть меньше; повторяя много раз, мы бы увидели, как оценки «балансируют» вокруг истинных значений.
Доверительный интервал
Теперь, допустим, я хочу построить доверительный интервал на основе этой выборки — так, чтобы он был чувствителен к неопределенности малой выборки. Все работает примерно так же, как и раньше, просто вместо квантилей нормального распределения я беру квантили t-распределения, которые будут чуть дальше от центра.
\[ \bar{x} \pm t^{*}_{df}SE_{\bar{x}}\\ \bar{x} \pm t^{*}_{df}\frac{s}{\sqrt{n}} \\ df = N-1\\ \bar{x} \pm t^{*}_{49}\frac{95.86}{\sqrt{50}} \\ \]
Критическое значение \(t^{*}\) отвечает на вопрос: насколько нужно отойти от центра t-распределения с 49 степенями свободы, чтобы отрезать по 2.5% с каждой стороны (и оставить 95% в середине)?
qt(0.025, df = 49)[1] -2.009575Обратите внимание: это значение чуть больше, чем аналогичное для нормального распределения (1.96 против 2.01). Практически это означает чуть более широкий доверительный интервал. Если бы мы не учитывали, что выборка маленькая, и использовали только центральную предельную теорему, критические значения — а значит и погрешность — были бы меньше. Казалось бы, хорошо, но эта маленькая погрешность не отражала бы истинную неопределенность, связанную с маленькой выборкой. t-распределение позволяет отнестись к этой неопределенности с большим уважением.
\[ 427.94 \pm 2.01\times\frac{95.86}{\sqrt{50}} = (400.69, 455.19) \]
- Мы на \(95\%\) уверены, что казахстанские школьники набрали в пределах от \(400.69\) до \(455.19\) баллов по математическому тесту PISA
Ну и поскольку в этом упражнении мы, в виде исключения, знаем истинное популяционное среднее, можно убедиться: интервал его действительно поймал.
Проверка гипотез
С проверкой гипотез все так же: единственное отличие — вероятность тестовой статистики считаем не из нормального распределения, а из t-распределения. Допустим, я где-то узнал, что среднее по математике для стран ОЭСР равно 458, и хочу сравнить Казахстан со странами ОЭСР. Нулевая гипотеза: Казахстан не отличается, то есть наше выборочное среднее пришло из распределения с центром 458. Альтернативная: отличается (в любую сторону — мы можем быть как лучше, так и хуже).
- \(\bar{x} = 427.94; s = 95.86; N = 50; SE = 13.6\)
- Допустим мы знаем среднее для стран ОЭСР \(\mu = 458\)
- \(H_{0}: \mu_{KZ} = 458\)
- \(H_{A}: \mu_{KZ} \neq 458\)
- \(T = \frac{427.94 - 458}{13.6} = -2.2794\)
[1] 0.0270355- p-value = 0.0270355 \(\rightarrow\) отвергаем \(H_{0}\)
Вероятность наблюдать такое среднее, как у нас, при условии, что казахстанские школьники знают математику так же, как школьники ОЭСР в среднем, — около 2.7%. Это меньше конвенционального уровня значимости 5%, соответственно, мы отвергаем нулевую гипотезу.
ЗаметкаПро выбор уровня значимости
В пятипроцентном уровне значимости нет ничего священного: ничто не делает его лучше, чем 4.9% или 5.1%, — просто исторически так сложилось. Если бы мы зафиксировали уровень 1%, мы бы в примере выше нулевую гипотезу не отвергли. Современная практика советует не зацикливаться на конкретных порогах, а просто сообщать p-значение — пусть читатель сам решает, убеждает оно его или нет. Выбор порога зависит от предметной области. Представьте, что вы тестируете самолет перед полетом: нулевая гипотеза — «самолет готов к полету». Поскольку приоритет у безопасности, вы будете сенситивны к малейшим свидетельствам против — и отвергнете нулевую гипотезу даже при полупроценте.
Сравнение двух средних
Другой пример, тоже из PISA. В Казахстане тест проходит на двух языках: школьник может выбирать, сдавать его на казахском или на русском. Эти данные есть в открытом доступе, и можно посчитать средние баллы по математике для двух групп: примерно 424 балла у сдававших на казахском и 462 — у сдававших на русском.
| test_lang | mean_math | sd | n |
|---|---|---|---|
| kz | 424.7240 | 88.22351 | 11695 |
| ru | 462.6476 | 96.13942 | 7812 |
Мы видим разницу между группами, и, естественно, возникает вопрос: насколько эта разница значима? Можем ли мы сказать, что между группами существует статистически значимая разница, или это просто случайность — выборка случайна, и так вышло? Глядя на стандартные отклонения, может даже показаться, что разница невелика: средние групп находятся в пределах одного стандартного отклонения друг от друга. Давайте ответим на вопрос формально.
Доверительный интервал для разницы средних
Введем новую случайную переменную: разницу между двумя групповыми средними. Если бы мы повторяли процесс выборки много раз, эта переменная принимала бы разные значения, то есть имела бы какое-то распределение, — и мы хотим понять, в каких пределах находится истинный центр этой разницы. Берем две точечные оценки, вычитаем одну из другой, и остается посчитать погрешность. Стандартная ошибка разницы складывается из дисперсий обеих групп: группы независимы, а когда мы складываем (или вычитаем — это то же сложение, со знаком минус) два независимых источника неопределенности, итоговая дисперсия равна сумме дисперсий.
Отдельный технический нюанс — какое число степеней свободы использовать для t-квантиля: групп две, и наблюдений в них разное количество. Есть простое консервативное правило большого пальца: берем меньшую из двух степеней свободы. Квантиль для распределения с меньшей степенью свободы больше, соответственно, интервал шире, и мы с большей вероятностью поймаем им истинное значение.
\[ (\bar{x}_1 - \bar{x}_2) \pm t^{*}SE_{(\bar{x}_1 - \bar{x}_2)} \\ SE_{(\bar{x}_1 - \bar{x}_2)} = \sqrt{\frac{s_1^2}{n_1} + \frac{s_2^2}{n_2}} \\ df = min(n_1 - 1, n_2 - 1) \]
Считаем в R:
obs <- 462.648 - 424.724
null <- 0
n1 <- 11695
n2 <-  7812
s1 <- 88.224
s2 <- 96.139
Допустим мы хотим построить \(95\%\) доверительный интервал. Мы берем наблюдаемую разницу 37.924 и добавляем погрешность \(t^{*}SE_{(\bar{x}_1 - \bar{x}_2)}\)
Сначала погрешность \(SE_{(\bar{x}_1 - \bar{x}_2)} = \sqrt{\frac{s_1^2}{n_1} + \frac{s_2^2}{n_2}}\)
se <- sqrt(s1^2/n1 + s2^2/n2)
se
[1] 1.359662Выбираем \(t^{*}\)-значение соответствующее \(95\%\) доверительному уровню. Нам нужно указать число степеней свободы.
df <- min(n1 - 1, n2 - 1); df[1] 7811t_star <- qt(0.975, df = df); t_star[1] 1.960268# just for comparison, we were working with Normal distribution, instead of t
z_star <- qnorm(0.975, 0, 1); z_star[1] 1.959964Практически то же самое: степень свободы здесь очень большая, поэтому квантиль почти совпадает с нормальным.
Теперь посчитаем интервал
(obs - null) + c(-t_star*se, t_star*se)[1] 35.2587 40.5893Интерпретация: мы на \(95\%\) уверены, что настоящая разница между сдававшими тест на казахском и русском языках находится в пределах 35.259, 40.589. С формулировками можно играть: например, мы на 95% уверены, что сдававшие тест на русском набрали как минимум на ~35 баллов больше, чем сдававшие на казахском. Это, к слову, о неравенстве в школьном образовании в Казахстане.
Проверка гипотезы о разнице средних
Если я хочу проверить гипотезу — логика очень похожая. Нулевая гипотеза: разница между русской и казахской группами нулевая, то есть истинный центр распределения разницы равен нулю. Альтернативная: разница не равна нулю.
\[ H_{0}: \mu_{RU} - \mu_{KZ} = 0 \\ H_{A}: \mu_{RU} - \mu_{KZ} \neq 0 \\ T_{7811} = \frac{obs- null}{SE} \]
Теперь посчитаем, какое значение приняла t-статистика: \(T_{7811} = \frac{obs- null}{SE}\)
t_statistic <- -(obs - null)/se
t_statistic
[1] -27.89223И наконец считаем \(p\_значение = P(T < -27.89|\mu_1 - \mu_2 = 0)\)
2*pt(t_statistic, df = df, lower.tail = TRUE)[1] 2.7173e-163# once again
2*pnorm(t_statistic, 0, 1, lower.tail = TRUE)[1] 3.315196e-171Мы посчитали вероятность наблюдать разницу в средних настолько же большую как 37.924 при условии, что между группами нет разницы
Эта вероятность крайне мала (обратите внимание: и для t, и для нормального распределения она фактически равна нулю), так что мы отвергаем \(H_{0}\) , и утверждаем, что данные свидетельствуют о том, что между школьниками сдававшими тест на русском и на казахском есть значимая разница
То же самое в R
Все, что мы проделали «на ручном управлении», в R умещается в одну строчку: функция t.test() проводит сравнение двух групп с использованием t-распределения. Синтаксис простой: указываете датафрейм, а затем через тильду — числовую переменную и группировочную переменную, по которой ее надо разбить на две группы.
t.test(data = pisa, PV1MATH ~ test_lang)
    Welch Two Sample t-test

data:  PV1MATH by test_lang
t = -27.892, df = 15743, p-value < 2.2e-16
alternative hypothesis: true difference in means between group kz and group ru is not equal to 0
95 percent confidence interval:
 -40.58871 -35.25852
sample estimates:
mean in group kz mean in group ru
        424.7240         462.6476
В выводе нужно научиться смотреть на нужные детали: значение тестовой статистики (та же разница между группами, деленная на стандартную ошибку), число степеней свободы, p-значение — оно настолько маленькое, что R даже не считает его точно, а просто сообщает, что оно меньше \(2.2\times10^{-16}\), то есть эффективно ноль. На всякий случай указана альтернативная гипотеза (истинная разница не равна 0 — двусторонняя), посчитан 95% доверительный интервал и приведены средние обеих групп.
ANOVA: сравнение нескольких средних
t-тест сравнивает средние двух групп. А что делать, если групп больше? Для этого существует метод под названием ANOVA (Analysis of Variance, дисперсионный анализ).
Продолжим работать с PISA. Возьмем переменную books — ответ школьника на вопрос «сколько книг у вас дома» (шесть упорядоченных категорий) — и посмотрим, как с ней связаны результаты тестов.
| books | n |
|---|---|
| 1 | 4800 |
| 2 | 6422 |
| 3 | 5419 |
| 4 | 1543 |
| 5 | 765 |
| 6 | 445 |
Категории закодированы числами, поэтому расшифруем (по кодбуку PISA): 1 — дома 0–10 книг, 2 — 11–25 книг, 3 — 26–100 книг, 4 — 101–200 книг, 5 — 201–500 книг, 6 — более 500 книг.
Разобьем на группы по языку теста:
| books | language | n |
|---|---|---|
| 1 | kz | 2958 |
| 1 | ru | 1842 |
| 2 | kz | 4289 |
| 2 | ru | 2133 |
| 3 | kz | 3126 |
| 3 | ru | 2293 |
| 4 | kz | 729 |
| 4 | ru | 814 |
| 5 | kz | 330 |
| 5 | ru | 435 |
| 6 | kz | 199 |
| 6 | ru | 246 |
Более детально — доли категорий внутри языковых групп:
`summarise()` has grouped output by 'language'. You can override using the
`.groups` argument.| language | books | n | freq |
|---|---|---|---|
| kz | 1 | 2958 | 0.2543204 |
| kz | 2 | 4289 | 0.3687559 |
| kz | 3 | 3126 | 0.2687645 |
| kz | 4 | 729 | 0.0626773 |
| kz | 5 | 330 | 0.0283725 |
| kz | 6 | 199 | 0.0171094 |
| ru | 1 | 1842 | 0.2372794 |
| ru | 2 | 2133 | 0.2747649 |
| ru | 3 | 2293 | 0.2953755 |
| ru | 4 | 814 | 0.1048564 |
| ru | 5 | 435 | 0.0560350 |
| ru | 6 | 246 | 0.0316888 |
И визуализация:
`summarise()` has grouped output by 'language'. You can override using the
`.groups` argument.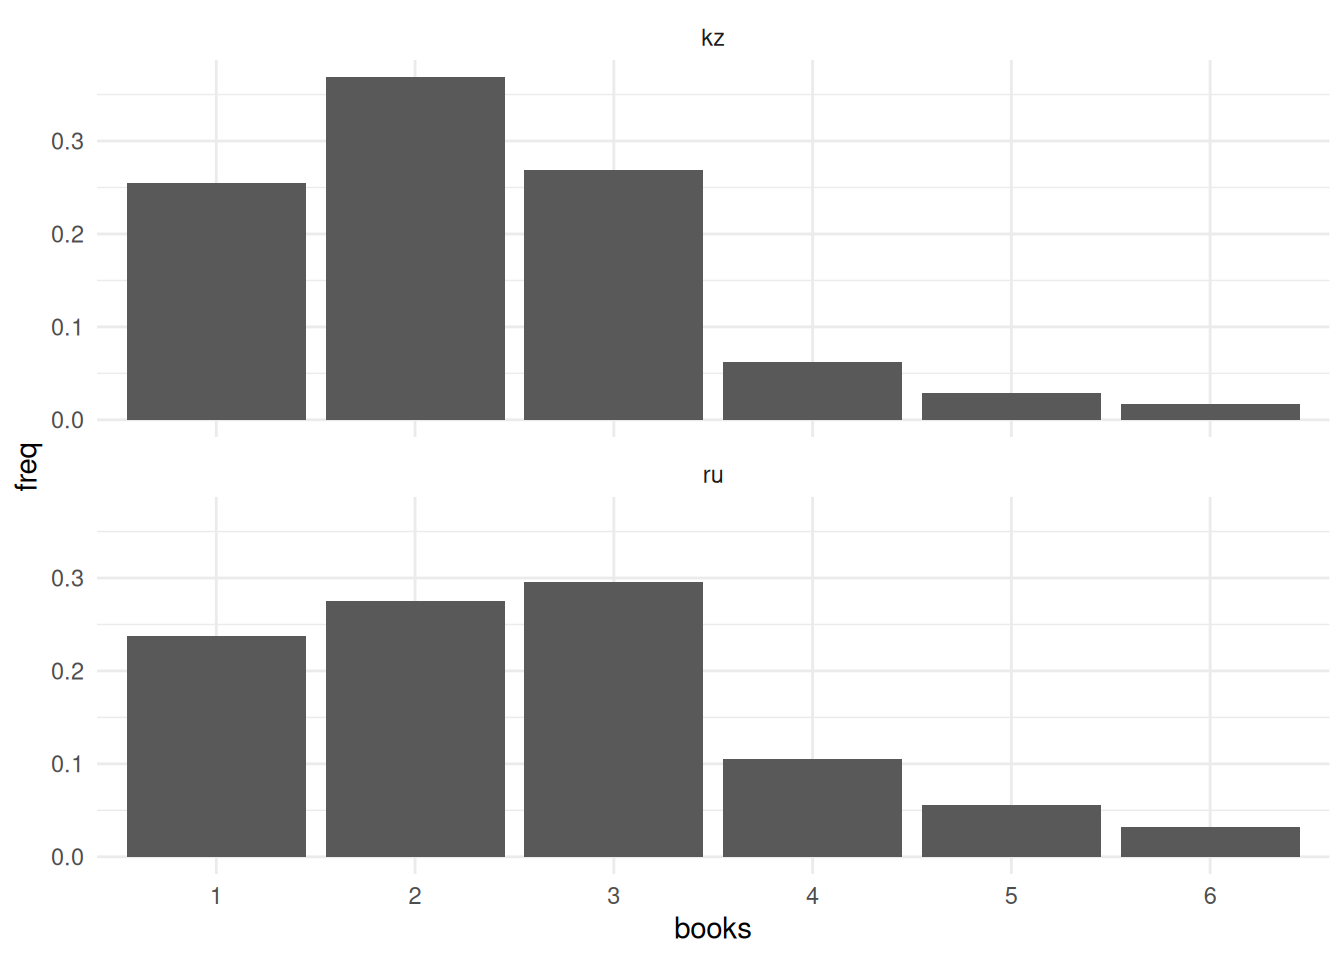
Теперь посмотрим на средние баллы по группам «количества книг»:
| books | mean_math | mean_read | mean_science |
|---|---|---|---|
| 1 | 413.5992 | 378.2611 | 387.6304 |
| 2 | 429.3879 | 390.0052 | 401.8916 |
| 3 | 457.5751 | 424.3131 | 431.6888 |
| 4 | 479.2907 | 446.1560 | 452.1985 |
| 5 | 486.5684 | 460.7293 | 465.7219 |
| 6 | 454.9921 | 427.4767 | 435.2830 |
Визуально — боксплоты баллов по математике для каждой категории:
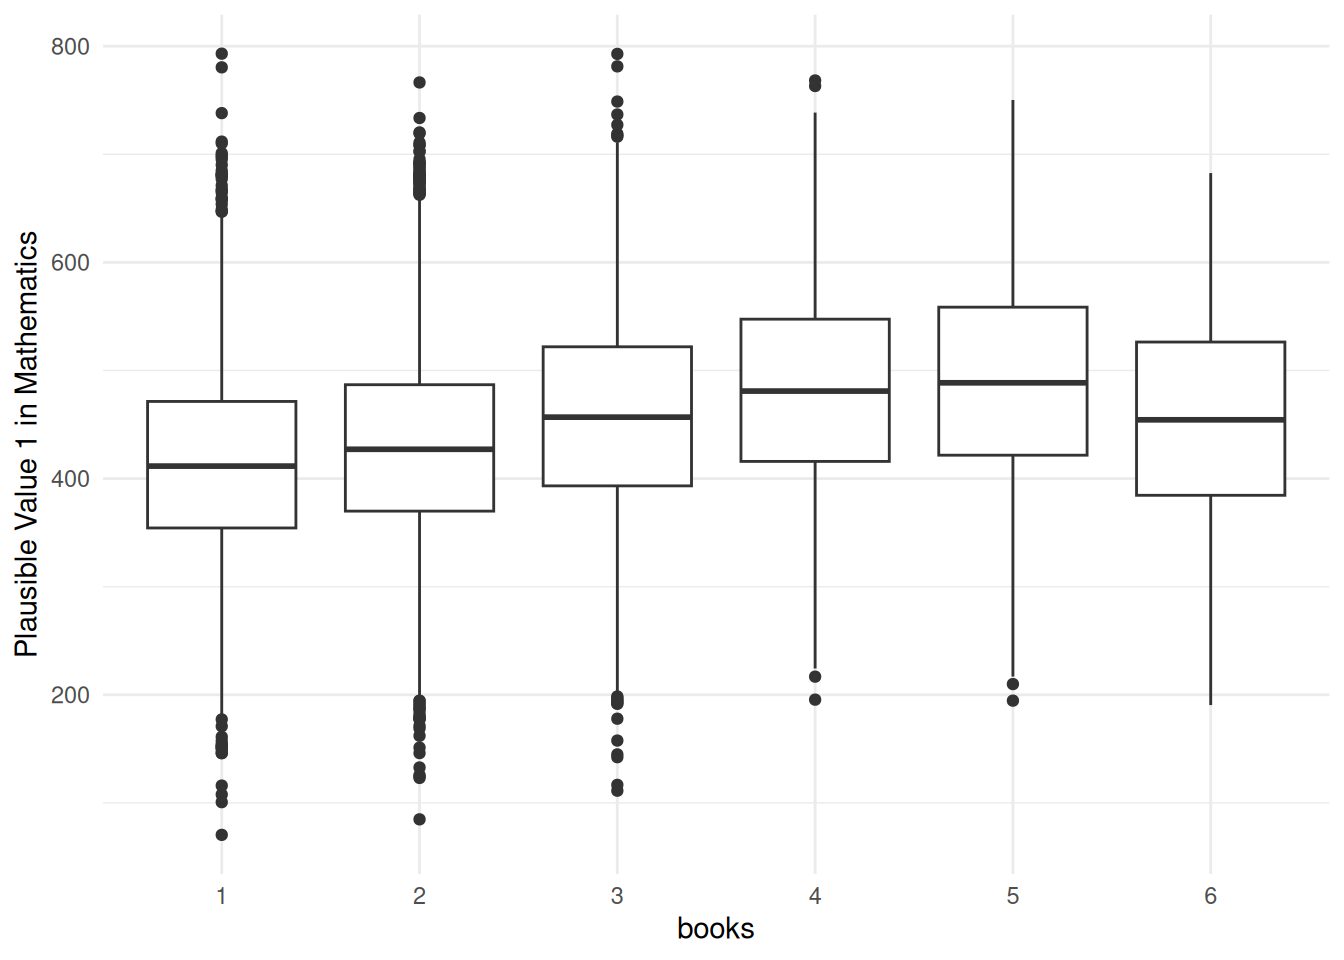
Картина довольно выразительная: средние баллы монотонно растут с количеством книг дома — и по математике, и по чтению, и по науке. Само по себе число книг вряд ли делает школьника умнее; скорее, домашняя библиотека — это прокси культурного и социально-экономического капитала семьи, с которым результаты тестов устойчиво связаны. Но боксплоты также показывают, что группы сильно перекрываются: внутри каждой категории разброс огромный. Отсюда наш вопрос: являются ли различия между шестью группами статистически значимыми, или наблюдаемые разницы средних можно списать на случайность выборки? Групп шесть, попарных сравнений t-тестом пришлось бы делать пятнадцать — нужен один тест сразу на все группы.
Идея ANOVA
Где, как вы думаете, разница между группами наиболее очевидна?
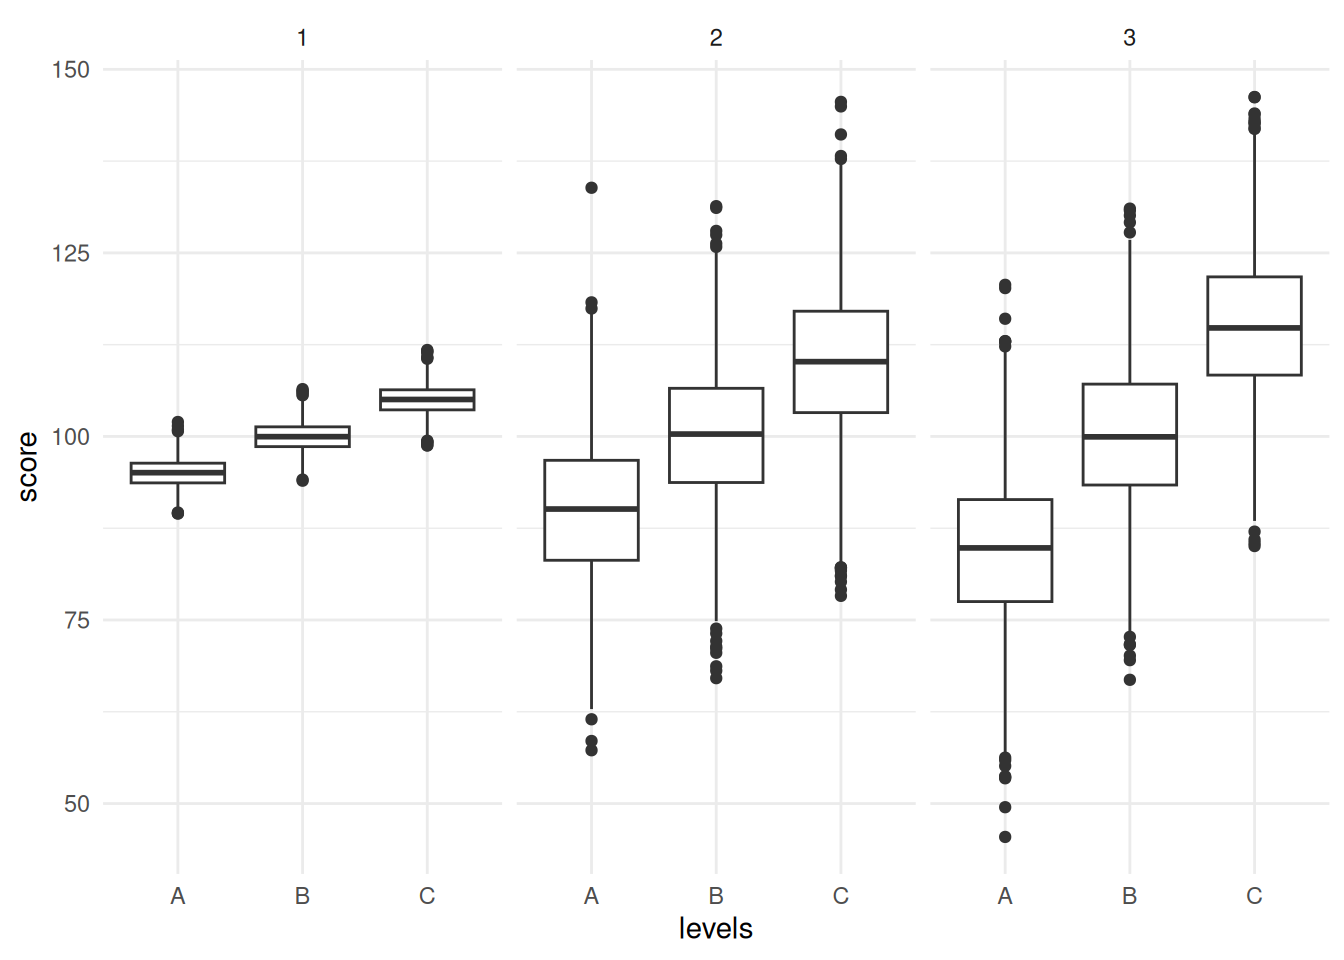
Разберем этот график, потому что в нем вся интуиция метода. На первой панели групповые средние различаются на 5 единиц, но разброс внутри групп крошечный — ящики компактные и не пересекаются, разница очевидна на глаз. На второй панели средние различаются на 10 единиц — вдвое больше! — но внутригрупповой разброс так велик, что ящики сильно перекрываются, и различия тонут в шуме. На третьей панели разброс такой же большой, как на второй, но межгрупповые различия еще шире — и снова «пробивают» шум.
Вывод: важна не сама по себе разница между средними, а ее соотношение с разбросом внутри групп. Именно это соотношение и измеряет ANOVA.
Формально ANOVA проверяет следующие гипотезы:
- \(H_{0}: \mu_1 = \mu_2 = \dots = \mu_k\)
- где \(\mu_i\) среднее для группы \(i\)
- \(H_{A}:\) Хотя бы одна пара средних различается: \(\exists i,j: \mu_{i} \neq \mu_{j}\)
- F-статистика: \(F = \frac{\textrm{межгрупповая дисперсия}}{\textrm{внутригрупповая дисперсия}}\)
- Чем больше статистика \(\implies\) меньше p-значение
Разложение дисперсии
Ключевая идея: общую дисперсию можно разложить на две части.
- \(\textrm{Общая Дисперсия} = \textrm{Межгрупповая Дисперсия} + \textrm{Внутригрупповая дисперсия}\)
\[ Total = SST =\sum_{i=1}^{n}(x_i - \bar{x})^2\\ btw\_Group = SSG = \sum_{i = 1}^{k}{n_i (\bar{x_i} - \bar{x})^2} \\ within\_Group = SSE =\sum_{i = 1}^{k}(n_i - 1)s^{2}_{i} \\ Total = btw\_Group + within\_Group \\ SST = SSG + SSE \]
Небольшой игрушечный пример, чтобы прочувствовать разложение:
- Допустим у нас есть числа \(\{3, 3, 5, 5\}\), их общее среднее равно 4
- Общая дисперсия: \((3-4)^2 + (3-4)^2 + (5-4)^2 + (5-4)^2 = 4\)
- Разделим числа на две группы: \(\{3, 3\} \text{ и } \{5,5\}\)
- Межгрупповая дисперсия равна сумме квадратов отклонений между общим средним и групповыми средними, взвешенными пропорционально размеру группы: \(SSG = 2\times(3 - 4)^2 + 2\times(5-4)^2 = 4\)
- При этом внутригрупповая дисперсия равна 0, \(s_i = 0\)
- Теперь предположим мы разобьем группы иначе: \(\{3, 5\}\) и \(\{3, 5\}\)
- Тогда все станет наоборот: \(SSG = 0\) и \(SSE = 4\)
Первое разбиение «объясняет» всю дисперсию (внутри групп разброса нет, вся разница — между группами), второе не объясняет ничего. Реальные разбиения находятся где-то между этими крайностями.
Теперь перейдем от сумм квадратов к средним квадратам: нормализуем каждую сумму на соответствующее число степеней свободы.
\[ MSG = \frac{SSG}{df_{G}} \\ MSE = \frac{SSE}{df_{E}} \\ df_{G} = k - 1 \\ df_{E} = n - k \\ df_{total} = n - 1 \\ F = \frac{MSG}{MSE} \]
Здесь \(k\) — число групп, \(n\) — общее число наблюдений. Обратите внимание, что степени свободы согласованы: \(df_G + df_E = df_{total}\), как и суммы квадратов.
И вот обещанное третье распределение главы. Посмотрите на устройство F-статистики: и числитель, и знаменатель — это суммы квадратов, нормированные на свои степени свободы. А мы уже знаем, что суммы квадратов (при верной нулевой гипотезе) имеют распределение хи-квадрат. Отношение двух хи-квадратов, каждый из которых поделен на свои степени свободы, называется F-распределением (в честь Рональда Фишера, отца дисперсионного анализа). У него два параметра — \(df_1 = k-1\) и \(df_2 = n-k\), и, как обычно, оно давно реализовано в R. Знакомая схема полностью повторяется: знаем распределение статистики при нулевой гипотезе — можем посчитать p-значение.
От F-статистики к p-значениям
- p-значение\(= P(F > f|H_{0})\), чем больше F-статистика \(\implies\) тем ниже p-значение
- Большие p-значения значат, что внутригрупповая дисперсия велика, а межгрупповая вариация мала \(\implies\) много разнообразия внутри групп, мало разницы между группами \(\implies\) неинформативное разбиение
- Малые p-значения значат, что внутригрупповая дисперсия мала, а межгрупповая дисперсия велика \(\implies\) группы однородны, но не похожи друг на друга \(\implies\) информативное разбиение
Быстрая иллюстрация с функцией pf() (это F-аналог знакомых pnorm() и pchisq()): чем больше значение F-статистики, тем меньше вероятность в правом хвосте, то есть p-значение.
pf(5, df1 = 1, df2 = 2, lower.tail = FALSE)[1] 0.1548457pf(10, df1 = 1, df2 = 2, lower.tail = FALSE)[1] 0.08712907pf(1000, df1 = 1, df2 = 2, lower.tail = FALSE)[1] 0.0009985025Примеры
Вернемся к нашему вопросу про книги и баллы. Функция aov() посчитает ANOVA для вас:
fit_books <- aov(math ~ books, data = new_pisa)
summary(fit_books)
Df Sum Sq Mean Sq F value Pr(>F)
books 5 9883157 1976631 241.2 <2e-16 ***
Residuals 19388 158901925 8196
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1Таблица выше — это ровно то разложение, которое мы обсуждали: строка books — межгрупповая часть (ее Df равно \(k - 1 = 5\)), строка Residuals — внутригрупповая. Можно проверить расчет вручную: восстановим средние квадраты, F-статистику и p-значение прямо из сумм квадратов.
anova_tbl <- summary(fit_books)[[1]]
MSG <- anova_tbl[1, "Sum Sq"] / anova_tbl[1, "Df"]
MSE <- anova_tbl[2, "Sum Sq"] / anova_tbl[2, "Df"]
F_stat <- MSG / MSE
c(MSG = MSG, MSE = MSE, F = F_stat)
MSG MSE F
1976631.4095 8195.8905 241.1735 pf(F_stat, df1 = anova_tbl[1, "Df"], df2 = anova_tbl[2, "Df"],
lower.tail = FALSE)[1] 9.512979e-251Вывод: F-статистика огромна, p-значение исчезающе мало — данные дают убедительные свидетельства против нулевой гипотезы о равенстве средних. Между группами по количеству книг дома есть значимые различия в баллах по математике. Заметьте, что ANOVA отвечает только на вопрос «есть ли хоть какая-то разница»; она не говорит, какие именно группы различаются — для этого существуют пост-хок тесты, которые мы оставим за пределами учебника.
Когда групп всего две, ANOVA соответствует t-тесту (а F-статистика равна квадрату t-статистики):
fit_lang <-
  aov(math ~ language, data = new_pisa)
summary(fit_lang)
Df Sum Sq Mean Sq F value Pr(>F)
language 1 6725784 6725784 804.8 <2e-16 ***
Residuals 19392 162059297 8357
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1Упражнение
Типы занятий. Допустим, у нас есть три типа ведения занятий. Ниже вам даны результаты экзаменов, по каждому из типов. Проверьте гипотезу о равенстве средних используя ANOVA.
- Online: \(72, 84, 77, 80, 81\), mean: 78.8
- Hybrid: \(83, 73, 84, 81\), mean 80.25
- Face-to-Face: \(80, 78, 84, 81, 86\), mean 81.8
Посмотрим на данные
| score | gr |
|---|---|
| 72 | Online |
| 84 | Online |
| 77 | Online |
| 80 | Online |
| 81 | Online |
| 83 | Hybrid |
| 73 | Hybrid |
| 84 | Hybrid |
| 81 | Hybrid |
| 80 | Offline |
| 78 | Offline |
| 84 | Offline |
| 81 | Offline |
| 86 | Offline |
Применим ANOVA
data %>%
  aov(score ~ gr, data = .) %>% summary()
Df Sum Sq Mean Sq F value Pr(>F)
gr 2 22.51 11.25 0.624 0.554
Residuals 11 198.35 18.03 Разбор ответа. Средние трех групп различаются (78.8, 80.2 и 81.8 балла), но внутригрупповой разброс велик, а выборки крошечные. F-статистика даже меньше единицы — межгрупповая дисперсия не превышает типичный внутригрупповой разброс, — и p-значение заметно больше 0.05. Мы не отвергаем нулевую гипотезу: эти данные не дают свидетельств того, что формат занятий влияет на средний балл за экзамен. Обратите внимание на формулировку: мы не «доказали, что разницы нет» — мы лишь не нашли достаточных свидетельств разницы на такой маленькой выборке.
«Стьюдент» — не фамилия, а псевдоним. Уильям Госсет, открывший это распределение в 1908 году, работал на пивоварне Guinness и занимался контролем качества на маленьких выборках. Пивоварня запрещала сотрудникам публиковаться, чтобы не выдавать коммерческие секреты, поэтому Госсет печатался под псевдонимом Student.↩︎