3 Числовые переменные
В этой главе мы детально говорим о переменных, числовых и категориальных, о способах их первичного анализа и визуализации.
Числовые переменные
Числовые переменные, как мы говорили, бывают двух типов.
- Непрерывные (continuous): такие как рост, вес, или артериальное давление
- Дискретные (discrete): такие как число разводов, число детей в семье, размер обуви
Мы также говорили, что не все переменные, которые выражены числами, действительно являются числовыми. IELTS - хороший тому пример. Попробуйте сложить его значения, результат не будет иметь смысла. Два человека с IELTS 5 не знают английский на 10 (этого балла даже нет). Сравните это с весом, где два 50-килограммовых человека вместе весят 100.
Помните оценки из школы? Двойки, тройки, порой даже четверки. Внешне - это числа, но на деле - категории. В свете этого, практика выводить оценку за четверть как среднее выглядит сомнительно. Действительно ли разница между удовлетворительно (3) и хорошо (4), это то же самое, что и разница между хорошо (4) и отлично (5)? Вопрос остается открытым.
Гистограмма
Допустим, перед нами какая-нибудь числовая переменная. Что с ней можно сделать? Например, визуализировать! Визуализация может казаться второстепенной практикой, это не анализ в строгом смысле, но на самом деле, представляя переменную в виде графика, вы получаете важную информацию о ее возможных значениях и распределении. Поэтому, в любой непонятной ситуации начинайте с визуализации.
Как мы можем визуализировать одну числовую переменную? Технически, перед нами набор, соответственно он имеет какой-то диапазон значений. Что если мы разобьем его на промежутки равной длины, а потом посчитаем, как много значений попало в каждый промежуток?
Затем, над каждым промежутком построим столбик, высотой пропорциональной числу значений. И вот у нас получилась гистограмма.
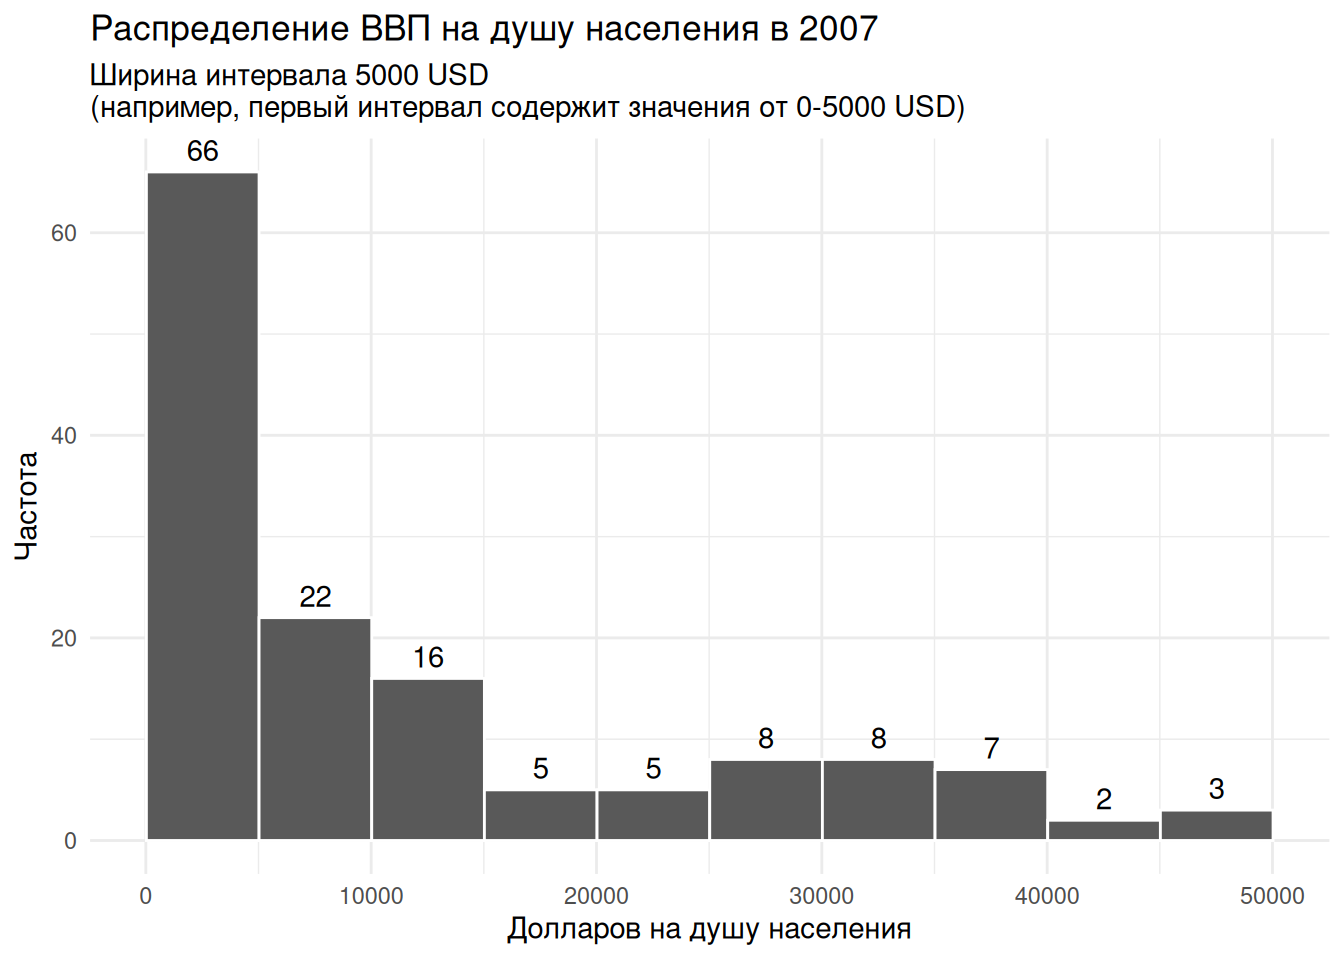
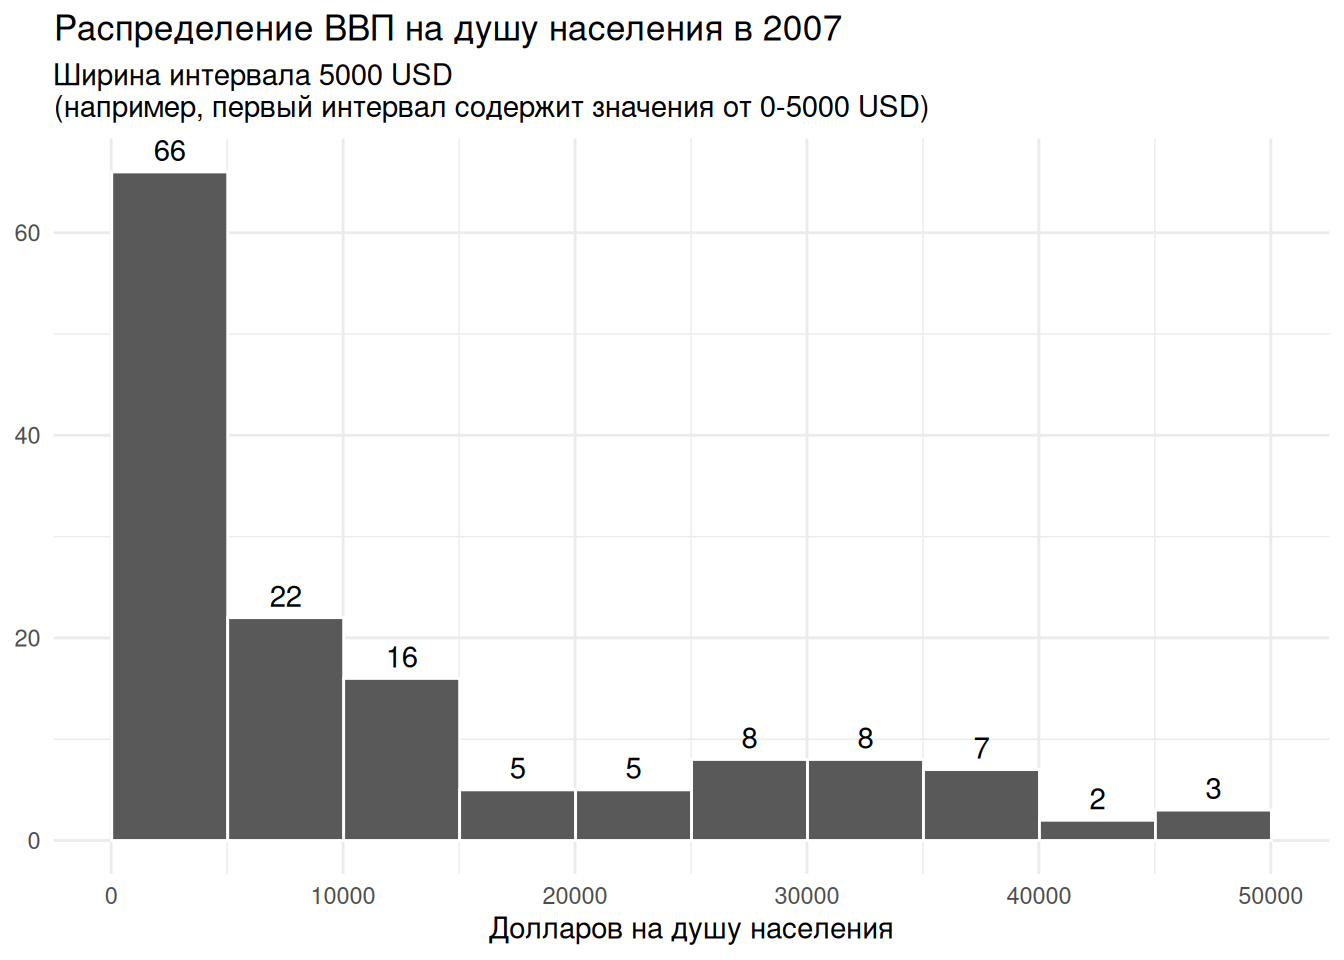
Ниже представлена гистограмма для ВВП на душу населения по странам в 2007 году. И ее характер уже дает нам инсайты: мы видим, что большинство стран в мире достаточно бедные, их ВВП ниже 10 тысяч на душу населения.
Есть также относительно небольшое количество богатых стран, у которых ВВП выше 40 тысяч.
Гистограмма строится следующим образом:
- Диапазон чисел разбивается на интервалы
- Для каждого интервала считается число наблюдений попавших в него
- Высоты столбцов пропорциональны частотам
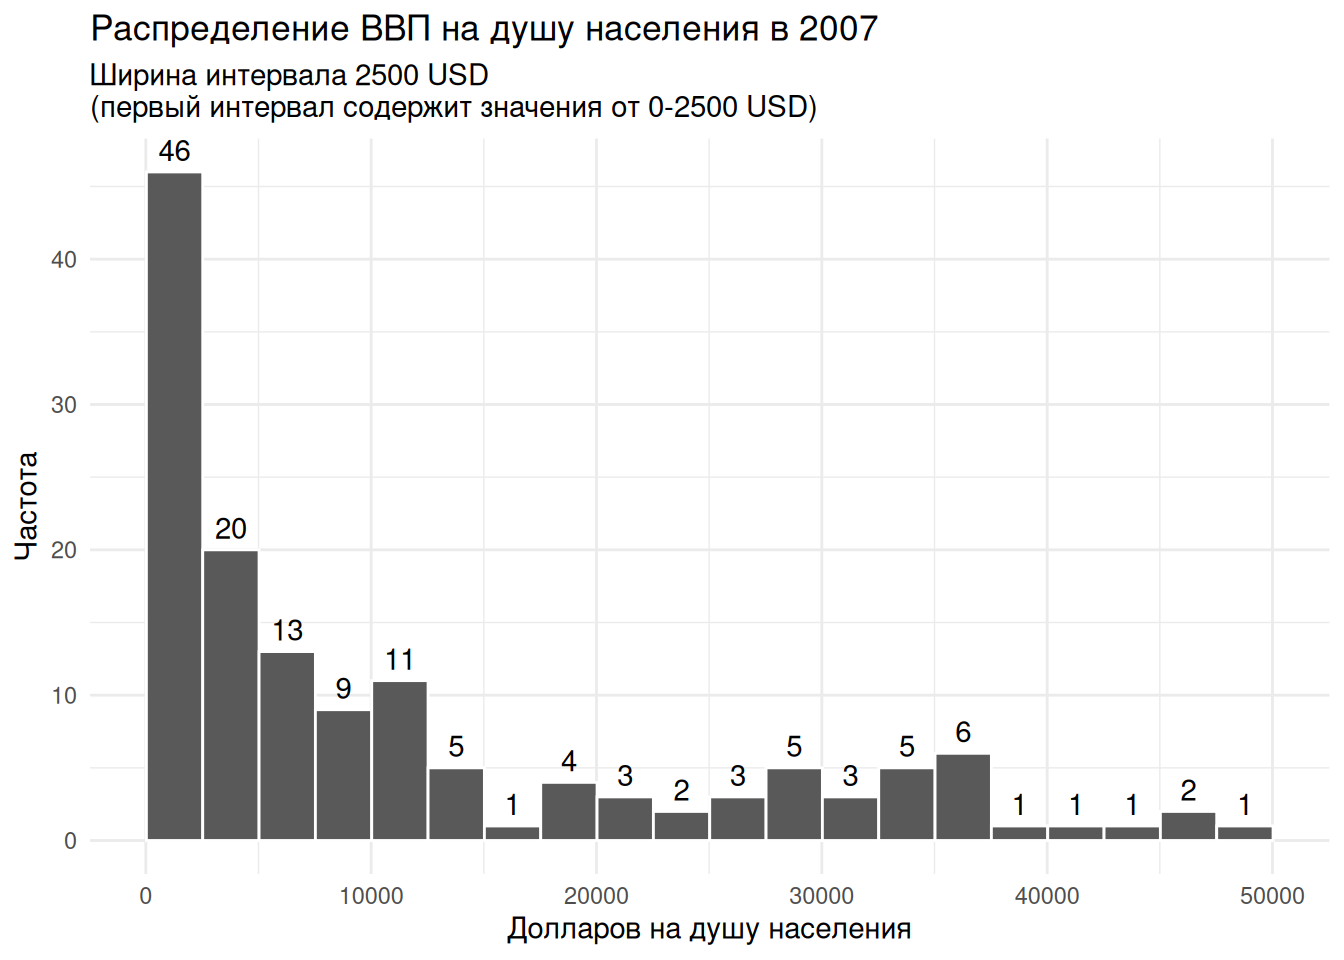
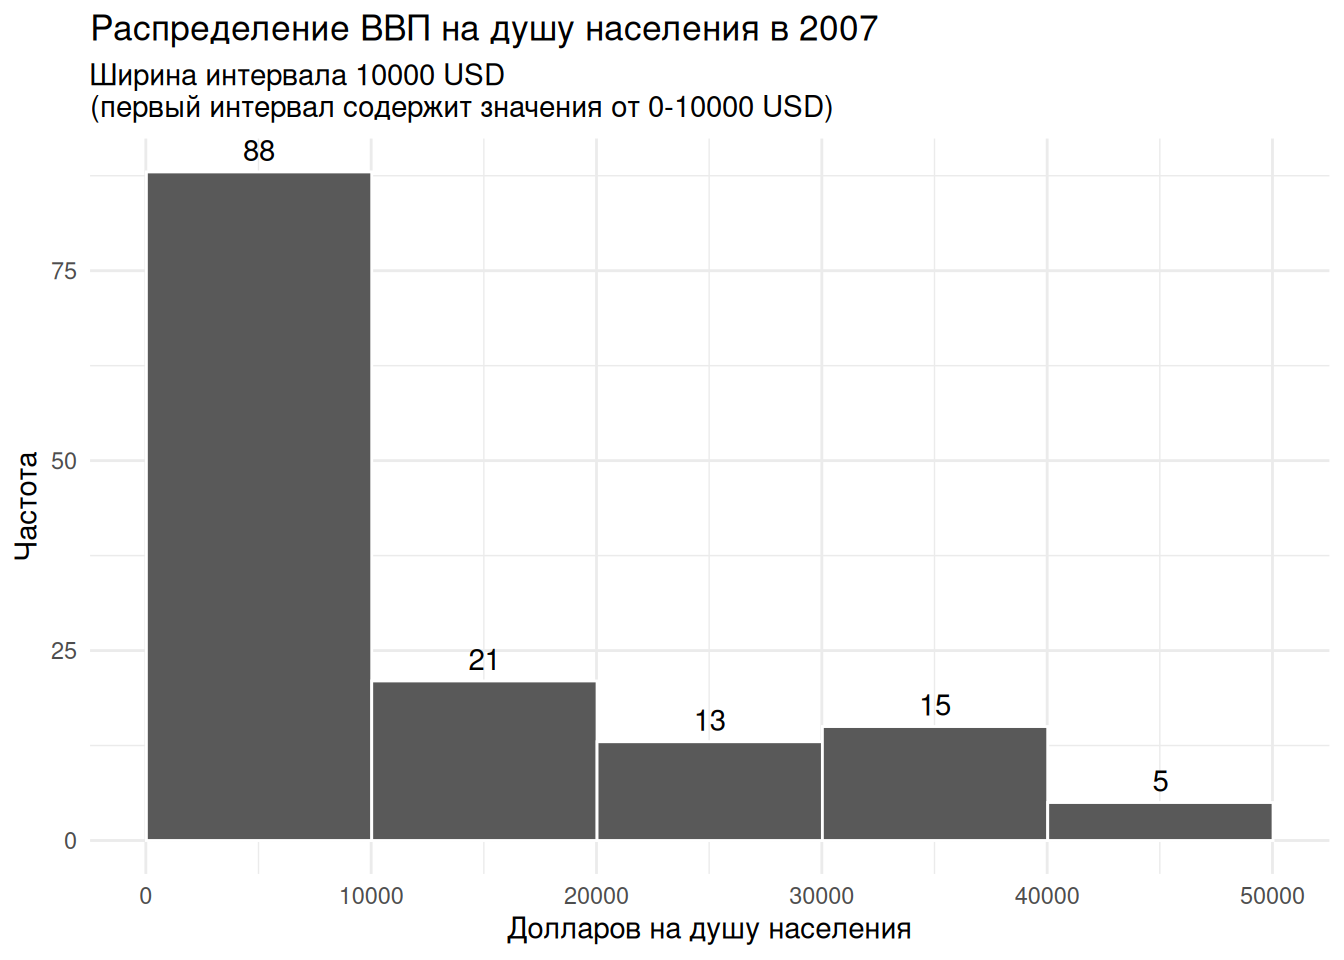
Размер интервала (на английском, кстати, его называют bin - корзина), над которым строится столбик, остается на ваше усмотрение. Изменяя его, вы можете детализировать или обобщать картину, как на графиках ниже.
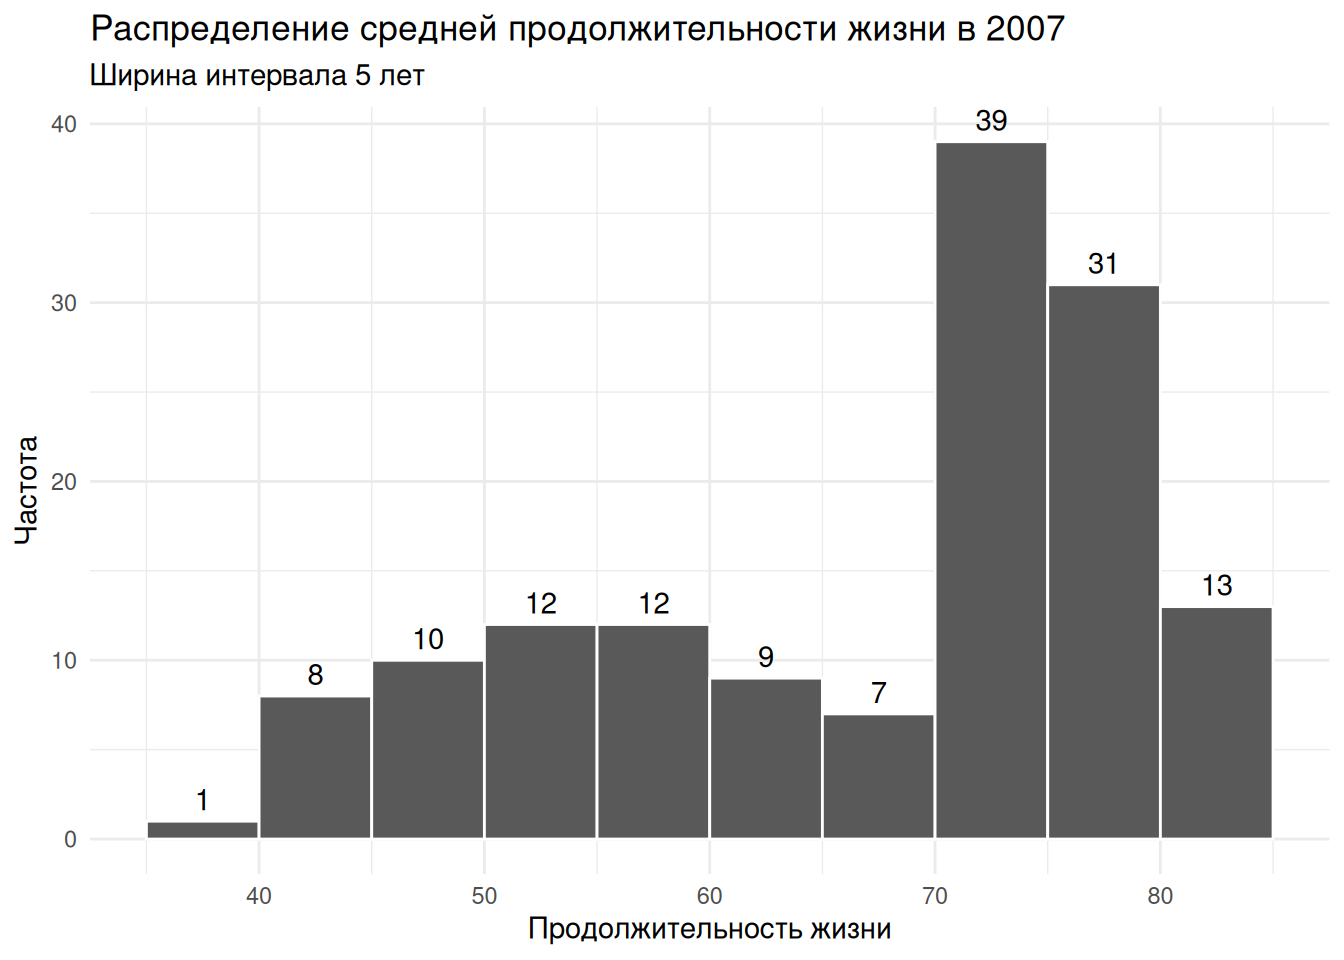
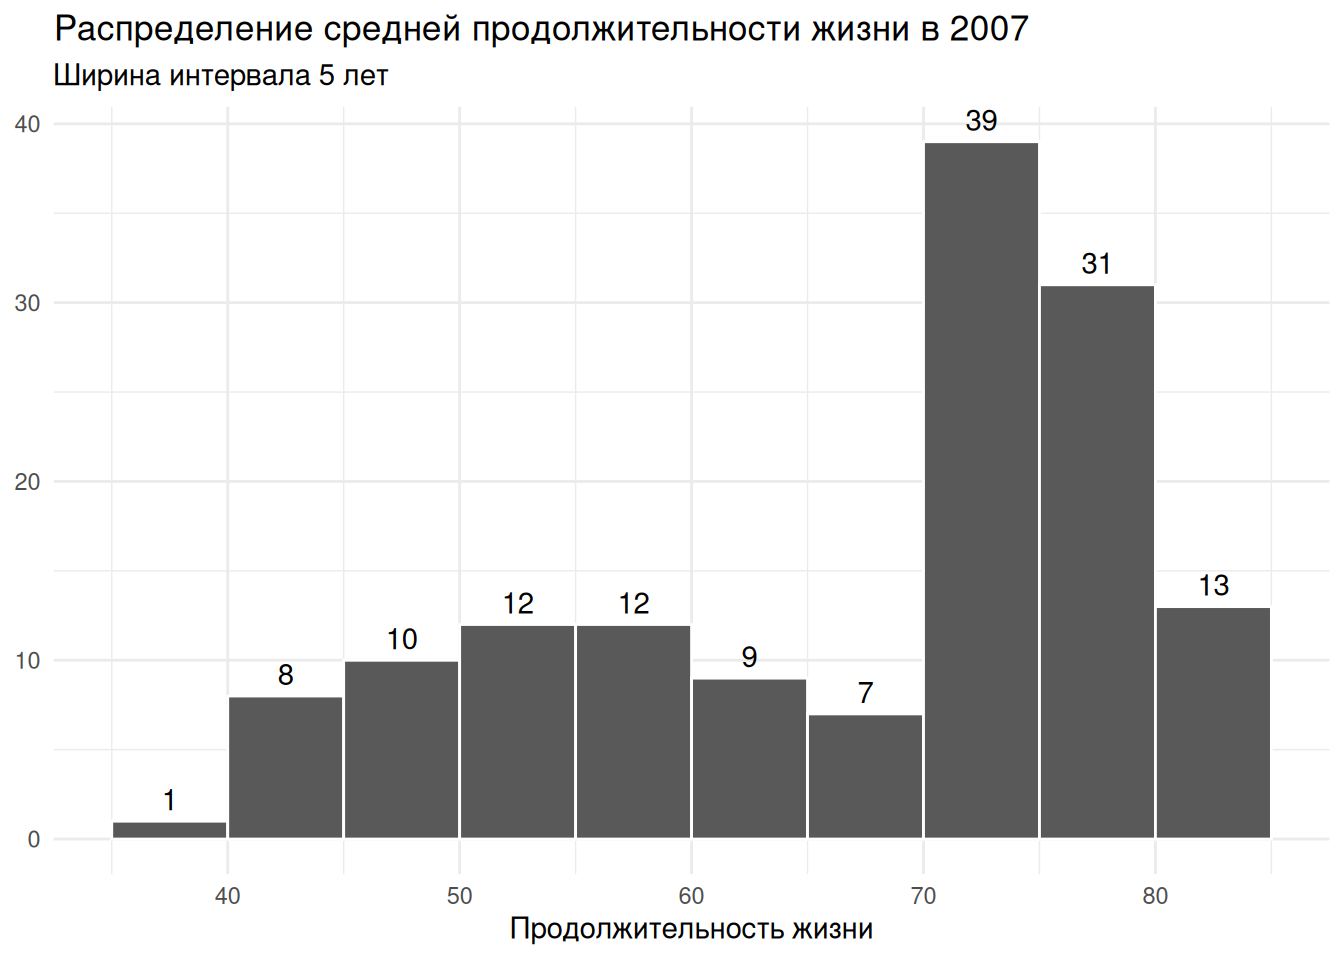
Теперь давайте посмотрим на другую переменную - среднюю продолжительность жизни. Ситуация тут зеркально противоположная, большинство стран имеет высокую продолжительность жизни, но есть несколько стран, в которых люди живут недолго.
Скошенность или “Хвост” распределения
ВВП и средняя продолжительность жизни, сказали бы статистики, скошенные распределения (skewed distributions)! Визуально это выражается в длинном “хвосте”, уходящем либо вправо, либо влево. Соответственно ВВП будет правоскошенным, а средняя продолжительность жизни - левоскошенным.
“Хвост” распределения - это неформальный, но часто используемый термин. Один из способов его интерпретации - это вероятность “редких” событий. Хвост как бы соответствует значениям переменной, которые находятся далеко от “центра”, то есть под ним лежат числа, которые редки по сравнению с типичным значением. Вслушайтесь в формулировку “Большинство стран имеют ВВП на душу населения в районе 10 тыс долларов, всего лишь пять стран имеют ВВП выше 40 тыс. долларов”. Иными словами, ВВП в 40 тыс - редкое явление и ему соответствует “хвост”.
В более общем смысле, скошенность позволяет классифицировать распределения - на скошенные и симметричные. Ниже показаны примеры
Мода или “Пик” распределения
Какие еще характеристики распределения можно выделить? Визуально распределение похоже на гору и соответственно у него как-будто бы есть “пик”. “Пику” соответствует самое частое значение, например, для средней продолжительности жизни пик приходится на 70–75 лет, это означает, что в этот промежуток попадает бОльшее число стран.
Формально, самое частое значение в распределении называют модой. Немного злоупотребляя терминологией, мы можем объявить “пик” распределения - модой, и соответственно по числу пиков делить распределения на
юнимодальные (один пик)
бимодальные (два пика)
мультимодальные (три и больше пиков)
Почему мы остановились на трех и больше? Ну, на самом деле, потому что дальше уже нет смысла дифференцировать. А зачем нам вообще надо делить распределения по числу пиков? Потому что часто модальность может дать нам важную информацию о переменной.
Давайте посмотрим на пример бимодального распределения.
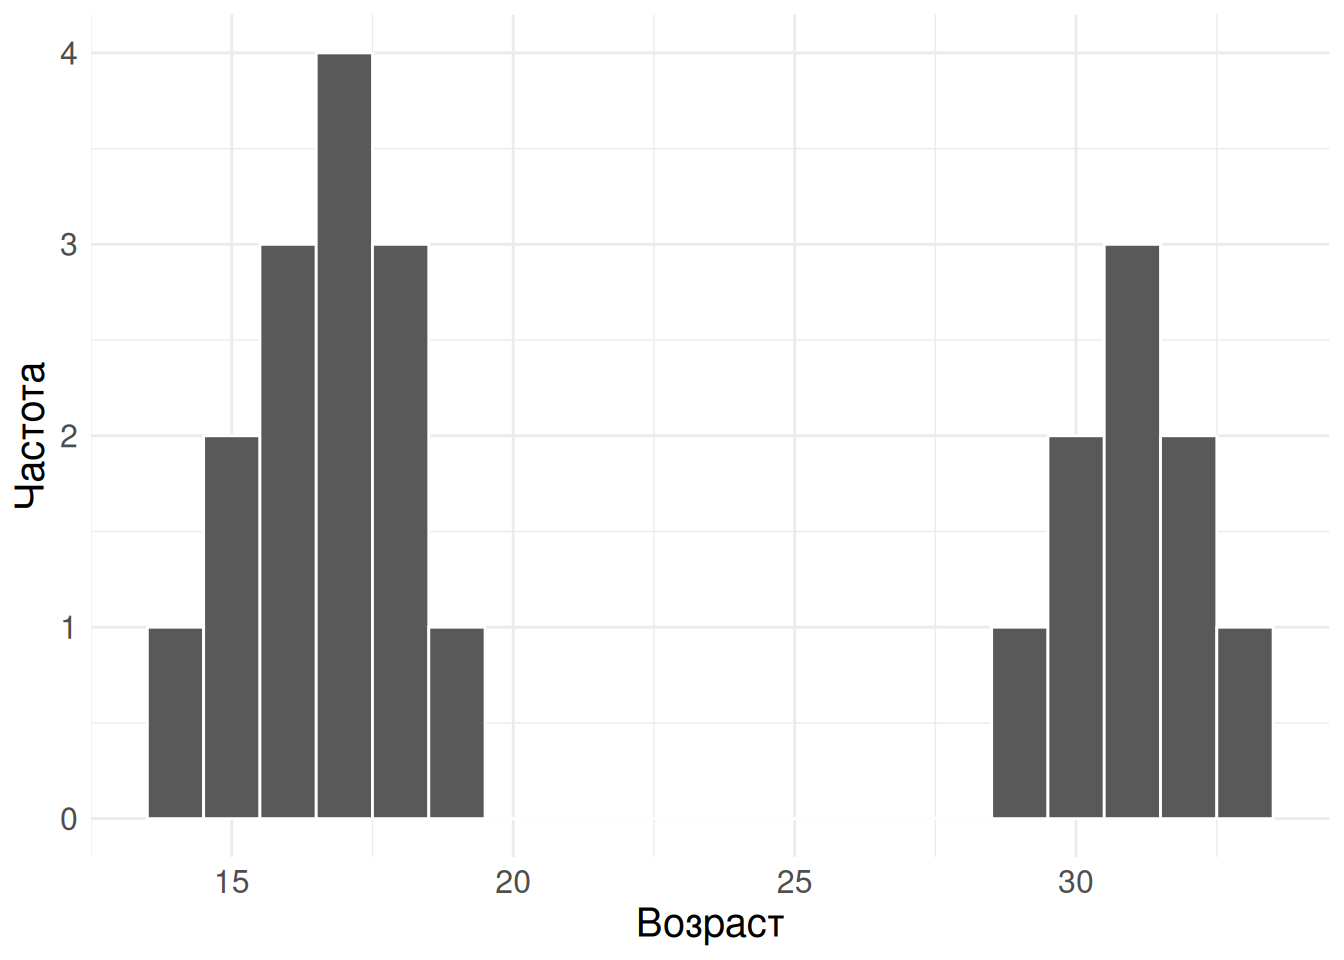
Допустим, эти числа – возраста людей. Первый пик соответствует подгруппе от 14 до 19, а второй пик подгруппе от 29 до 33. Мы видим, что наша выборка состоит из двух групп людей, у которых в среднем сильно различается возраст. Когда у вас распределение визуально имеет два или больше пиков, это может говорить о том, что у вас несколько принципиально различающихся подгрупп внутри одной числовой переменной. Например, как в этом случае подростки и взрослые.
Меры центральной тенденции: среднее и медиана
Один из ключевых способов работы с данными — использование обобщающих характеристик, позволяющих представить распределение в сжатом виде. Вместо анализа всех наблюдений мы оперируем несколькими показателями, которые фиксируют его основные свойства.
Как правило, нас интересуют две вещи: где расположен центр распределения (наиболее типичное значение) и насколько велик разброс значений относительно этого центра. Соответственно, речь идет о мерах центральной тенденции и мерах вариации.
Начнем с первого. Предположим, у нас есть данные по ВВП за 2007 год, и мы хотим понять, каким был «средний» уровень ВВП в мире. Какие способы обобщения здесь возможны?
Первое, что могло прийти в голову, банально посчитать среднее арифметическое. Нас учили этому в школе, и это то, что мы обычно делаем в повседневной жизни. Единственное, уточним, что считаем мы среднее на выборке, поэтому будем его называть
Выборочное среднее - это сумма всех значений, деленная на число наблюдений
\[\bar{x} = \frac{x_1 + x_2 + \dots + x_n}{n}\]
Например, \(\{1, 2, 3, 4, 10\} \rightarrow \bar{x} = \frac{1+2+3+4+10}{5}=4\)1
Менее очевидный вариант - посчитать выборочную медиану. Медиана - это такое число, которое делит вашу выборку на две равные половины: половина чисел меньше этого числа, а половина - больше. Например, для чисел \(1, 2, 3, 4, 10\) медиана будет \(3\).
Что лучше?
Среднее чувствительно к выбросам — наблюдениям, значительно удалённым от основной массы данных. Например, если в некой компании 5 работников получают 100 тысяч тенге, а директор — 1 миллион, средняя зарплата составит 250 тысяч тенге. Однако это значение плохо отражает «типичный» уровень дохода, поскольку сильно смещено из-за одного экстремального наблюдения.
Медиана в этом смысле оказывается более репрезентативной: в приведённом примере она равна 100 тысячам тенге и лучше соответствует зарплате большинства сотрудников.
Это различие хорошо видно, если мысленно исключить выброс. Среднее значение существенно изменится (с 250 до 100 тысяч), тогда как медиана останется прежней. Именно эта устойчивость к выбросам называется робастностью.
В целом статистики часто делят на робастные и неробастные: медиана относится к первым, тогда как среднее — ко вторым.
Под робастностью в статистике понимают нечувствительность к различным отклонениям и неоднородностям в выборке, связанным с теми или иными, в общем случае неизвестными, причинами.
Зачем это важно? Как мы уже видели, разные меры центральной тенденции по-разному ведут себя при наличии выбросов: среднее чувствительно к ним, тогда как медиана остаётся робастной. Поэтому выбор между ними напрямую связан с формой распределения — прежде всего с его скошенностью.
Скошенность обычно возникает из-за выбросов. Именно они «вытягивают» распределение в одну сторону и смещают среднее, тогда как медиана остаётся сравнительно стабильной. Отсюда следует, что ответ на вопрос «что лучше — среднее или медиана?» зависит от контекста. Например, доходы домохозяйств чаще описываются медианой, поскольку их распределение, как правило, скошено вправо (подумайте, почему). В то же время среднее сохраняет важную информацию о распределении в целом: зная его, можно, например, оценить совокупный доход или общее богатство в регионе.
Упражнение
Глядя на графики попытайтесь понять какая линия на каждом графике соответствует среднему, а какая - медиане
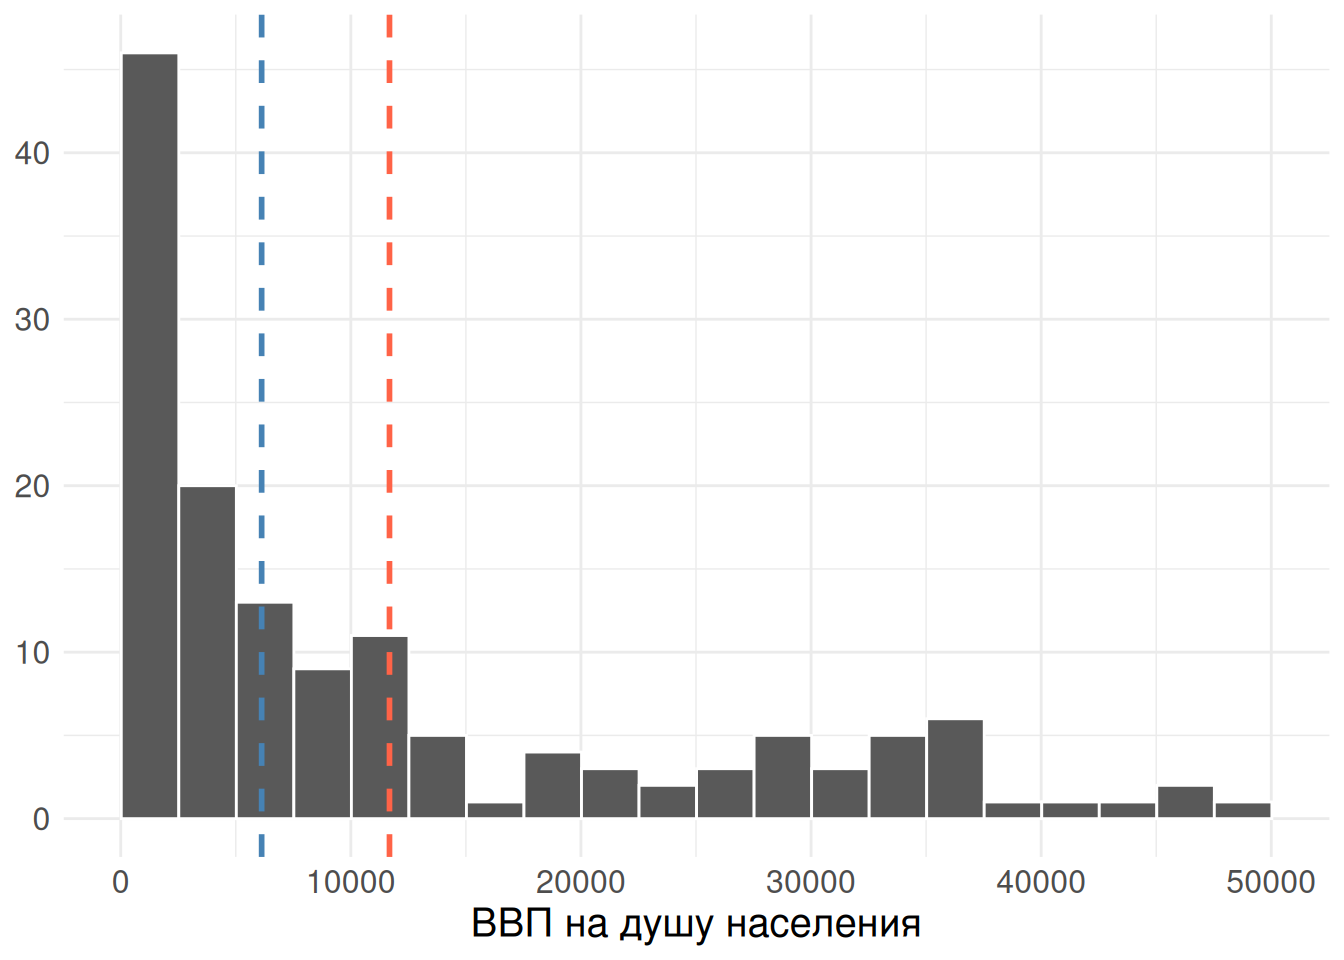
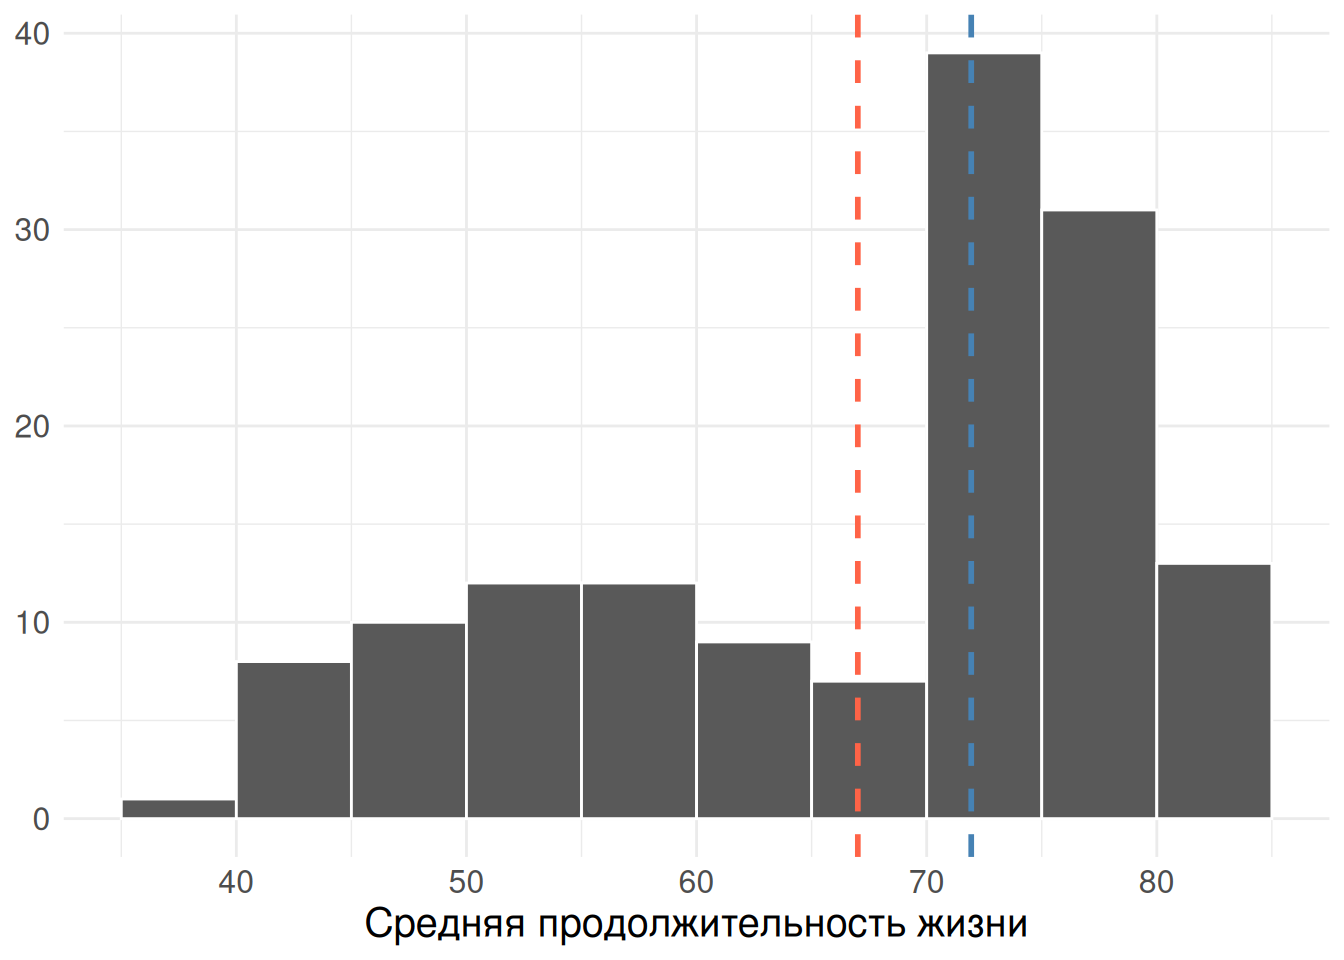
Ответ:2
Общее правило можно сформулировать так: при работе со скошенными распределениями и наличием выбросов предпочтительнее использовать робастные статистики, такие как медиана; если же распределение близко к симметричному, допустимо опираться на среднее.
Интуитивно это различие можно описать так: среднее «тянется» в сторону выбросов, тогда как медиана остаётся сравнительно стабильной. Именно это свойство лежит в основе простой эвристики, позволяющей судить о форме распределения даже без его визуализации.
Сравнивая среднее и медиану, можно получить приблизительное представление о скошенности:
если среднее больше медианы, распределение, как правило, скошено вправо;
если среднее меньше медианы — влево;
если они близки, распределение близко к симметричному.
Таким образом, среднее чувствительно к выбросам, тогда как медиана остаётся более устойчивой характеристикой центра.
Меры разброса: дисперсия, стандартное отклонение и интерквартильный размах
Рассмотрим, как можно количественно описать разброс значений вокруг центра распределения. Предположим, у нас есть два кафе с одинаковым средним месячным доходом — 1,5 млн тенге. Однако помесячные значения у них различаются (смотрите таблицу).
Интуитивно легко заметить разницу: в одном случае доходы меняются плавно, в другом — наблюдаются резкие колебания. Иначе говоря, в первом кафе значения более стабильны и сгруппированы ближе к среднему, тогда как во втором — разбросаны сильнее.
Возникает вопрос: как формализовать это различие? Самая простая идея — сравнить минимум и максимум (размах). Однако такая мера опирается только на крайние значения и потому чувствительна к выбросам.
Нас же обычно интересует более содержательная характеристика: насколько, в среднем, наблюдения отклоняются от центрального значения. Именно такие меры и лежат в основе более информативных показателей разброса.
| month | Cafe A | Cafe B |
|---|---|---|
| января | 1000 | 700 |
| февраля | 1300 | 1900 |
| марта | 700 | 1000 |
| апреля | 1200 | 1100 |
| мая | 800 | 500 |
| июня | 1000 | 800 |
Дисперсия и стандартное отклонение
Как можно формализовать разброс значений? Естественная идея — посмотреть, насколько каждое наблюдение отклоняется от среднего. Обозначим это отклонение (девиацию) как разность между значением и средним.
Если проделать это для всех наблюдений, возникает следующая проблема: простое суммирование девиаций даёт ноль, поскольку положительные и отрицательные отклонения взаимно компенсируются. Чтобы избежать этого, отклонения необходимо преобразовать — например, взять их абсолютные значения или, что чаще используется, возвести в квадрат.
Сумма квадратов отклонений уже даёт осмысленную характеристику разброса. Однако она зависит от числа наблюдений, поэтому её необходимо нормировать — разделить на их количество. В результате мы получаем дисперсию (variance) — одну из основных мер вариативности данных.
Таким образом, если размах (минимум–максимум) учитывает только крайние значения, то дисперсия опирается на отклонения всех наблюдений от среднего и потому даёт более содержательное представление о разбросе.
Сначала вычислим отклонения от среднего и их квадраты:
\[\begin{align*} \delta_i = x_i - \bar{x}, \quad (x_i - \bar{x})^2 \end{align*}\]
Сумма квадратов отклонений:
\[\begin{align*} \sum_{i=1}^{6}(x_i - \bar{x})^2 = 260000 \end{align*}\]
Тогда дисперсия равна:
\[\begin{align*} \text{Var}(X) = \frac{1}{n}\sum_{i=1}^{6}(x_i - \bar{x})^2 = \frac{260000}{6} \approx 43{,}333 \end{align*}\]
Дисперсия хорошо решает задачу измерения разброса, однако у неё есть важный недостаток: она выражается в квадрате исходных единиц измерения. Например, если исходная переменная измеряется в сантиметрах, дисперсия будет в квадратных сантиметрах, что затрудняет интерпретацию.
Чтобы вернуться к исходному масштабу, из дисперсии извлекают квадратный корень. Полученная величина называется стандартным отклонением.
Интуитивно стандартное отклонение можно понимать как «типичное» отклонение наблюдения от среднего — то, насколько далеко значения в среднем отклоняются от своего центра.
\[ sd(X) = \sqrt{43{,}333} \approx 208 \]
Интерквартильный размах (IQR)
Казалось бы, если есть дисперсия и стандартное отклонение, стоит ли искать что-то еще? Однако, как и в случае с центральной тенденцией, возникает проблема выбросов. Дисперсия опирается на среднее, а значит, наследует его чувствительность к экстремальным значениям. Если в данных много выбросов, дисперсия будет завышена.
Это подталкивает к поиску более робастных характеристик разброса. Здесь полезно обобщить идею медианы. Медиана делит распределение пополам: 50% наблюдений лежат ниже неё, 50% — выше. Однако тот же принцип можно распространить на другие пропорции.
Так вводятся квартили — точки, делящие распределение на заданные доли:
первый квартиль (\(Q_1\)) — значение, ниже которого находится 25% наблюдений; третий квартиль (\(Q_3\)) — значение, ниже которого находится 75% наблюдений.
Интервал между ними — интерквартильный размах (IQR) — охватывает центральные 50% данных и служит робастной мерой разброса, практически не реагирующей на выбросы.
В этом ряду второй квартиль соответствует медиане, что показывает: квартили представляют собой обобщение той же идеи деления распределения.
Важно понимать, что робастность имеет свою цену. Медиана и производные от неё меры игнорируют часть информации о величине различий между наблюдениями. Среднее, напротив, использует всю доступную информацию, включая расстояния между значениями, поэтому и оказывается чувствительным к выбросам.
Таким образом, выбор между робастными и неробастными мерами — это не вопрос «лучше–хуже», а баланс между устойчивостью к шуму и полнотой использования информации.
Упражнения
Распределение ВВП на душу населения в датасете gapminder скошено вправо: существует несколько очень богатых стран. Что будет лучше описывать это распределение, среднее или медиана?
Ответ:
- Если вы хотите понять насколько богата типичная страна, то медиана.
- Но если вы хотите понять насколько, например, “богат” мир в целом, то среднее.