| state | homeownership | application_type |
|---|---|---|
| NJ | MORTGAGE | individual |
| HI | RENT | individual |
| WI | RENT | individual |
| PA | RENT | individual |
| CA | RENT | joint |
| KY | OWN | individual |
| MI | MORTGAGE | joint |
| AZ | MORTGAGE | individual |
| NV | MORTGAGE | individual |
| IL | RENT | individual |
4 Категориальные переменные
Категориальные переменные
Давайте теперь перейдем к категориальным переменным и попытаемся быстро понять, что с ними можно сделать. Здесь на самом деле все гораздо проще, чем с числовыми переменными.
Данные
Работать будем с датасетом «Займы» — это данные о кредитах, выданных на американской платформе Lending Club. В Штатах много микрофинансовых организаций, которые служат альтернативой банкам, и Lending Club — одна из них, построенная на принципе взаимной солидарности. Представьте себе, что у вас есть некая общая касса, в которую вы вместе с другими участниками регулярно складываете деньги. Если кому-то из сообщества нужны деньги под проект, он может взять их оттуда — оформляется это так же, как обычный кредит. Единственная разница в том, что здесь нет накладных расходов на организацию банковской работы: участники дают деньги друг другу напрямую, поэтому кредитная ставка становится меньше. Условно, вы занимаете не под 15% годовых, а под 10% — за счет солидарности участвующих.
В датасете \(10000\) наблюдений (займов) за тремя переменными:
state: Штат, в котором выдан кредитhomeownership: Статус домовладения — надо было указать, в каком статусе находится место, в котором вы живете: собственность (OWN), ипотека (MORTGAGE) или аренда (RENT)application_type: Тип заявки — индивидуальная (individual), когда вы подаете сами, или совместная (joint), когда вы делаете это с кем-то вместе
Например, первый кредит в таблице был выдан в штате Нью-Джерси, и человек живет в ипотечном жилье. Если вдруг интересно, можно почитать про платформу подробнее: https://en.wikipedia.org/wiki/LendingClub
Частоты
Что можно сделать с категориальными переменными? Все предельно интуитивно и просто. Самое очевидное — посчитать частоты уровней, то есть как часто встречаются те или иные категории.
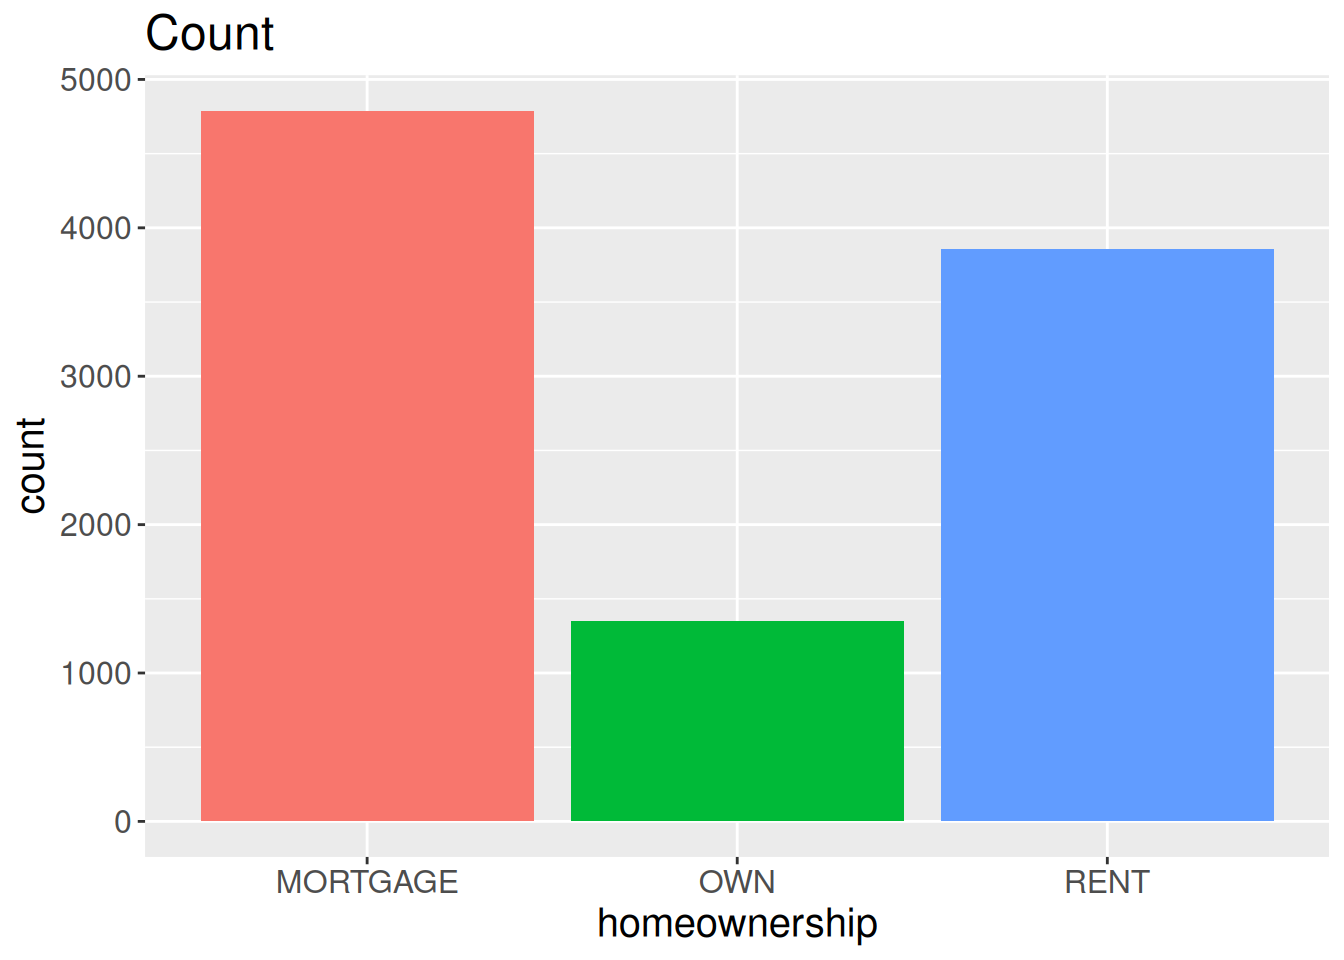
Если у нас одна переменная, мы можем просто посчитать частоты разных категорий. Возьмем homeownership: посмотрим, как много заявок было от ипотечников, как много — от людей, которые владеют своим жильем, и как много — от тех, кто жилье арендует. Большинство людей, которые подаются на такого рода займы, выплачивают ипотеку. За ними следуют арендаторы, и только потом идут люди, у которых жилье находится в собственности.
| homeownership | n |
|---|---|
| MORTGAGE | 4789 |
| OWN | 1353 |
| RENT | 3858 |
Аналогично по типу заявки (application_type): большинство заявок подавались индивидуально, около 15% — совместно.
| application_type | n |
|---|---|
| individual | 8505 |
| joint | 1495 |
Визуализация
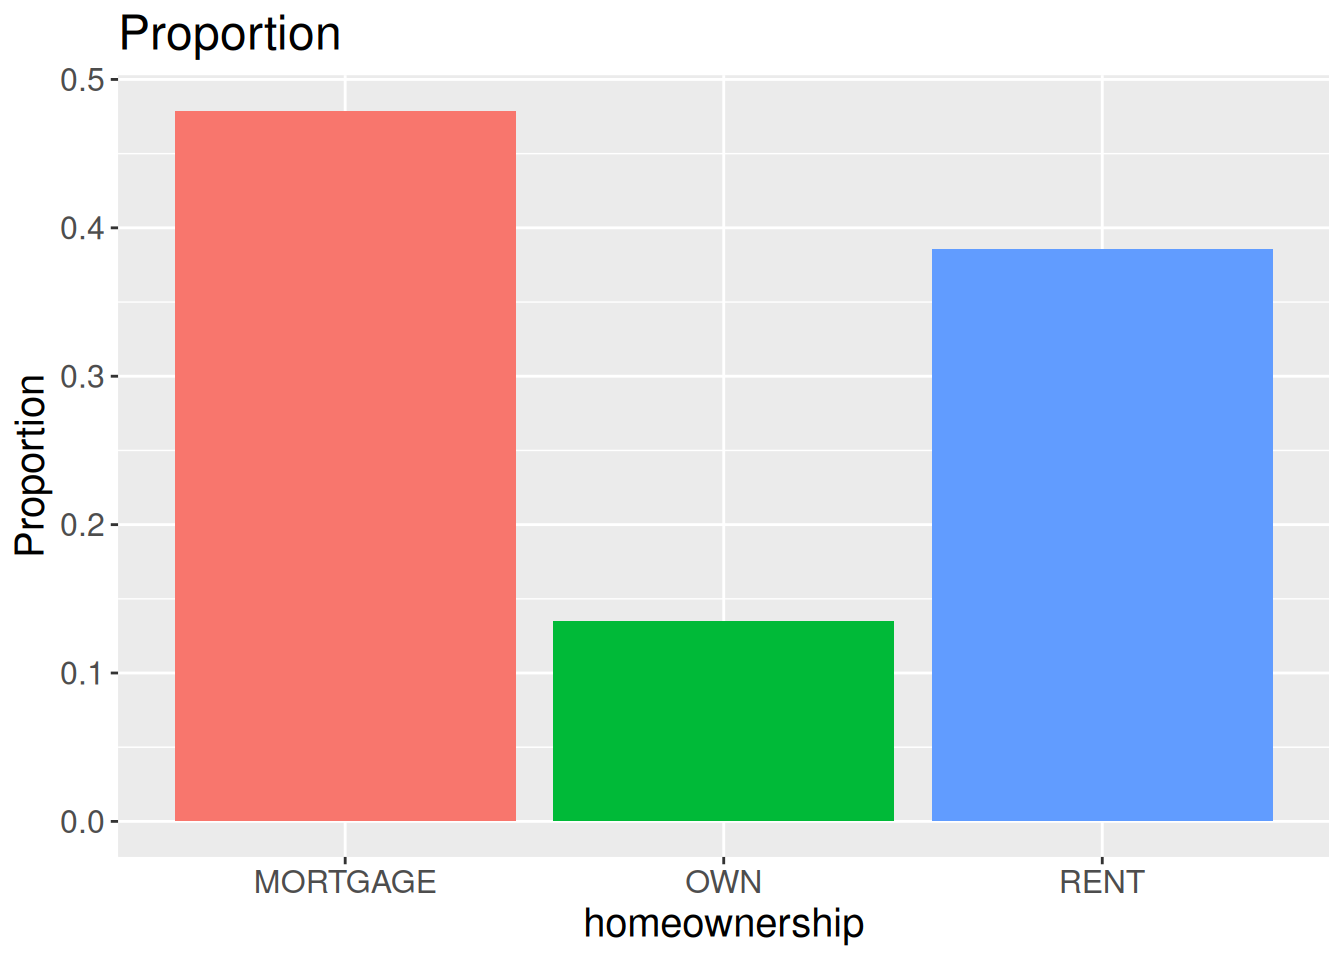
Что еще можно сделать с этими таблицами частот? Решение само просится: давайте построим столбцовые диаграммы (barcharts) — просто возьмем эти числа и представим их в виде столбцов, так, чтобы высота столбца соответствовала частоте или относительной частоте.
Аналогично для типа заявки:
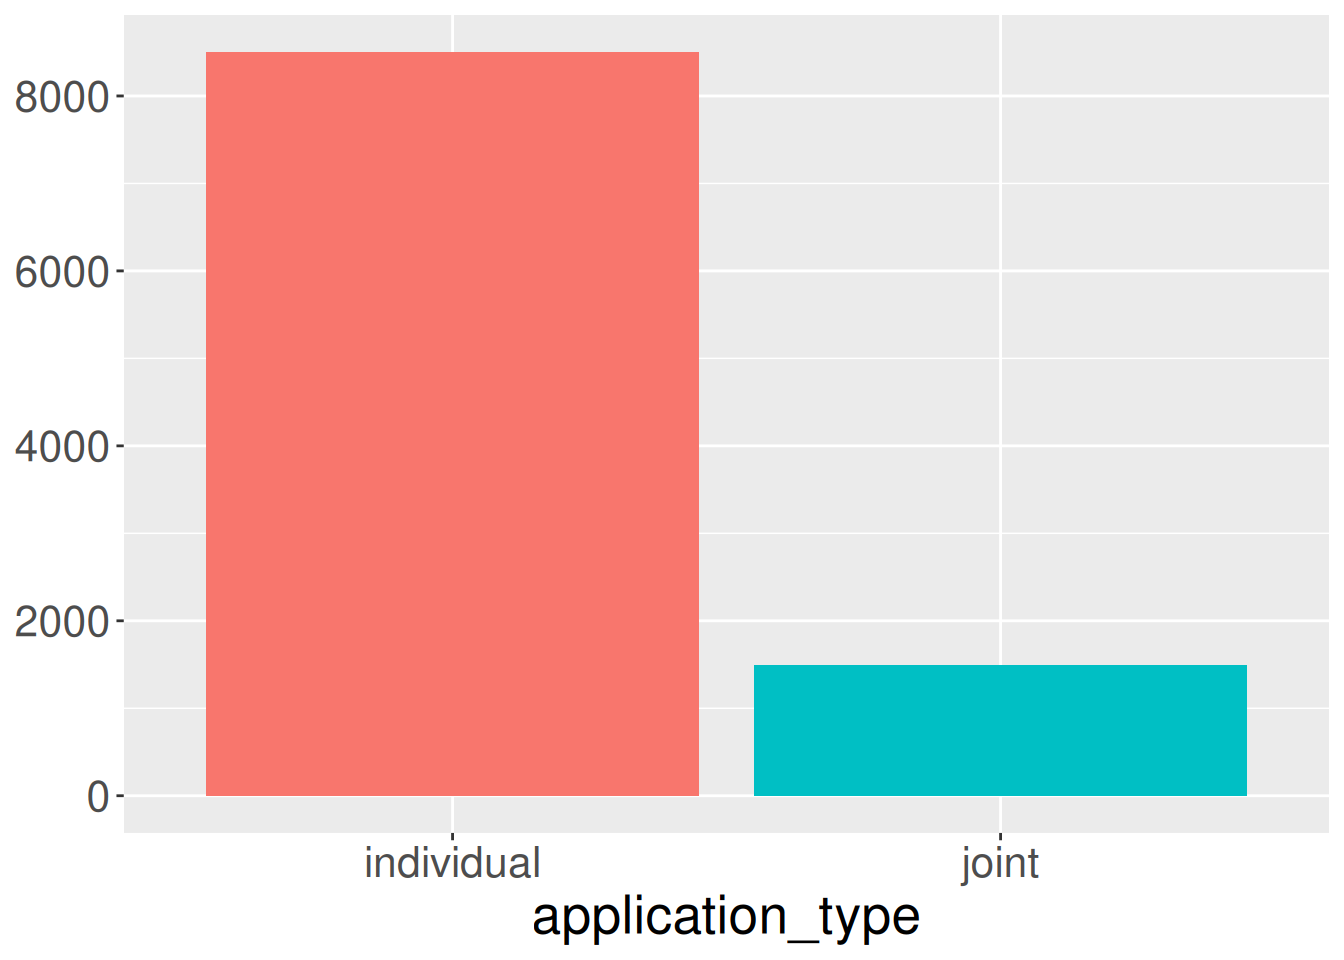
Таблица сопряженности (contingency table)
Какой следующий шаг? Все очень логично. Давайте просто посмотрим на совместное распределение двух переменных.
У нас есть тип заявки и тип домовладения. Мы можем посмотреть, как много случаев попадает на пересечение этих категорий; такая таблица называется таблицей сопряженности. Мы видим, что, например, 3839 – это количество заявок, которые были индивидуальными и пришли от ипотечников. А 950 заявок были совместными и тоже пришли от ипотечников. Пока это все абсолютные числа.
| application_type | MORTGAGE | OWN | RENT |
|---|---|---|---|
| individual | 3839 | 1170 | 3496 |
| joint | 950 | 183 | 362 |
Маржинальные (marginal) распределения
Если мы посчитаем так называемые маржинальные распределения, то есть просто сложим числа по столбцам и по строкам, мы вернемся к отдельным распределениям, характеризующим каждую переменную по отдельности. Суммы 8505 и 1495 – это распределение переменной «тип заявки», а три суммы по столбцам – распределение переменной «тип домовладения».
table(loans$application_type, loans$homeownership) %>%
  addmargins()
             MORTGAGE   OWN  RENT   Sum
  individual     3839  1170  3496  8505
  joint           950   183   362  1495
  Sum            4789  1353  3858 10000
Строковые и столбцовые пропорции
Хорошо, но что еще можно тут сделать — перейти от абсолютных чисел к пропорциям. Почему? Потому что пропорции универсальны: они не зависят от размера выборки, и мы могли бы сравнивать их с какими-то другими данными, которые пришли из совершенно другого контекста, с совершенно другим размером выборки. Более того, помимо обычных пропорций мы могли бы посмотреть на строковые и столбцовые пропорции.
Что это такое? Вместо того чтобы считать проценты по всей таблице сразу, мы говорим: давайте на время поживем только внутри одной «вселенной» — внутри индивидуальных заявок. И внутри этих индивидуальных заявок посчитаем, какой процент людей был в ипотеке, какой был владельцем жилья и какой его арендовал. Что для этого технически надо сделать? Просто сложить числа в строке, получить 8505, а потом каждое из этих чисел разделить на сумму строки. Мы получим пропорции по строкам и увидим, как меняется пропорция категорий одной переменной в зависимости от категорий другой переменной.
Смотрите: по строкам у нас идут категории переменной «тип заявки». Мы видим, что для индивидуальных заявок пропорция ипотечников была 45%, а для совместных заявок — 63%, почти на 20 процентных пунктов выше. О чем это говорит? О том, что люди, которые подавали совместные заявки, чаще имели свое жилье в ипотеке. Одно из объяснений могло быть таким: люди женились или вышли замуж, как семья взяли себе ипотеку и, соответственно, подают на заем совместно — просто потому, что находятся в легальных отношениях, которые облегчают совместную подачу заявки.
То есть мы уже начинаем наблюдать некую зависимость между этими двумя переменными — просто посмотрев на то, как меняются пропорции в зависимости от значений другой переменной. И теперь важный концептуальный ход. Сейчас мы работаем с пропорциями: 45%, 13,8%, 41%. А что мы еще измеряем с помощью процентов? Вероятности событий. И мы можем переинтерпретировать эту таблицу следующим образом. Если мы случайным образом выбираем из этой таблицы одного человека, и мы знаем, что он подавал индивидуальную заявку — то есть живем в этой «вселенной», — я могу сказать: вероятность того, что он ипотечник – 45%, вероятность того, что он владелец – 13,8%, вероятность того, что он арендует – 41%.
Теперь, если повторить аналогичное упражнение для совместных заявок, вероятности изменятся: вероятность ипотеки – уже 63% против 45%, а вероятность аренды – 24% против 41%. О чем это говорит? Вероятности меняются в зависимости от значения другой переменной. Скорее всего, наши переменные каким-то образом между собой связаны: то, какое значение мы имеем в одной переменной, меняет вероятности значений другой переменной. Запомните эту идею — она в дальнейшем получит развитие, когда мы формально покажем, что такое зависимость и независимость между двумя переменными.
Итак, делим каждый элемент строки на сумму этой строки:
             MORTGAGE   OWN  RENT   Sum
  individual     3839  1170  3496  8505
  joint           950   183   362  1495
  Sum            4789  1353  3858 10000
             MORTGAGE   OWN  RENT   Sum
  individual    0.451 0.138 0.411 1.000
  joint         0.635 0.122 0.242 1.000
  Sum           0.479 0.135 0.386 1.000
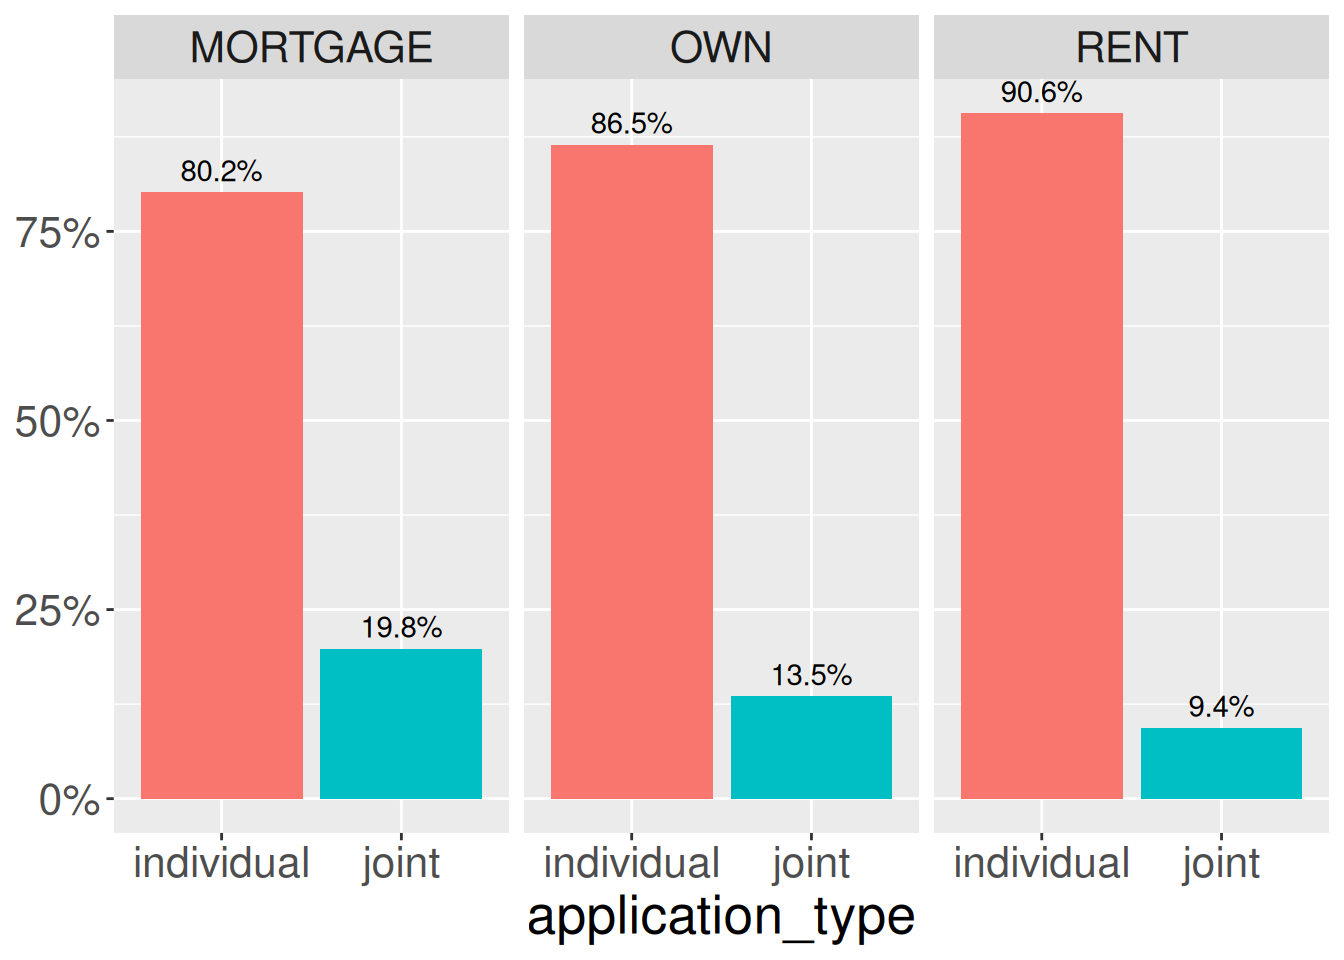
Сейчас мы работали со строками, но на самом деле ничего не мешает нам работать со столбцами: выбор, что поставить вдоль строк, а что вдоль столбцов, произволен. Действуем аналогично: фиксируем столбец, складываем по нему числа, получаем общее, а потом все, что есть в этом столбце, делим на это общее. Мы получаем примерно то же самое, просто теперь с точки зрения другой переменной. Смотрим на заявку, которая была подана от ипотечника: какова вероятность того, что это была индивидуальная заявка? 80%.
А если это была заявка от владельца квартиры, какова вероятность, что она индивидуальная? 86%. А если от арендатора? 90%. И опять мы видим маленькую фотовспышку, высвечивающую социальную реальность: люди, которые живут в ипотеке, реже подают индивидуальные заявки, а люди, которые живут в арендованном жилье, — чаще. Логично, да?
             MORTGAGE   OWN  RENT   Sum
  individual     3839  1170  3496  8505
  joint           950   183   362  1495
  Sum            4789  1353  3858 10000
             MORTGAGE   OWN  RENT   Sum
  individual    0.802 0.865 0.906 0.851
  joint         0.198 0.135 0.094 0.150
  Sum           1.000 1.000 1.000 1.000
Таблицы сопряженности и столбцовые диаграммы
Что еще можно сделать с таблицами сопряженности визуально? Да то же самое — построить столбцовые диаграммы. Но теперь, поскольку переменных две, мы можем построить столбцы так, чтобы они отражали уровни одной переменной, а сами столбцы раскрасить так, чтобы они показывали относительные пропорции другой переменной.
Таблицы сопряженности и строковые/столбцовые пропорции помогают понять связь между категориальными переменными. Визуализировать таблицу сопряженности можно как
- Стековую диаграмму (stacked barplot)
- Группированную диаграмму (side-by-side barplot)
- Стандартизованную диаграмму (standardized barplot)
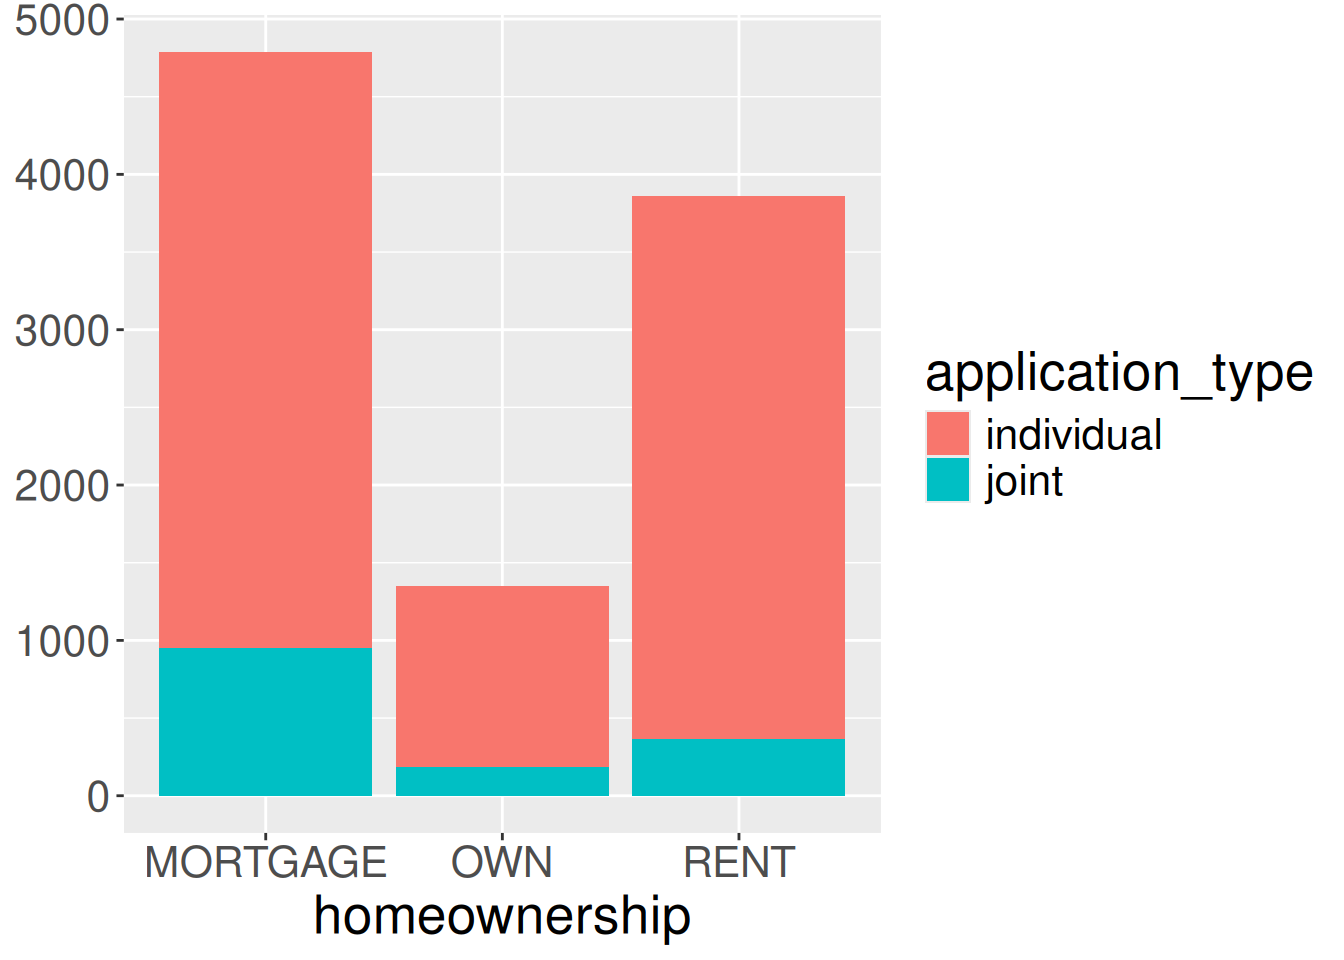
Начнем со стековой. Строим столбцы по типу домовладения — у них разные высоты, — но теперь внутри каждого столбца показываем, какая его часть соответствует совместным заявкам, а какая — индивидуальным. Мы просто «наваливаем» уровни один на другой (стек):
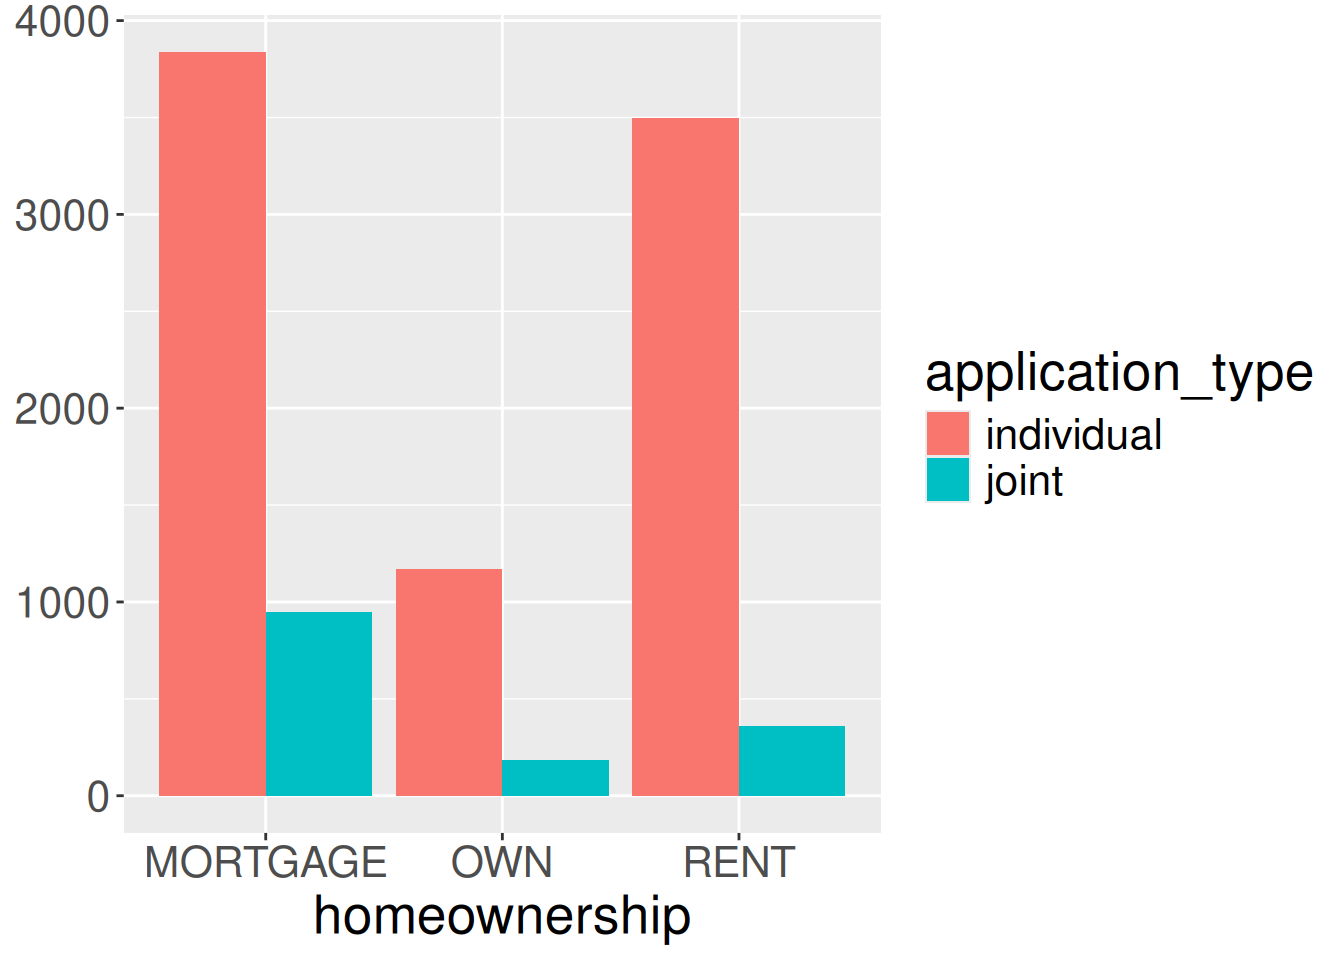
Вместо того чтобы ставить уровни друг на друга, мы можем их разрезать и сделать группированную столбцовую диаграмму — уровни складываются рядом друг с другом. Так проще увидеть, как одна переменная распределена по уровням другой переменной:
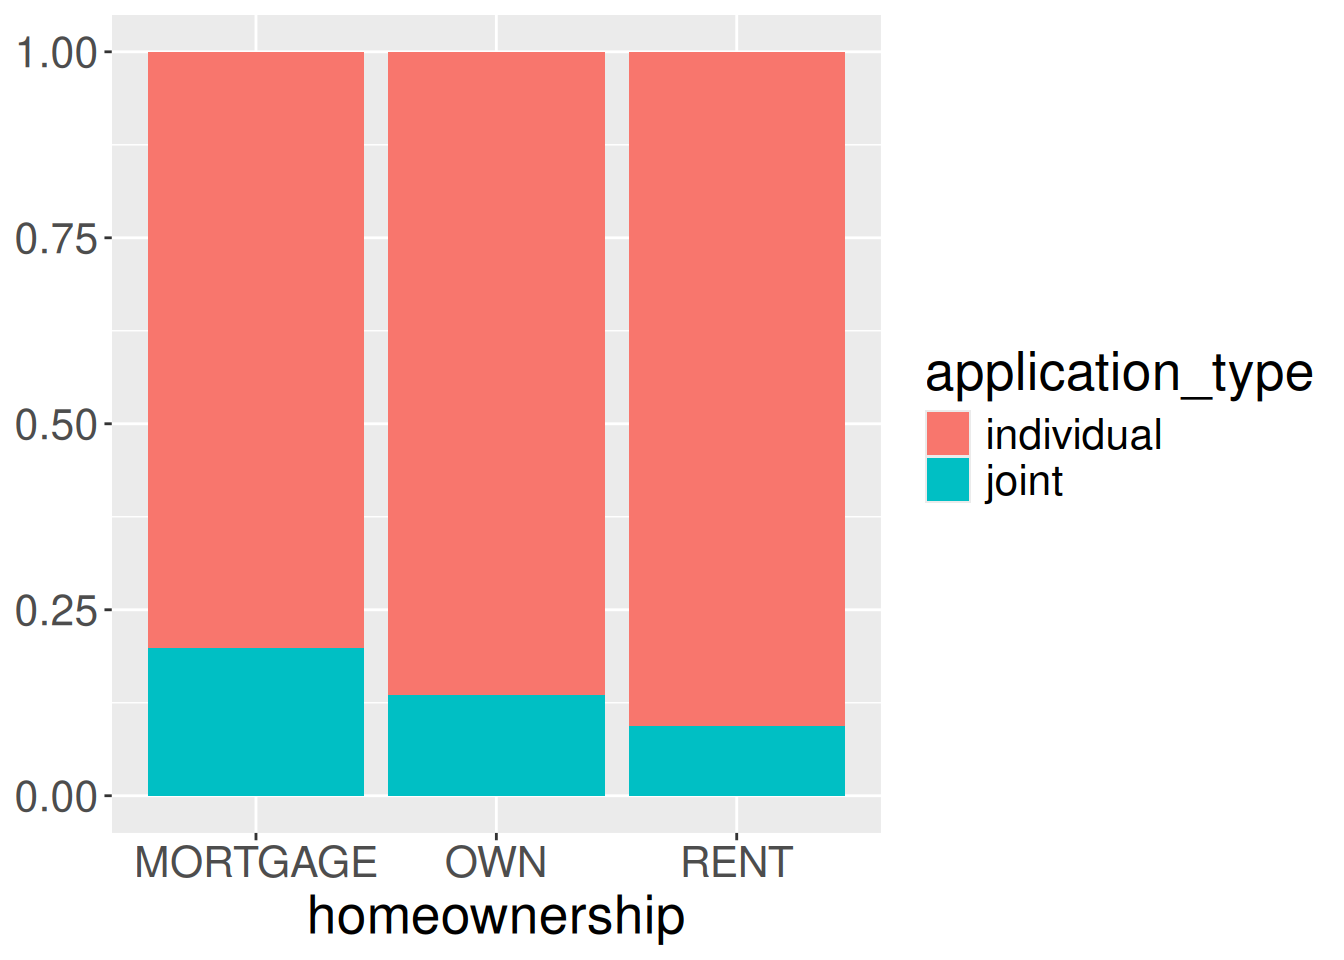
Ну и чтобы работать с пропорциями было удобнее всего, столбцы можно нормализовать — сделать их высоту фиксированной, равной единице, а потом внутри показать соответствующие пропорции другой переменной. Это стандартизованная диаграмма: приводим все столбцы к одной высоте, а потом делим пропорционально уровням второй переменной. Так пропорции видны лучше всего:
Стековая хороша, когда вы точно представляете, где у вас объясняющая переменная, а где переменная-отклик. Вы сначала группируете наблюдения по объясняющей, а потом разбиваете их на стеки по уровням переменной-отклика
Групповая позволяет лучше видеть число наблюдений в группах
Стандартизованная подходит, когда у вас “дисбаланс” уровней: когда один уровень охватывает большую часть наблюдений
Иногда можно просто построить несколько панелей — по одной для каждого уровня категориальной переменной:
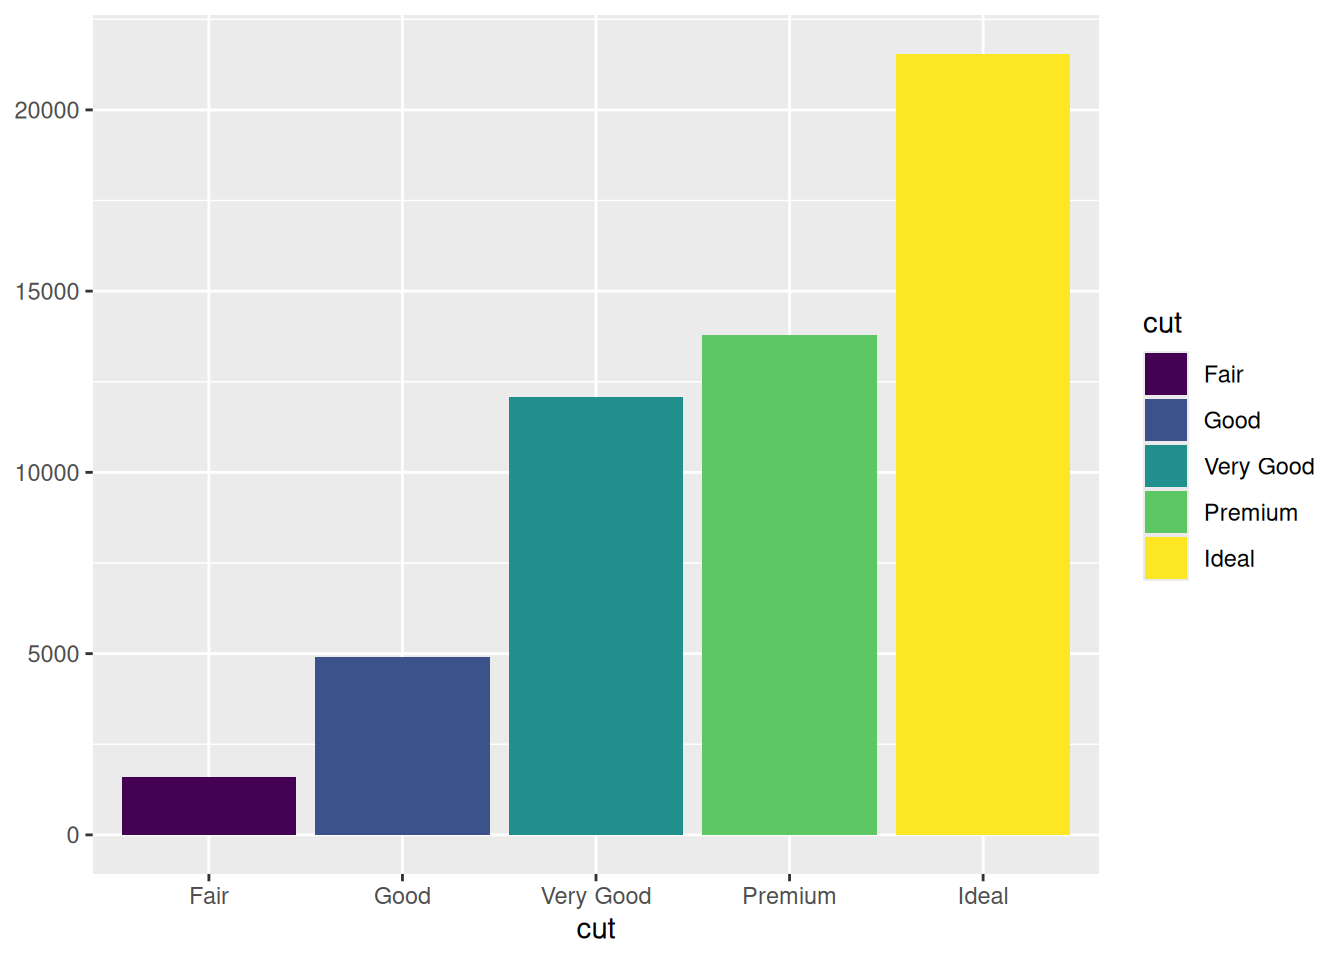
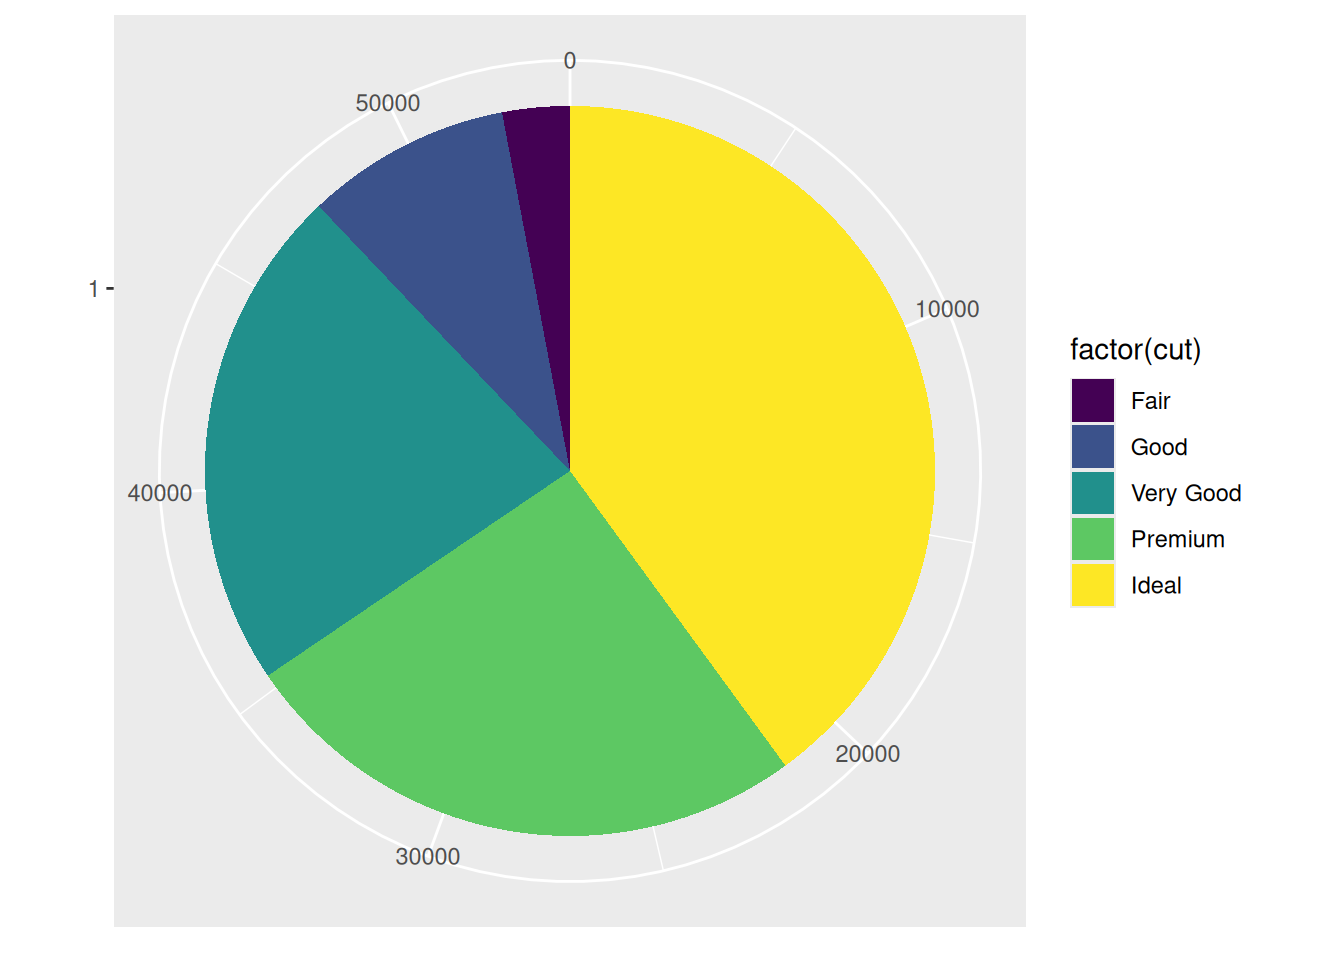
Круговые диаграммы (pie-charts) - под запретом!
В визуализации данных есть общее мнение, что круговые диаграммы — это плохо. Зачем нам нужны графики? Для того, чтобы быстро понять, как распределены данные: например, какая категория самая представленная, какая на втором месте, какая на третьем. На барчарте это сделать относительно легко. А теперь попробуйте на пайчарте сказать, какая категория больше, а какая меньше. Ладно, самую большую еще можно определить относительно легко. Но как решить, какой из двух похожих секторов второй по величине, а какой третий? Приходится сидеть и упражнять глазомер — это не очень удобно. Отчасти по этой причине сложилась конвенция: круговые диаграммы, за очень редким исключением, не используем.
Числовая ~ Категориальная переменные
Теперь давайте представим ситуацию, что у нас есть числовая переменная и категориальная переменная. Что мы можем в этой ситуации сделать? Идея простая:
- Разбиваем числовую переменную на подгруппы соответственно уровням категориальной
- Визуализируем числовую переменную
- ящичковыми диаграммами (boxplots)
- или прозрачными гистограммами
- Добавляем к графикам выборочные статистики
- среднее
- медиану
- стандартное отклонение
- и подобное
Ящичковая диаграмма (boxplot)
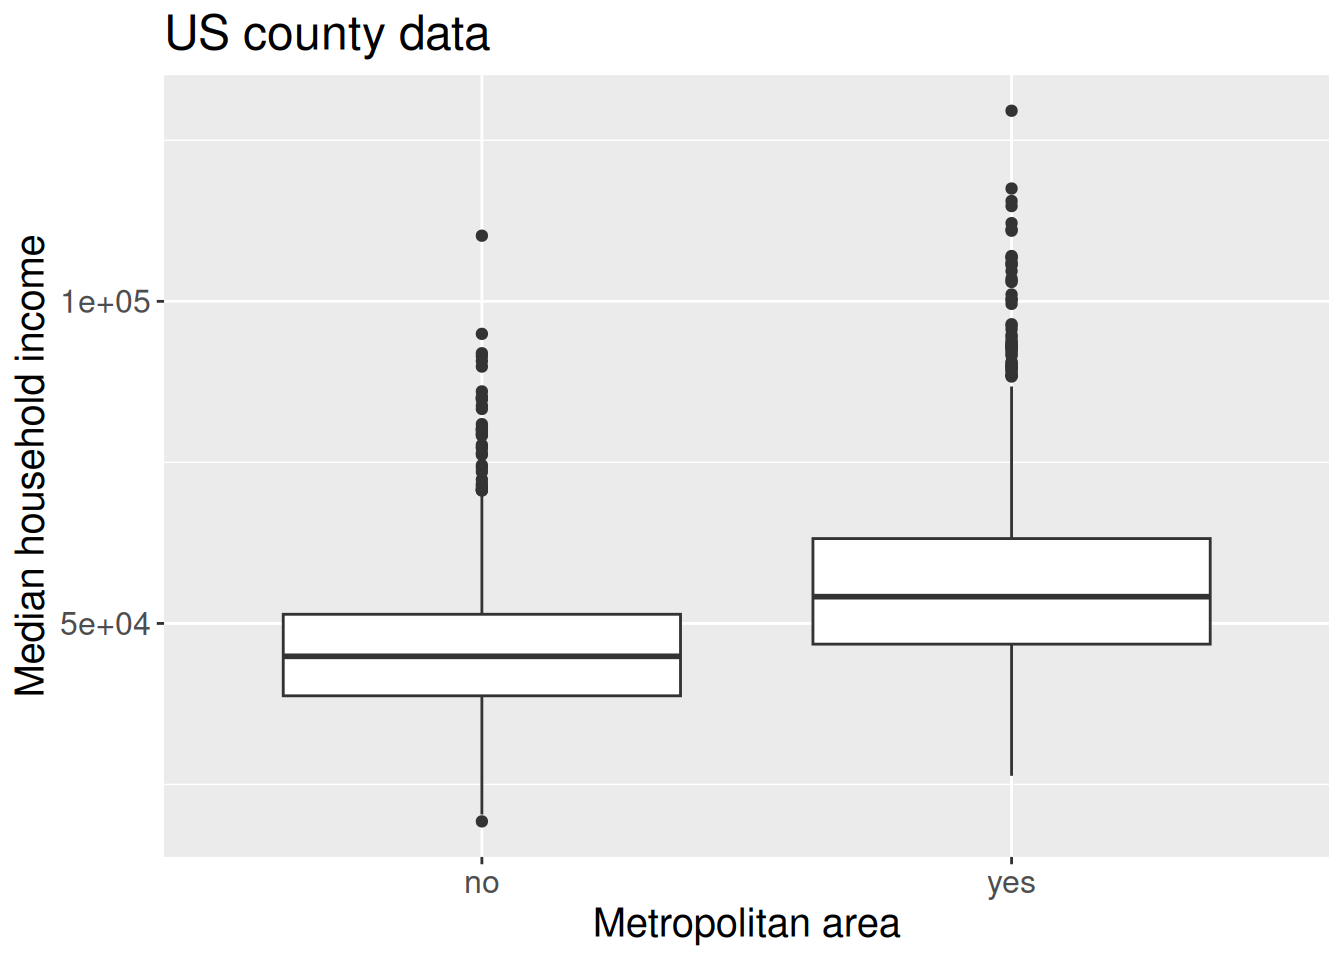
Работает она очень просто. Мы берем какую-то категориальную переменную — в нашем случае это признак, входит ли округ США в метрополитенский ареал, — и для каждой подгруппы строим «ящичек». Сам ящик соответствует интерквартильному размаху: его нижняя граница – это первый квартиль, то есть число, которое делит выборку в соотношении 25–75; его верхняя граница – это третий квартиль, число, которое делит выборку в противоположном соотношении 75–25. А черная линия посередине – это медиана. Вместе они показывают нам центр распределения и границы, в которых лежат центральные 50% наблюдений.
Дальше идут усы (по-английски их так и называют — whiskers). Усы показывают, в каких пределах находится почти вся остальная часть распределения, то есть приблизительный размах, который могли принимать значения. А точки за пределами усов – это выбросы (outliers).
На самом деле боксплот можно нарисовать и для одиночной числовой переменной. Но как-то так повелось, что удобнее всего он, когда есть еще и категориальная переменная: боксплотами удобно сравнивать, как распределение числовой переменной меняется в зависимости от уровня категориальной. Здесь мы, например, видим то, что могли бы ожидать: у округов, входящих в метрополитенские ареалы, медианный доход домохозяйства в среднем выше — он находится где-то в районе 50 тысяч долларов. Главный инсайт: тот же самый доход для округов за пределами метрополий существенно ниже. Понятно, что везде есть выбросы: среди «неметрополитенских» округов есть небольшое количество очень богатых, и, соответственно, есть какое-то количество округов внутри метрополий, где доход домохозяйств относительно скромный. Такая вот эвристика на случай, когда у вас с одной стороны категориальная переменная, а с другой — числовая.