9 Непрерывные случайные переменные
Плотность вероятности
Теперь поговорим о непрерывных переменных. Хотелось бы коротко, но коротко не получится: придется совсем чуть-чуть пострадать, и потом все. Непрерывные случайные переменные — это, например, рост случайного человека или средняя оценка за год по математике случайно взятого школьника: переменные, которые могут принимать любые значения на каком-то интервале.
Почему с ними сложнее? Конкретному значению не получится приписать вероятность — возможных значений бесконечно много, и вероятность каждого отдельного значения равна нулю (вспомните пример с дротиком и мишенью из главы про вероятность). Значит, нужно искать какой-то выход. Выход придумали такой: вместо вероятности будем назначать значениям плотность — то, насколько в данной точке сконцентрирована вероятность. Это что-то, что пропорционально вероятности, но самой вероятностью не является.
Подумайте об этом в чисто физическом смысле. У вас есть кусок какого-то материала. Вы отрезаете от него кусочек, взвешиваете, делите массу на объем — получаете плотность. Теперь представьте, что вы делаете этот кусочек все меньше и меньше: масса стремится к нулю, объем стремится к нулю, но их отношение стремится к чему-то ненулевому и осмысленному. Плотность вероятности — та же идея, примененная к случайной переменной: с одной стороны у нее есть «масса» (вероятность), с другой — «объем» (кусок пространства исходов). Уменьшаем кусок — обе величины стремятся к нулю, а их отношение стремится к осмысленному числу, которое и назвали плотностью вероятности.
Формально это выглядит так.
- Определение: Случайная переменная называется непрерывной, если существует функция \(f_X\), которая называется функцией плотности вероятности (probability density function, PDF), такая что
\[\begin{align*} P(x \in A) &= \int_{A}f_X(x)dx, \forall A \subseteq R \\ \textrm{ в частности } \\ P(a \leq x \leq b) &= \int_a^bf_X(x)dx \end{align*}\]
Если интегралы вызывают у вас дрожь — спокойно: все, что нам реально нужно знать о плотности, это что она — некая положительная функция, которая на вход получает значение переменной, а на выходе выдает что-то пропорциональное вероятности. Если проинтегрировать ее по всему пространству исходов, получится единица; если проинтегрировать по какому-то интервалу — получится вероятность того, что переменная попадет в этот интервал.
Интерпретация
- Одна из возможных интерпретаций: возьмем малый интервал \([x, x+\delta]\)
\[ P([x, x+\delta]) = \int_{x}^{x+\delta} f_X(t)dt \approx f_X(x)\delta \]
- То есть \(f_X(x)\) это “отношение вероятности к длине интервала”
- Помните, что плотность вероятности - \(f_X(x)\) - это не вероятность
- Она может быть больше \(1\)
Еще одна метафора, чтобы дожать интуицию. Вероятность — это что-то вроде массы. Представьте, что у вас 1 г масла, и вы намазываете (т.е. распределяете) этот один грамм на тост. Если выбрать какой-нибудь “регион” тоста, на нем будет некая масса масла. Если уменьшать регион, масса масла на нем тоже будет уменьшаться: оба числа — площадь региона и масса масла — будут стремиться к нулю, но их отношение — нет. PDF — это предел отношения вероятности к размеру региона; плотность показывает вам концентрацию вероятности в точке.
\[ \lim_{\Delta x \Delta y \rightarrow 0} \frac{F(\Delta x \Delta y)}{\Delta x \Delta y} = PDF = f_{X}(x) \]
Где нам могла бы пригодиться PDF?
Рост людей. Рост – непрерывная величина. Если у вас есть PDF роста случайно взятого человека, вы можете оценить, насколько вероятно встретить человека ростом 170–175 см.
Скорость автомобилей. Камеры измеряют скорость машин на дороге. Зная распределение скоростей, можно посчитать вероятность того, что автомобиль движется со скоростью от 60 до 70 км/ч — полезно при настройке дорожных знаков или установке камер.
Медицина: анализы. Этот пример мне нравится больше всего. Когда вы сдаете анализы, вам показывают ваше число и рядом — диапазон «нормальных значений». Откуда берется этот диапазон? У медиков есть оценка PDF — распределения возможных значений показателя у людей вашего возраста и прочих характеристик. Зная его, можно сказать: у 95% людей уровень, скажем, сахара находится в этих пределах (3.9–5.5 ммоль/л). Если ваше значение выпадает из типичного диапазона — это редкое событие, и, возможно, повод присмотреться к здоровью повнимательнее. Так распределения помогают детектировать аномалии.
Свойства PDF
Функция плотности показывает, сколько плотности в какой-либо точке пространства исходов. Чтобы быть настоящей PDF, функция должна соблюдать два условия:
\(f_{X}(x) > 0, \forall x\): функция должна быть положительной
\(\int_{\Omega}f_X(x)dx = 1\): интеграл по всему пространству исходов должен быть равен 1
- Вы распределили 1 единицу вероятности по пространству; если все собрать назад, должна выйти опять единица.
В целом, любая функция, удовлетворяющая этим двум условиям, может быть PDF. Можно сказать и сильнее: любая положительная функция может стать PDF, если захочет — для этого ее надо всего лишь умножить на число, которое заставит ее интегрироваться в единицу. Например:
Допустим, есть функция \(g(x) = ax^2\), определенная на интервале \(x \in [0, 2]\). Чему должно быть равно \(a\), чтобы \(ax^2\) могла стать PDF?
\[\begin{align*} \int_{\Omega} g(x) dx & = 1 \\ \int_{0}^{2} ax^2 dx & = 1 \\ a*\frac{x^3}{3}\bigg|_{0}^{2} & = 1 \\ a & = \frac{3}{8} \end{align*}\]
Непрерывное равномерное распределение
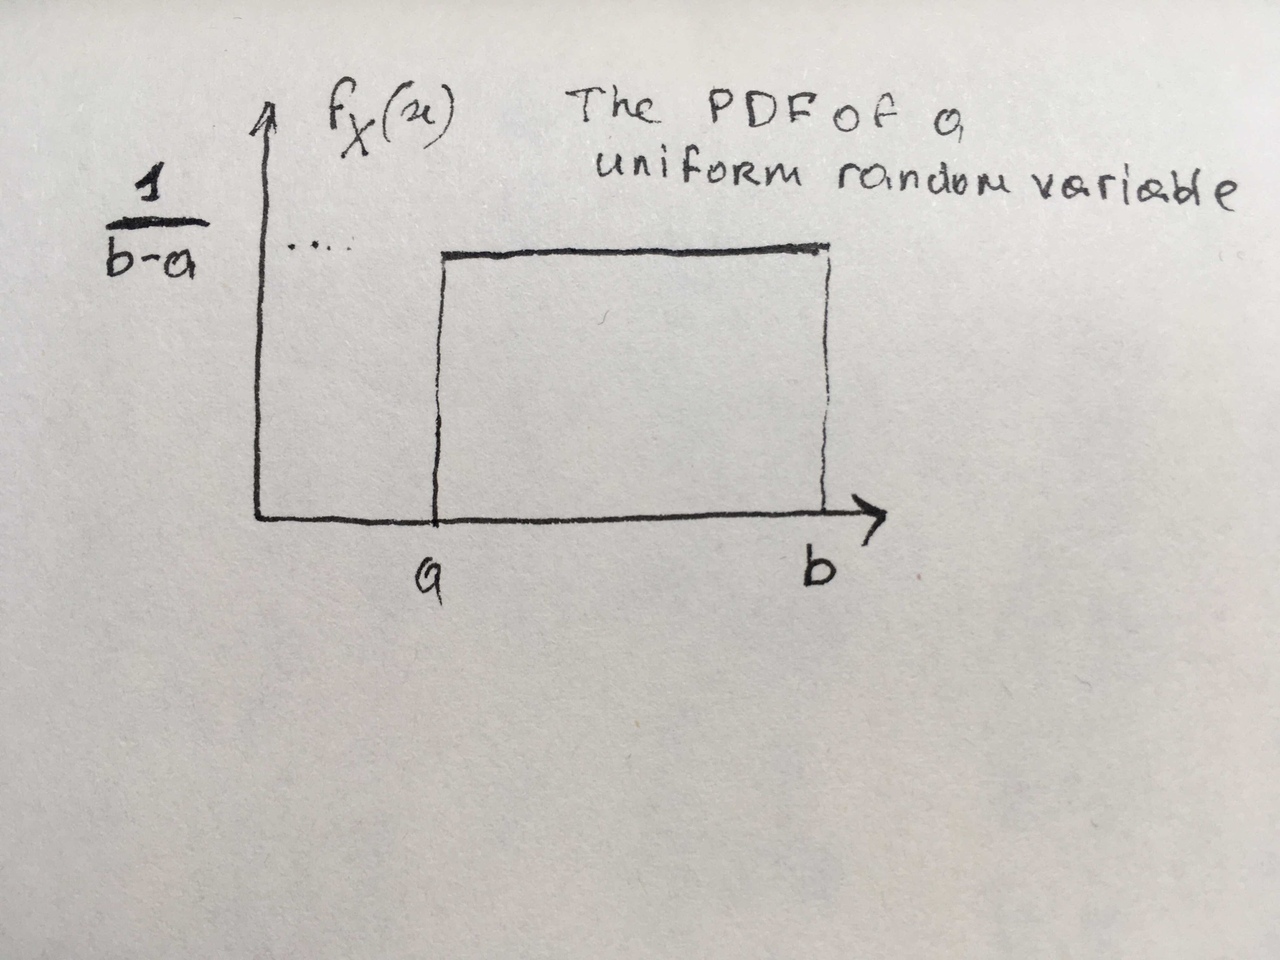
Простейшая иллюстрация того, как выглядит PDF, — непрерывная равномерная случайная переменная: каждый исход равновероятен, а значит, и плотность должна быть распределена равномерно — просто горизонтальная линия над интервалом.
- \(X\) принимает значения на интервале \([a,b]\), и все суб-интервалы одинаковой длины имеют одинаковую вероятность
- \(f_X(x) = \frac{1}{b-a}, \textrm{ если } a \leq x \leq b; \ 0 \textrm{ иначе}\)
\[\int_a^{b}f_X(x) = \int_a^{b}\frac{1}{b-a}dx = 1\]
Ожидание и дисперсия непрерывной переменной
Для непрерывных случайных переменных действуют те же правила, что и для дискретных: мы хотим посчитать ожидание и дисперсию. Чисто технически мы просто переходим от суммирования к интегралам — все остальное остается тем же самым. Под интегралом стоит знакомая конструкция: значение переменной, умноженное на значение функции плотности (сравните с \(\sum x p_X(x)\) из главы про дискретные переменные).
- Формальное определение
\[ E[X] = \int_{-\infty}^{\infty}xf_X(x)dx \]
- Посчитаем для равномерной С.П. \(X \sim U[a, b], E[X] = ?\)
\[ E[X] = \int_{a}^{b}\frac{x}{b-a}dx = \frac{x^2}{2(b-a)}\bigg|_a^b = \frac{a+b}{2} \]
Результат интуитивен: центр равномерного распределения — ровно середина интервала.
Дисперсия
Определение дисперсии то же самое, что и для дискретных переменных: это матожидание квадрата отклонения переменной от своего же ожидания.
\[ var(X) = E[(X - E[X])^2] \]
Что фактически значит
\[ var(X) = \int_{-\infty}^{\infty} (x - E[X])^2f_X(x)dx \]
Но есть и формула попроще (мы выводили ее в главе про дискретные переменные — она работает и здесь):
\[ var(X) = E[X^2] - E[X]^2 \]
Ожидание, как правило, уже известно. Немного сложнее посчитать ожидание квадрата:
\[ E[X^2] = \int_{-\infty}^{\infty}x^2f_X(x)dx \]
Давайте посчитаем дисперсию равномерной С.П. на интервале \([a, b]\):
\[ X \sim U[a, b]: f_X(x) = \frac{1}{b-a} \]
Ожидание
\[ E[X] = \frac{b+a}{2} \]
Ожидание квадрата:
\[\begin{align*} E[X^2] & = \int_{-\infty}^{\infty}x^2f_X(x)dx \\ & = \int_{a}^{b}x^2\frac{1}{b-a}dx \\ & = \frac{x^3}{3}\frac{1}{b-a}\bigg|_{a}^{b} \\ & = \frac{b^3 - a^3}{3(b-a)} \end{align*}\]
Теперь дисперсия:
\[\begin{align*} var(X) & = E[X^2] - E[X]^2 \\ & = \frac{b^3 - a^3}{3(b-a)} - \frac{(b+a)^2}{4} \\ & = \frac{b^2 + ba + a^2}{3} - \frac{(b+a)^2}{4} \\ & = \frac{4b^2 + 4ba + 4a^2 - 3b^2 - 6ba - 3a^2}{12} \\ & = \frac{b^2 - 2ba + a^2}{12} \\ var(X) & = \frac{(b-a)^2}{12} \end{align*}\]
Кумулятивная функция распределения (CDF)
И последняя вещь, которая нам понадобится, — кумулятивная функция распределения. Проблема в том, что дискретный мир и непрерывный мир живут немного по разным законам: в одном работает PMF, в другом — PDF.
- Мы работали с дискретными и непрерывными случайными величинами, используя различные функции:
- дискретная: функция вероятности (PMF), которая показывает, насколько велика вероятность того или иного значения
- непрерывная: функция плотности вероятности (PDF), которая говорит о плотности вероятности в точке
- Было бы неплохо иметь единое математическое понятие, позволяющее говорить как о дискретных, так и о непрерывных случайных величинах
Собственно, математики до этого додумались. Введем функцию \(F_X\), которая будет говорить всего лишь одно: какова вероятность того, что \(X\) меньше определенного заданного значения. Такая функция прекрасно работает в обоих мирах: в дискретном это просто сумма вероятностей всех значений, которые меньше \(x\), а в непрерывном — интеграл от минус бесконечности до \(x\) по функции плотности.
- Познакомьтесь с CDF - кумулятивной функцией распределения
\[\begin{align*} F_X(x) = P(X \leq x) \\ \textrm{если X дискретна: } F_X(x) = P(X \leq x) = \sum_{k\leq x}p_X(k) \\ \textrm{если X непрерывна: } F_X(x) = P(X \leq x) = \int_{-\infty}^{x}f_X(t)dt \end{align*}\]
Интуитивно это очень простая функция. Представьте, что вы идете под распределением — над вами горы вероятности. Вы стартуете с минус бесконечности и по ходу собираете вероятность себе в корзину. Кумулятивная функция говорит: остановитесь в точке \(x\) и скажите, сколько вероятности вы набрали к этой точке.
- CDF - \(F_X(x)\) - показывает, сколько вероятности вы накопили вплоть до значения \(x\)
- Любая случайная величина имеет CDF, неважно, дискретна она или непрерывна. Событие \(\{X\leq x\}\) всегда имеет определенную вероятность (в отличие от \(X = x\))
- Например, положим, что у нас есть равномерная случайная переменная. Найдем ее CDF.
- Т.е. \(X \sim Uni(a, b), F_X(x) = ?\)
- Следуя определению, получаем
\[ F_X(x) = \int_{a}^{x}\frac{1}{b-a}dt = \frac{t}{b-a}\bigg|_{a}^{x} = \frac{x-a}{b-a} = \frac{1}{b-a}x - \frac{a}{b-a} \]
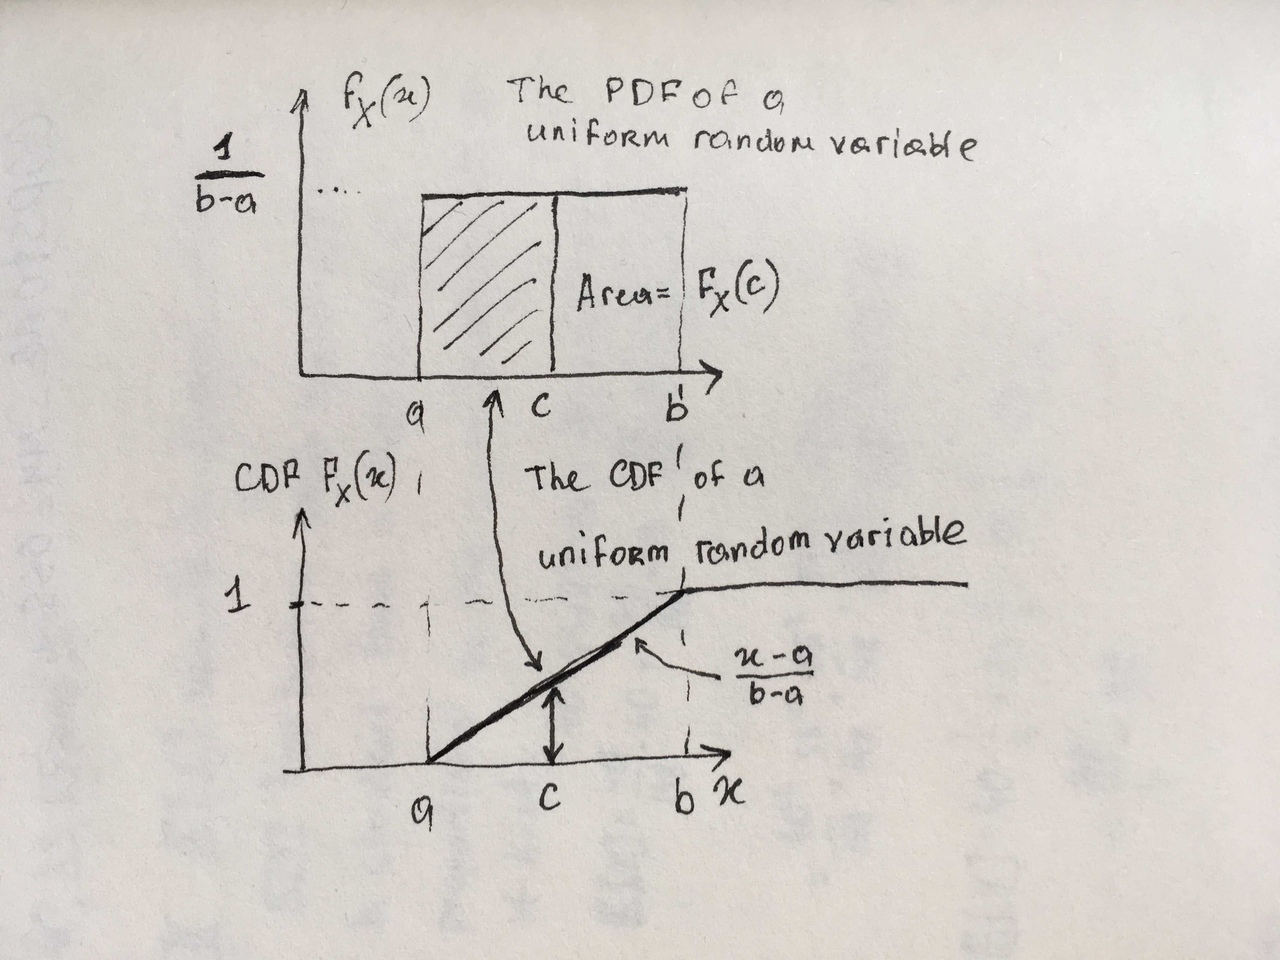
- PDF - \(f_X(x)\) - можно получить из CDF - \(F_X(x)\) - если взять производную
\[ f_X(x) = \frac{dF_X}{dx}(x) \]
То есть CDF — это первообразная от PDF; они, по сути, родитель и ребенок — две ипостаси одного и того же распределения. Это нам не так принципиально нужно, главное помнить определения: CDF показывает, сколько вероятности накопилось до определенной точки, PDF показывает плотность вероятности в отдельной точке.
Нормальное распределение
А теперь перейдем к самому главному персонажу этой части книги.
- Непрерывная С.П. называется нормальной, если ее PDF имеет следующий вид
\[ f_X(x) = \frac{1}{\sigma\sqrt{2\pi}}e^{-(x-\mu)^2/2\sigma^2} \]
Выглядит пугающе и угрожающе — я так же себя ощущал, когда брал свой первый курс по статистике. Мне казалось, что что-то такое используют для вычислений. Не надо использовать это для вычислений. Нужно уметь «парсить» формулу: смотреть на ключевые места и понимать, что из них следует. Давайте распарсим.
Во-первых, от чего зависит эта функция? Только от \(x\) — это единственная вещь, которая варьируется. Значит, множитель \(\frac{1}{\sigma\sqrt{2\pi}}\) — константа: \(\pi\) — число, \(2\) — число, \(\sigma\) — параметр, то есть тоже некое фиксированное число. Мы в мире вероятности, и на константы нам, в принципе, плевать — от них всегда можно избавиться перенормировкой. Игнорируем.
Во-вторых, остается экспонента с отрицательным показателем: \(e^{-(\dots)}\). Вспомним, как ведет себя такая функция: \(e^{-y} = 1/e^{y}\), поэтому чем больше показатель, тем ближе значение к нулю. Показатель \((x-\mu)^2/2\sigma^2\) велик, когда \(x\) далеко от \(\mu\) — в обе стороны, ведь разность стоит в квадрате. А минимален он (равен нулю), когда \(x = \mu\): в этой точке экспонента равна единице — это пик. Отсюда и берется знаменитая колоколообразная форма: максимум в точке \(\mu\), быстрое симметричное угасание по краям.
Наконец, \(\sigma\) в знаменателе показателя контролирует скорость угасания: если \(\sigma\) большая, угасание медленное и хвосты тяжелые; если маленькая — угасание быстрое, все значения скучены вокруг центра.
- Нормальное распределение определяется двумя параметрами, \(\mu\) и \(\sigma\)
- \(\mu\) задает центр распределения
- \(\sigma\) задает стандартное отклонение (standard deviation), которое определяет то, насколько разбросаны значения вокруг среднего
- Записывается как \(X \sim N(\mu, \sigma)\)
- \(E[X] = \mu\) — ожидание нормальной случайной переменной равно параметру \(\mu\)
- \(Var(X) = \sigma^2\) — а дисперсия равна квадрату параметра \(\sigma\)
(Кстати, для всех симметричных распределений матожидание совпадает с модой — пиком; для несимметричных это не так.)
Нормальное семейство
Посмотрим, как функция плотности нормального распределения зависит от сочетания параметров.
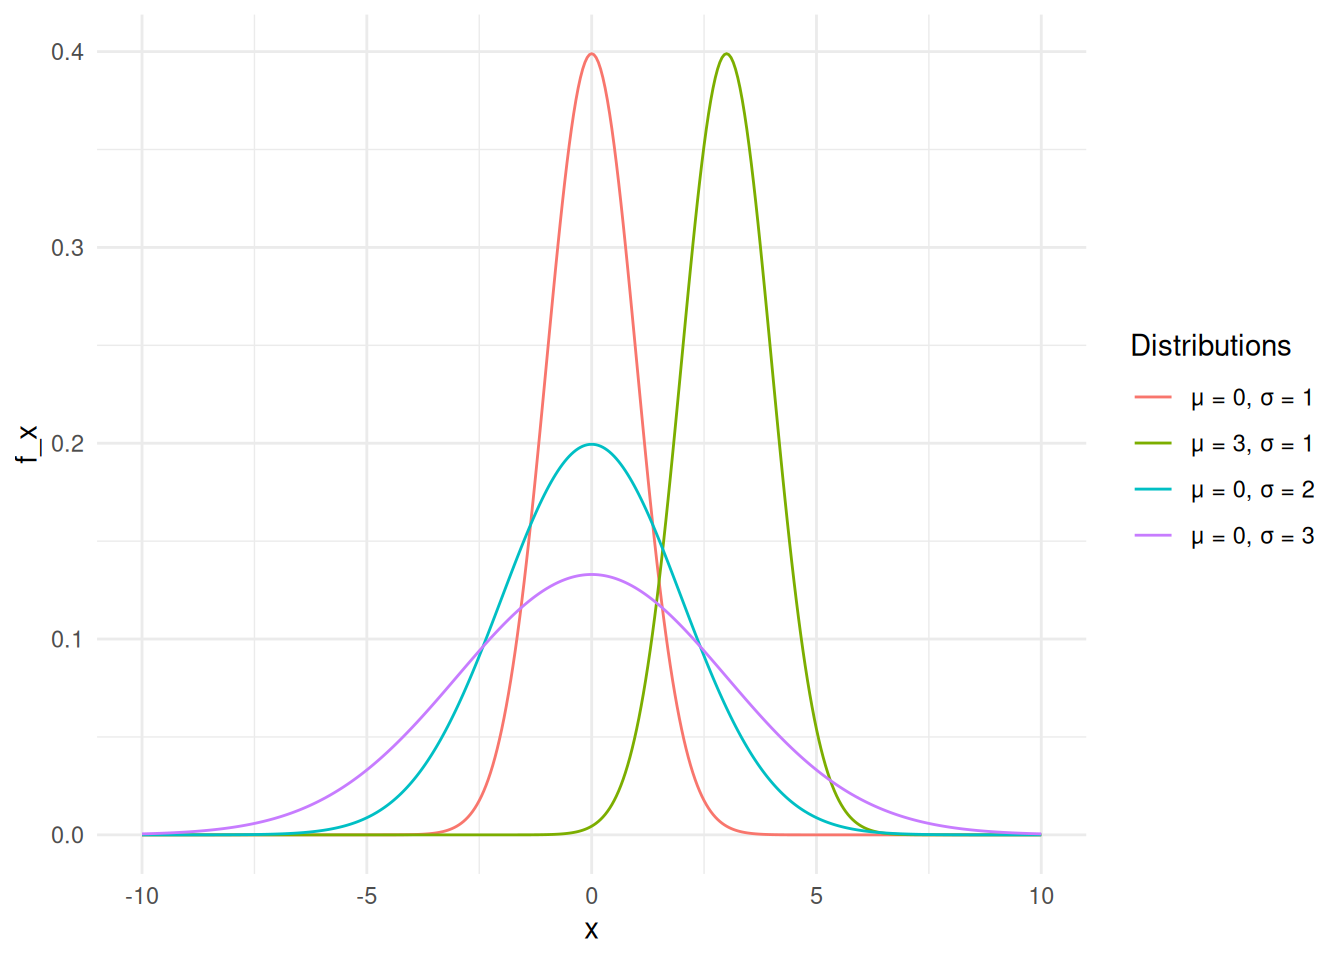
Красная линия — центр в 0, \(\sigma = 1\). У зеленой \(\mu = 3\): распределение просто сместилось на 3 единицы вправо, форма не изменилась. У бирюзовой \(\sigma\) увеличена в два раза — распределение «расползлось». Теперь вспомните: плотность — это что-то пропорциональное вероятности, и сравните значение 5 для разных кривых. Для красного распределения вероятность встретить пятерку фактически равна нулю. Для бирюзового — пятерка все еще маловероятна, но уже может произойти: понаблюдав тысячу раз, вы, может быть, увидите ее 3–4 раза. А для фиолетовой (\(\sigma = 3\)) пятерка — вполне обычный результат: не самый частый, но и совсем не редкий. В этом и смысл \(\sigma\): она показывает, насколько далеко конкретные значения могут уходить от центра.
Немного R
Последний нюанс — небольшой кроссовер с R. К счастью, ничего из этого не нужно считать вручную. Если бы мы захотели посчитать вероятность того, что стандартная нормальная переменная меньше нуля, нам пришлось бы брать вот этот интеграл — абсолютно неприятный товарищ:
\[F_X(0) = P(X \leq 0) = \int_{-\infty}^{0}\frac{1}{\sqrt{2\pi}\sigma}e^{-(x-\mu)^2/2\sigma^2}dx\]
Интуитивно, конечно, можно заметить, что речь о площади под кривой левее нуля, а поскольку распределение симметрично, она равна \(1/2\). Но в общем случае пришлось бы интегрировать. В R для этого есть целое семейство функций с общим корнем norm и префиксом, который уточняет, что именно делает функция: dnorm(), pnorm(), qnorm(), rnorm().
dnorm()
dnorm() принимает на вход значение переменной, а возвращает значение плотности вероятности в этой точке (d — density). Дополнительно нужно указать параметры распределения — центр и стандартное отклонение, — чтобы R понимал, о каком именно нормальном распределении речь. Сколько точек подадите на вход, столько значений плотности получите в ответ.
dnorm(x = c(1, 0, 1), mean = 0, sd = 1)[1] 0.2419707 0.3989423 0.2419707Сами по себе значения плотности не интерпретируются, но их можно сравнивать: чем выше плотность вокруг значения, тем чаще будут появляться наблюдения из его окрестностей. А еще dnorm() удобно использовать для построения графиков плотности: я прохожу по значениям от \(-3\) до \(3\) с шагом 0.05 и для каждого считаю плотность.
my_tibble <-
  tibble(x = seq(-3, 3, by = 0.05)) %>% # вектор значений
  mutate(y = dnorm(x)) # значения PDF для каждой точки
my_tibble %>% head()| x | y |
|---|---|
| -3.00 | 0.0044318 |
| -2.95 | 0.0051426 |
| -2.90 | 0.0059525 |
| -2.85 | 0.0068728 |
| -2.80 | 0.0079155 |
| -2.75 | 0.0090936 |
И потом
my_tibble %>%
  ggplot(aes(x = x, y = y)) +
  geom_line() +
  labs(title = "PDF of a normal distribution") +
  annotate('text', x = 0, y = 0.41,
        label = "mu==0~sigma==1", parse = TRUE, size = 5)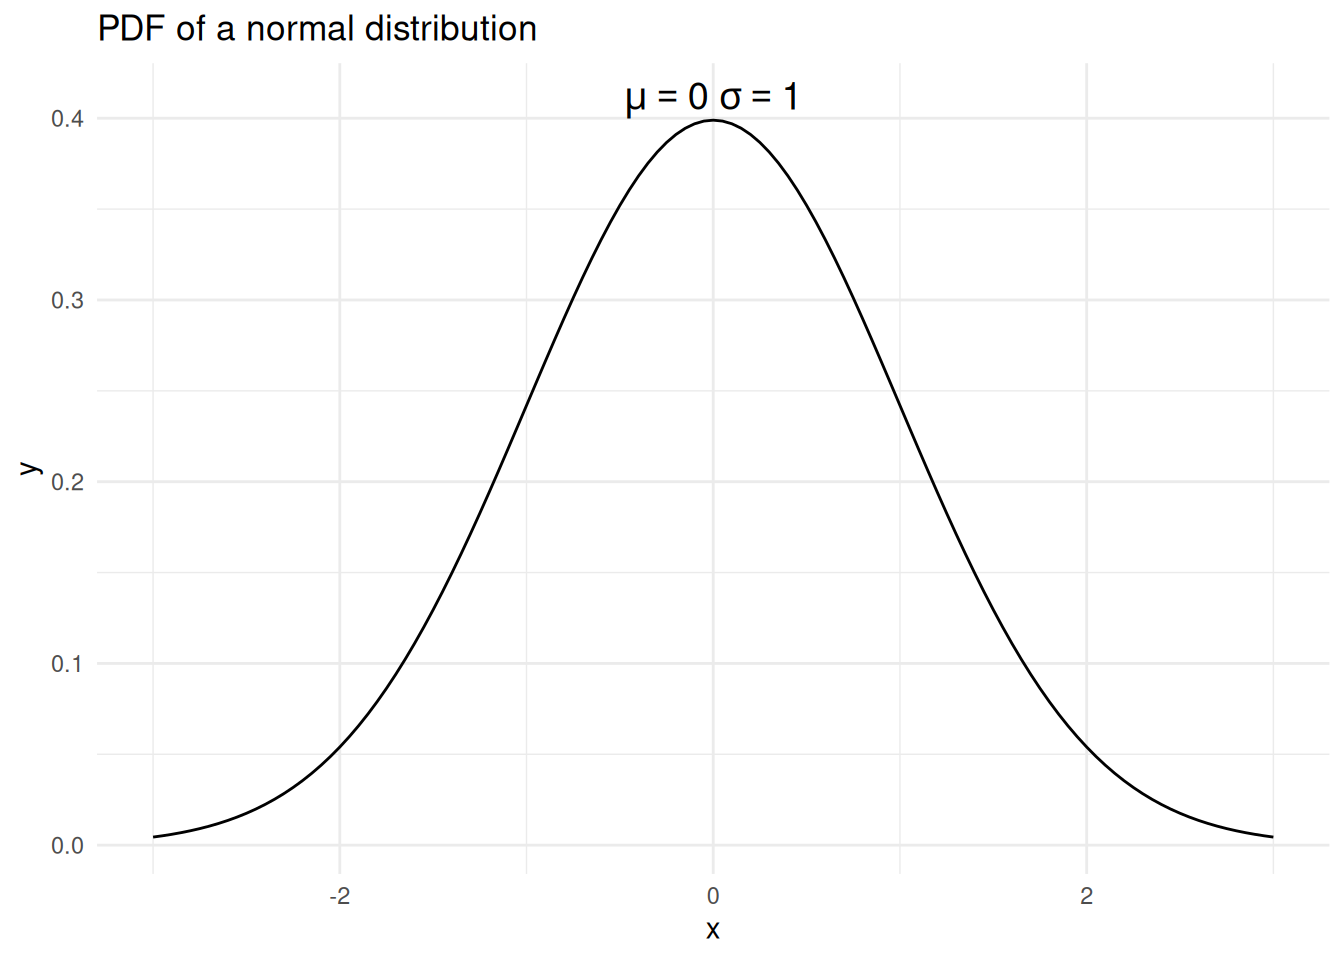
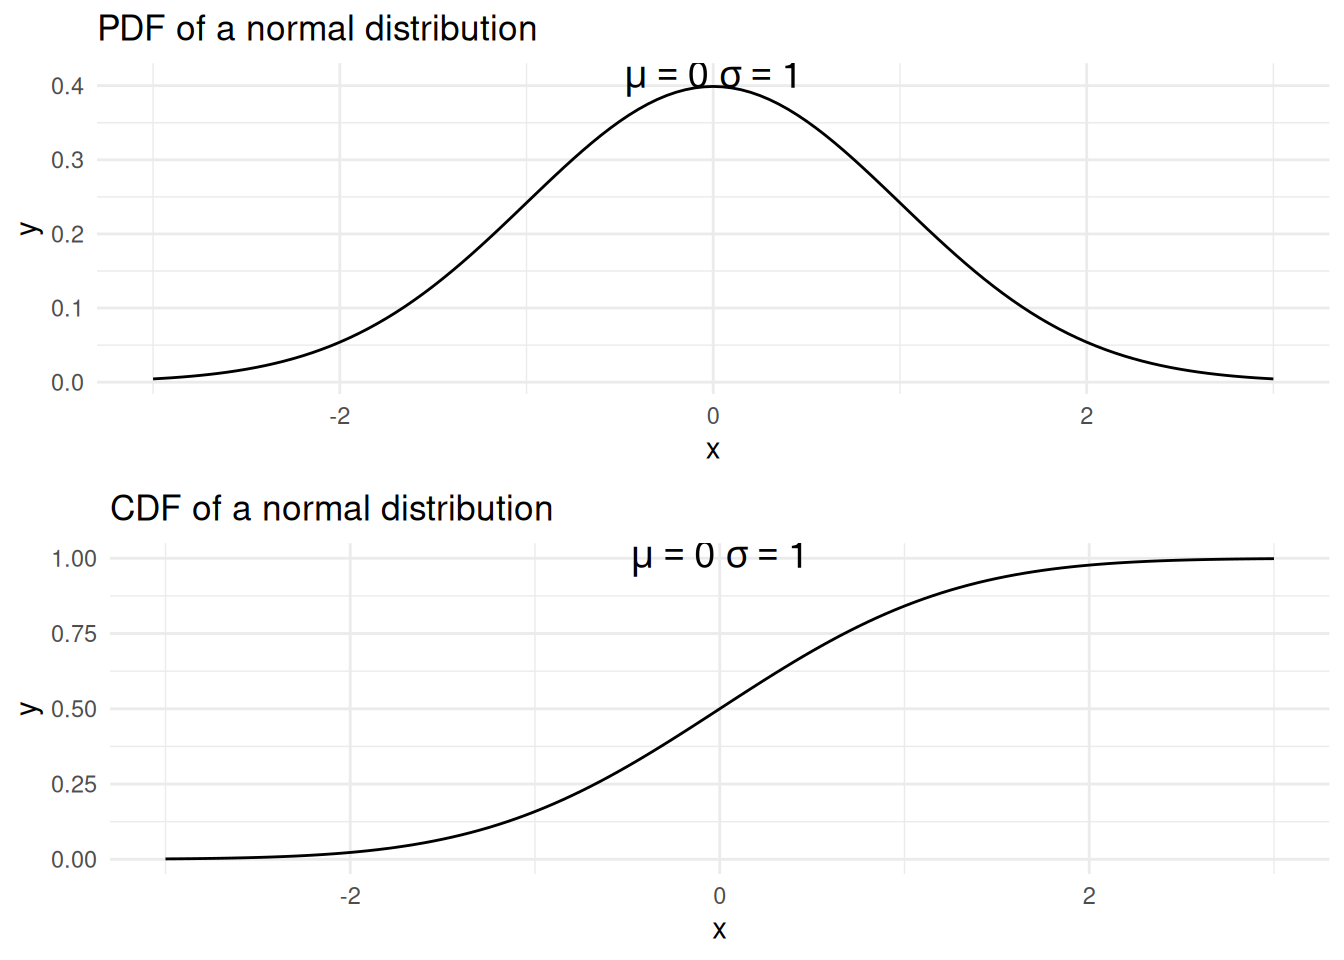
Получилась знакомая колоколообразная форма.
pnorm()
pnorm()- это CDF нормального распределения (p — probability). На вход функция принимает значение переменной, а выдает то, сколько “вероятности” вы “накопили” к этой точке
# Какова вероятность, что стандартная нормальная с.п.
# (mean = 0, sd = 1) примет значение меньше чем 0
pnorm(0, mean = 0, sd = 1)
[1] 0.5R подтверждает наши рассуждения о симметрии: 50%. Быстрый тест на понимание: чему равно значение CDF на плюс бесконечности? Единице — вы не можете собрать больше вероятности, чем распределили изначально.
- По умолчанию,
pnorm()считает вероятность, что переменная будет меньше заданного значения: \(P(X \leq x)\). Если вы хотите найти вероятность, что переменная будет больше заданного значения, просто вычтите значение по умолчанию из 1 (два события — дополнения друг друга):
\[ P(X > x) = 1 - P(X \leq x) \]
Пример
Какова вероятность, что нормальная с.п. со средним \(10\) и стандартным отклонением \(2\) примет значение больше чем \(15\)?
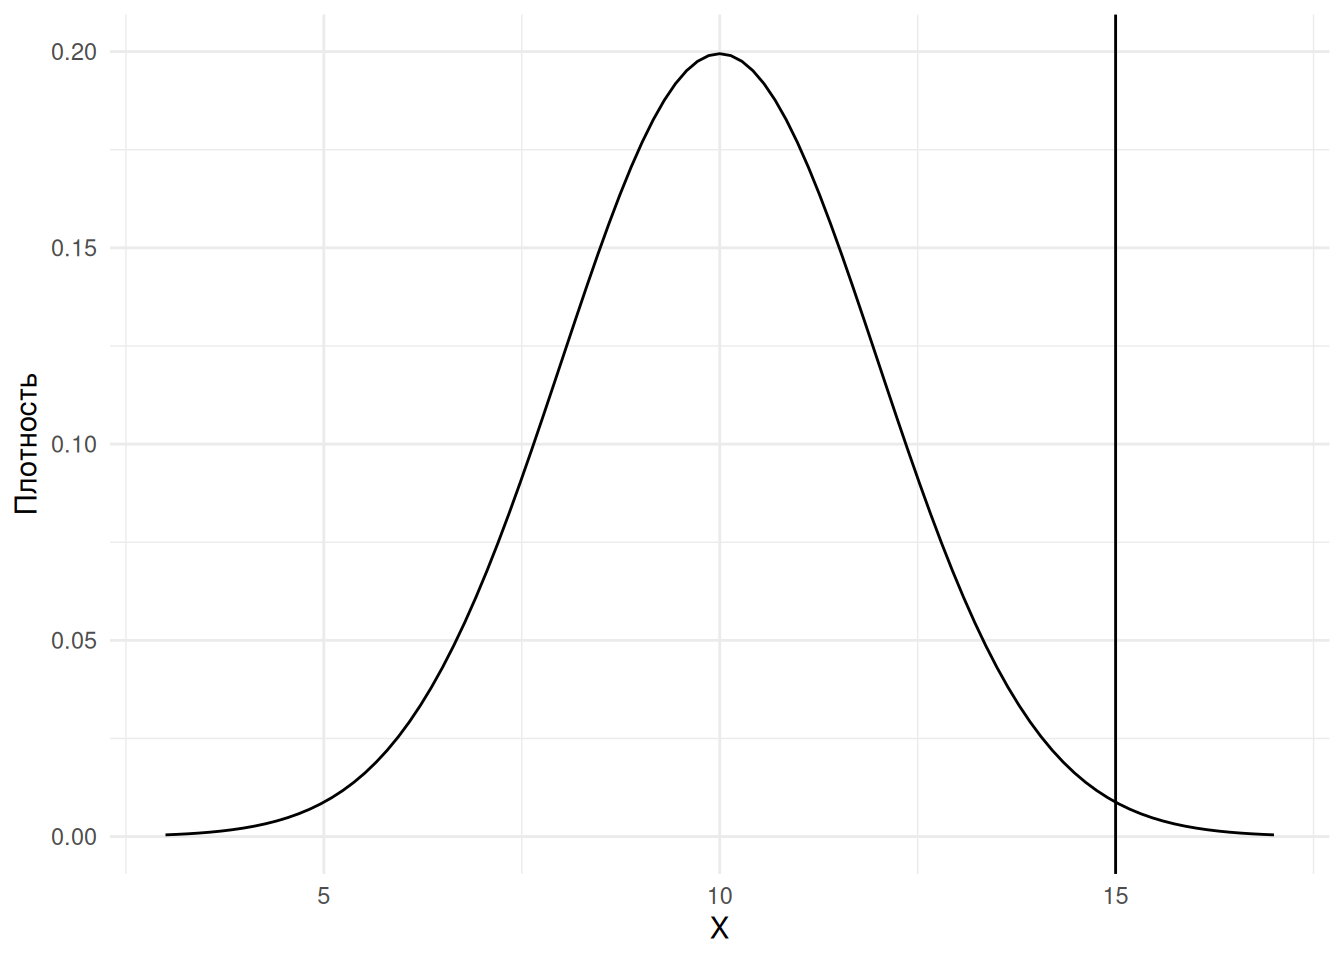
1 - pnorm(15, mean = 10, sd = 2)[1] 0.006209665Меньше одного процента. Теперь то же самое, но графически. Сначала PDF: вероятность события \(X > 15\) — это площадь под кривой правее вертикальной линии, и видно, что она крошечная.
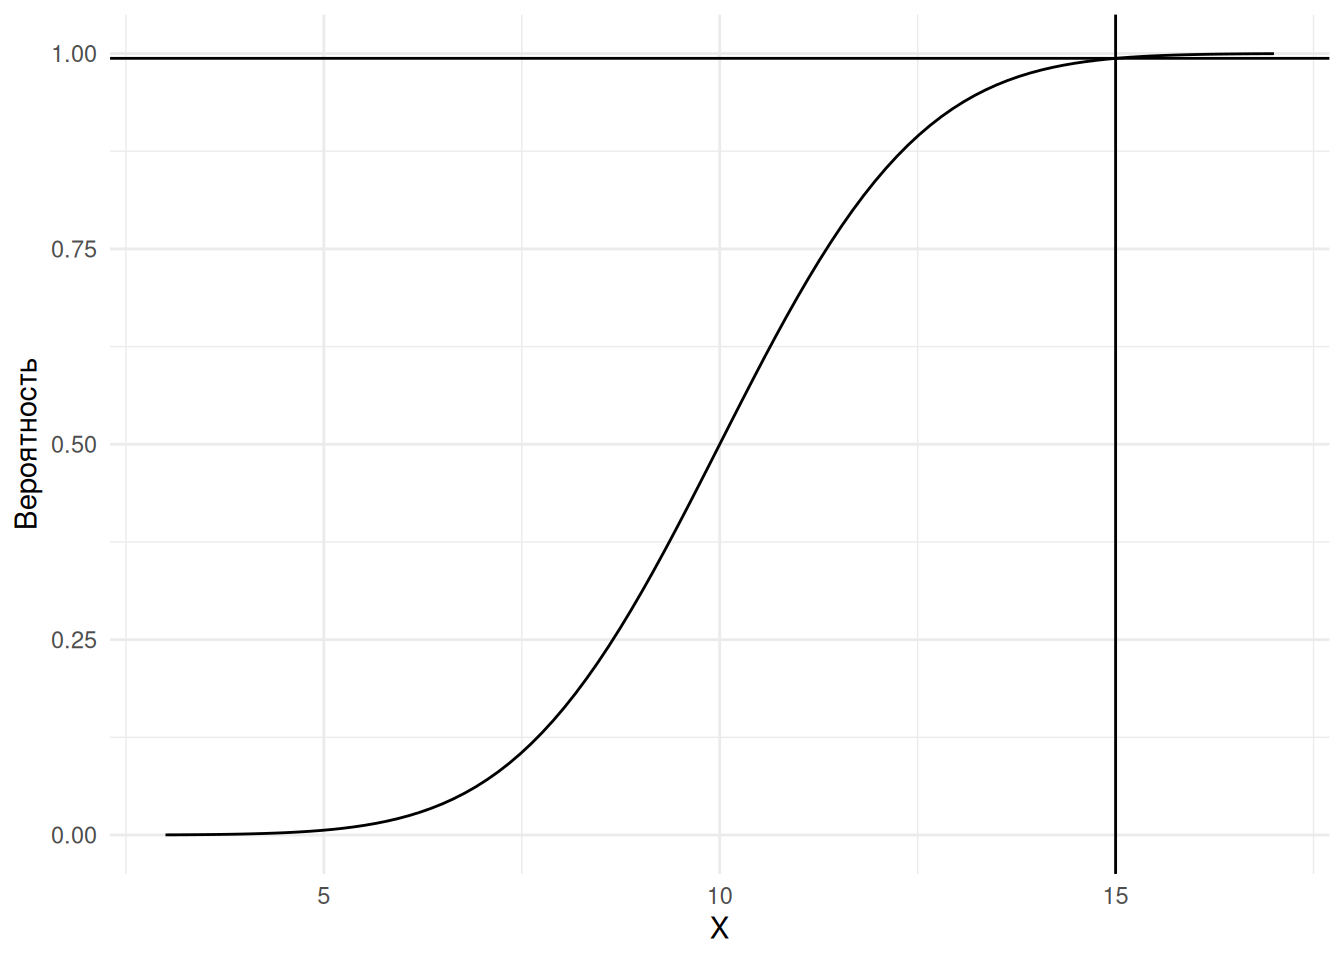
- Теперь CDF: к точке 15 накоплена почти вся вероятность
qnorm()
qnorm() — функция, обратная кумулятивной (q — quantile). Она считает квантили: точки, которые делят распределение в заданных пропорциях. На вход вы подаете пропорцию — вероятность того, что переменная будет меньше искомого значения, — а на выходе получаете само значение:
\[ qnorm(p) = x: P(X \leq x) = p \]
- До какой точки нужно дойти, чтобы собрать ровно половину стандартного нормального распределения?
qnorm(0.5, mean = 0, sd = 1)[1] 0- А где находится точка, ниже которой лежит 25% распределения (первый квартиль)?
qnorm(0.25, mean = 0, sd = 1)[1] -0.6744898- Где находится точка, которую случайная переменная превышает только в 5% случаев?
# по умолчанию qnorm() отсчитывает вероятность снизу;
# чтобы отсчитывать сверху, используем lower.tail = FALSE
qnorm(0.05, mean = 0, sd = 1, lower.tail = FALSE)
[1] 1.644854Зачем это нужно на практике? Вернитесь к примеру с анализами. Вы врач и хотите понять, где находится та критическая точка уровня сахара, после которой стоит начать беспокоиться. Вы решаете для себя: если у пациента значение, которое встречается реже, чем у 5% людей с похожими характеристиками, — отправляю к профильному специалисту. qnorm() как раз возвращает такую пороговую точку: значение на 1.64 стандартных отклонения выше среднего — это уже редкий случай, который заслуживает пристального внимания.
rnorm()
rnorm()генерирует нужное количество наблюдений за нормальной случайной переменной с заданными параметрами (r — random).
my_random_values <- rnorm(10, mean = 0, sd = 1)
my_random_values
[1] -0.61034806 0.26004585 0.58743967 1.36358344 0.20176716 1.47487565
[7] 0.71619258 -0.17943450 1.13796393 -0.01266233Другой способ интерпретировать этот код: вы понаблюдали за случайной переменной 10 раз и зафиксировали значения, которые она приняла. Что получили, то получили. Сравните пару значений из этого вектора: которое из них было более вероятным? То, что ближе к центру, — зафиксируйте у себя в голове эту интуицию, мы будем пользоваться ею очень много. Для нормального распределения расстояние от центра всегда однозначно конвертируется в вероятность: чем дальше от центра, тем меньше вероятность.
- Давайте сгенерируем много значений и построим на них гистограмму
tibble(sim_values = rnorm(1000, mean = 0, sd = 1)) %>%
  ggplot(aes(x = sim_values)) +
  geom_histogram(bins = 30, color = "grey")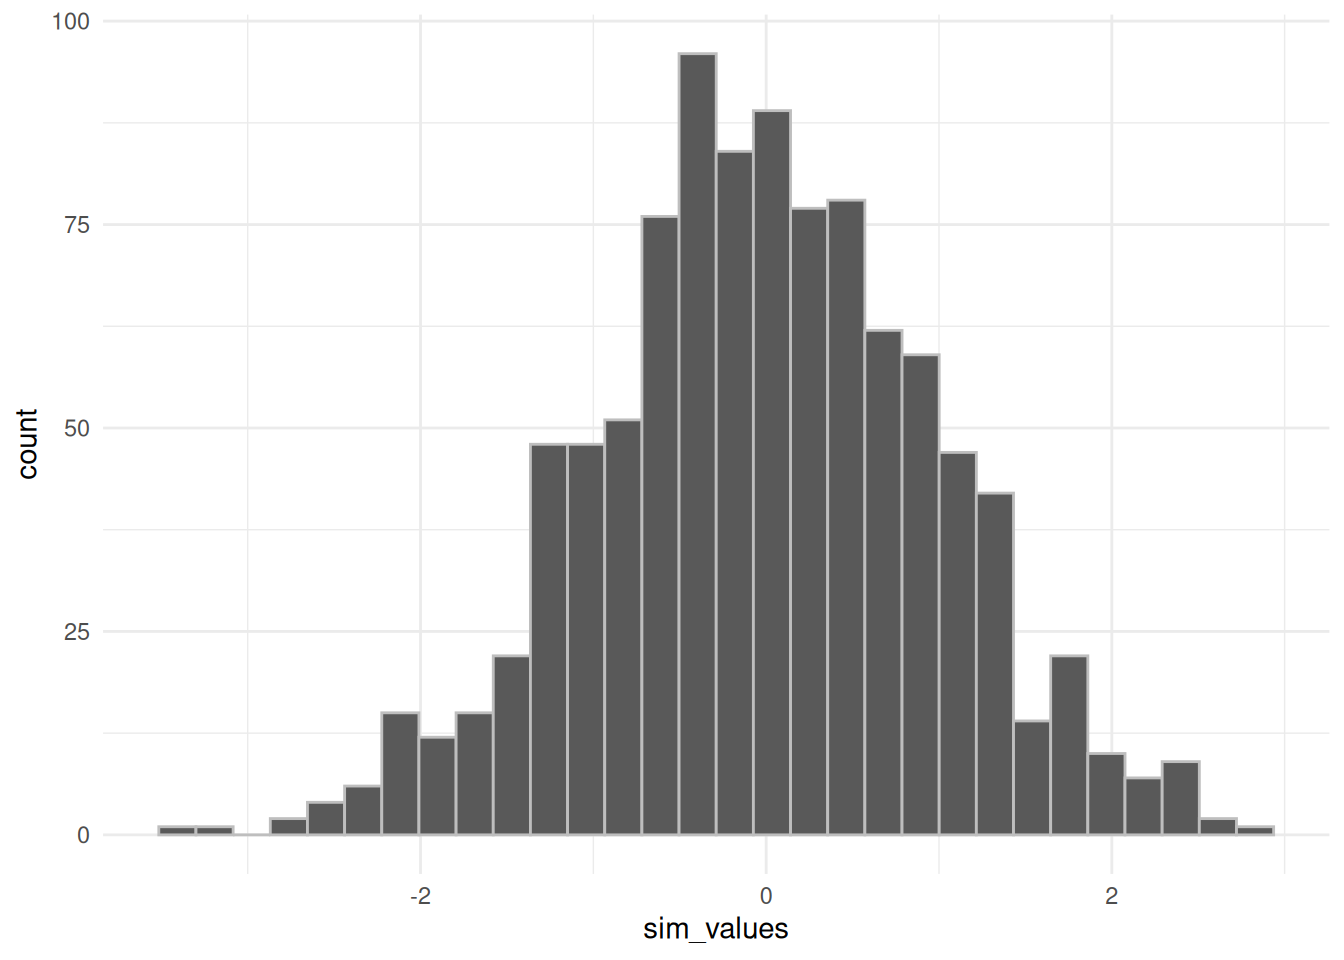
Выглядит нормально (во всех смыслах). Теперь добавим эмпирическую функцию плотности (голубая линия — приближение, которое R строит по имеющимся наблюдениям) и сравним ее с теоретической плотностью (бордовая линия):
tibble(sim_values = rnorm(1000, mean = 0, sd = 1)) %>%
  ggplot(aes(x = sim_values)) +
  geom_histogram(bins = 30, color = "grey", aes(y = ..count../sum(..count..))) +
  geom_density(color = "skyblue2") +
  geom_line(data = my_tibble, aes(x = x, y = y), color = "maroon4") +
  labs(y = "Пропорция")
Warning: The dot-dot notation (`..count..`) was deprecated in ggplot2 3.4.0.
ℹ Please use `after_stat(count)` instead.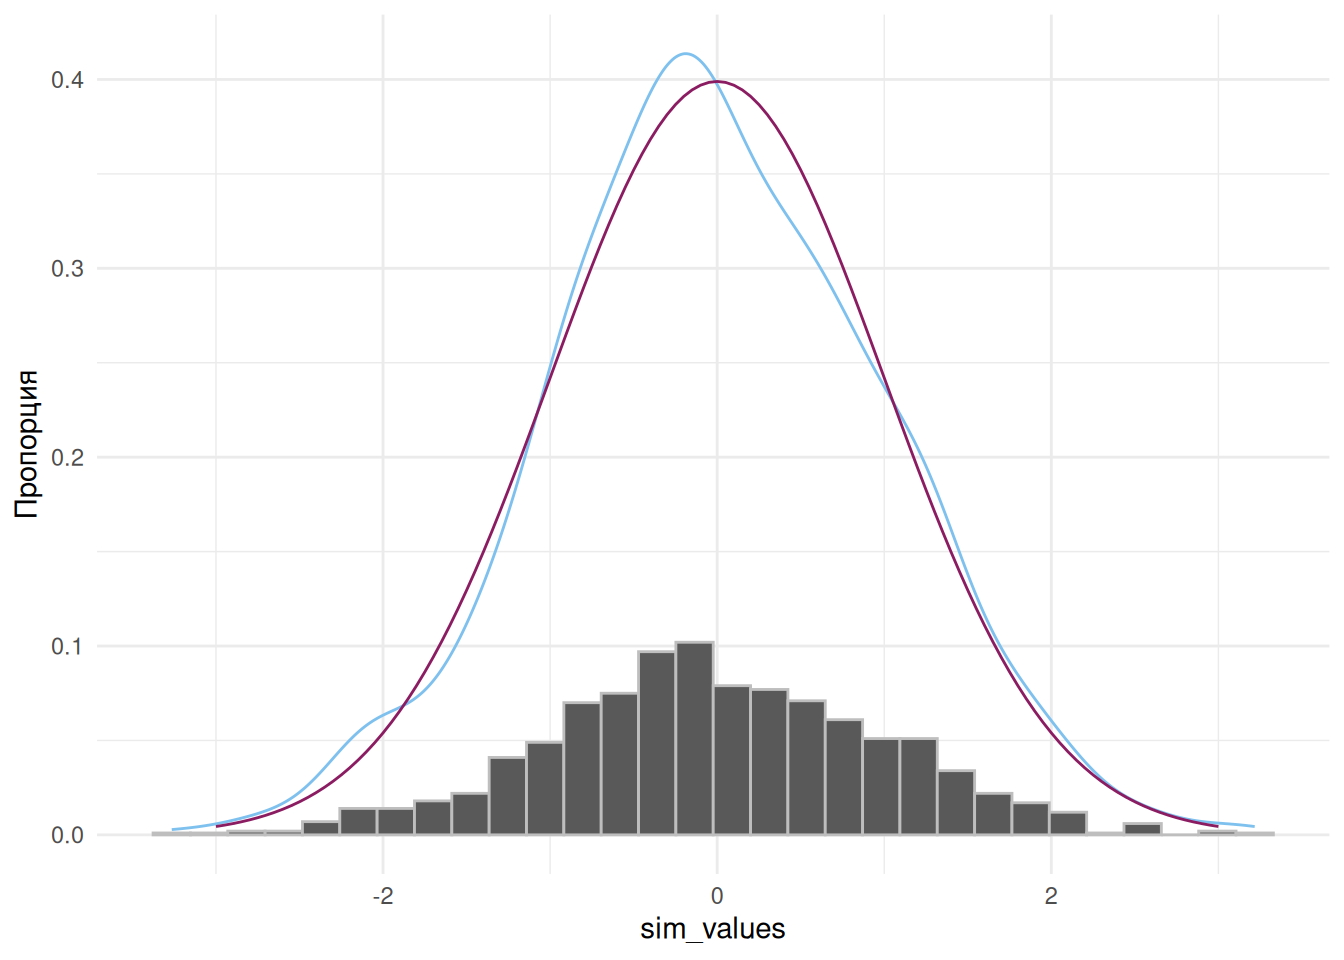
Между эмпирикой и теорией всегда есть небольшое расхождение — мы живем в мире статистики, в мире неопределенности, и такие различия нормальны. Но если бы мы увеличивали число наблюдений — десять тысяч, сто тысяч, миллион — голубая линия все больше походила бы на бордовую. Это то, что в теории вероятности называется сходимостью по распределению.
Так это работает и на практике, только в обратную сторону: вы не знаете, откуда на самом деле пришли ваши данные, но видите распределение, похожее на нормальное, и делаете допущение — «пусть моя переменная распределена нормально». После этого остается оценить по данным два параметра, \(\mu\) и \(\sigma\), — и у вас есть полная вероятностная модель.
К чему я так расхваливаю нормальное распределение? Оно само по себе, как будто из ниоткуда, возникает в очень разных, практически не связанных между собой областях — математике, физике, социальных науках — как один из ключевых организационных принципов природы. Почему так происходит и что это дает статистике — тема следующей главы. Спойлер: у нас все распределено нормально. Продолжение следует…